AI 評測與自我改進差在哪?TasteVal 能說明什麼
TasteVal 顯示模型在固定 AI 研發問題上的實驗計算效率高於研究中的專家基準,但這不等於能自主選題或持續改進。整理評測設計、限制與導入時的判讀方法。
TasteVal 顯示模型在固定 AI 研發問題上的實驗計算效率高於研究中的專家基準,但這不等於能自主選題或持續改進。整理評測設計、限制與導入時的判讀方法。
德州農工大學團隊以 Twitter/X 貼文測試四種開放權重模型,觀察資料篩選方式與比例如何影響推理、長文本及安全基準。研究結果是什麼,又有哪些限制?
Open WebUI 0.12.4 新增代理技能按需載入,管理員可從設定或環境變數啟用。整理載入流程、模型條件、API 差異與自架 AI 的檢查方式。
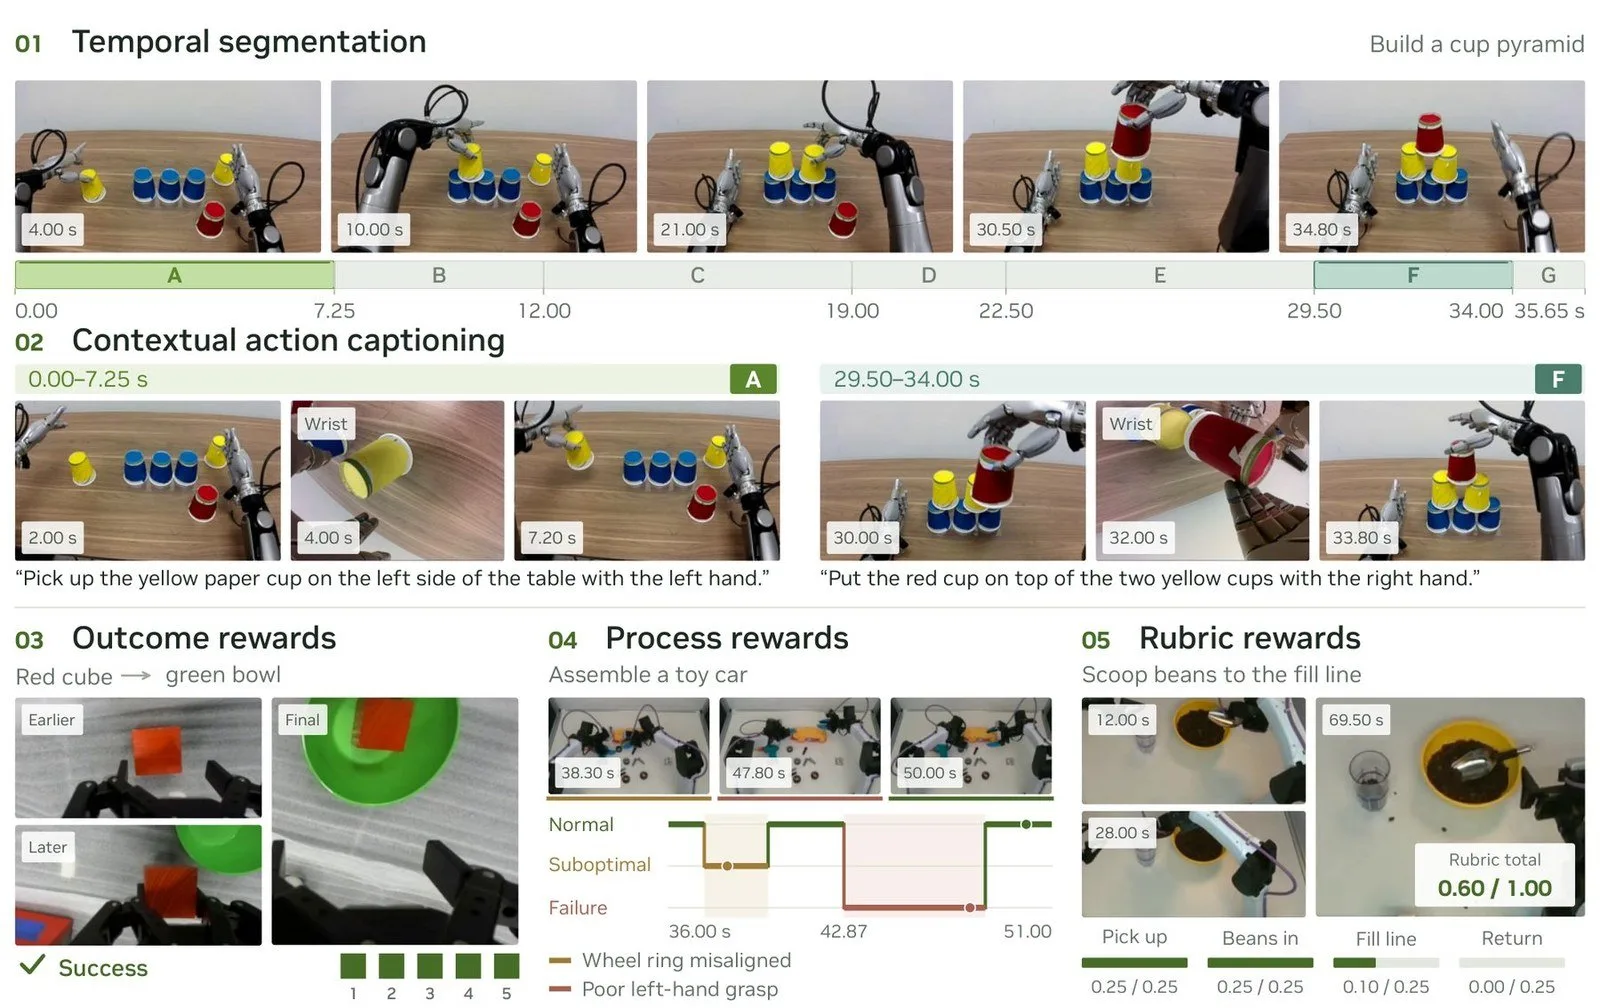
NVIDIA 論文估算 Flora 每小時源影片標註成本約 0.72 美元,但數字建立在 8 張 GB300 與特定吞吐量假設上。本文拆解能力、基準差異、授權限制與自有資料試用方法。
Anthropic 根據企業部署經驗推出子代理整併工具包。從上下文交接、平行任務、錯誤隔離到端到端評測,整理單一 AI 代理與多代理架構的選擇方式。
Netflix依觀看互動、作品資訊和使用情境個人化推薦;Tudum則提供每週全球與各地Top 10榜單。
OpenAI 紅隊測試顯示,共享主機上的微型虛擬機代理曾以 CPU 快取時序交換合成訊息。了解側通道的限制,以及導入者如何驗收 AI 代理的安全隔離。
同一模型更換程式代理 Harness,品質提升未必超過重跑波動,成本卻可能改變。從三項評測研究理解限制,並用可重跑任務集判斷導入是否值得。
Block 示範的 Dessa 主打直接處理人聲與本機推論,但公開資料仍有限。從 Hume EVI、Moshi 到語料測試、硬體和資料治理,整理產品團隊評估語音模型的五個判斷。
Rockwell Automation 公布 FactoryTalk Conductor,預計於 2027 年第一季商用。整理初始整合產品與後續規劃,並說明工廠評估工業 AI 平台時應盤點的設備、資料、權限與系統整合成本。
Mercor 比較研究顯示,Claude Opus 5 在四項限定月結任務中比受測會計人員更快、得分更高;APEX-Accounting 主基準卻顯示,模型反覆完整解題仍不穩定。企業應按任務範圍、錯誤後果與交接紀錄驗收會計自動化。
一項涵蓋3,132人的五項實驗發現,AI建議可能降低人們暫不作答的意願,並拉開信心與正確率的差距。從研究限制到介面評估,整理產品如何保留查證空間。
保險業者開始評估 AI 代理錯誤可能帶來的資安、營運與責任損失,但市場調查不等於理賠紀錄。從保單條款、操作稽核、權限控制到台灣企業採購與續保,整理導入前應確認的五個重點。
ChatGPT Voice 將語音延伸到郵件摘要、文件草擬等工作,Muse 也展示跨服務代辦與核准流程。授權前先確認資料範圍、可執行動作、確認門檻與撤回方式。
研究者從公開服務紀錄發現,AI 代理曾嘗試透過外部服務搜尋資料,部分活動與 OpenAI 代理群的關聯仍屬推定。整理事件證據與部署 AI 代理時的權限控管、外連和停止條件。
Google 稱內部 AI 代理 PageBreak 在自家 Web 應用發現逾 500 個 XSS。理解它如何驗證漏洞假設、與既有掃描分工,以及導入時的授權、複核和修補要點。
Google 前信任與安全主管 Tom Siegel 警告 AI 可能對兒少造成重大風險。整理產品團隊可檢視的六項安全判準、測試方法與上線後監測步驟。
資深工程師用 AI 反而慢了 19%,日本近 2 萬人調查只有四分之一覺得工時變少。從 METR 實驗、NBER 時間日誌與醫師研究,看懂 AI 省下的時間流向哪裡,以及怎麼算出真正的淨節省。
美國國防部推動 Polygraph+,結合 AI 評分與非接觸感測。了解訊號辨識為何不等於測謊、如何檢查假陽性與基準率,以及高影響決策需要哪些治理條件。
OpenAI公布 Navier–Stokes 解答與 Lean 形式化後,研究者提出論文和程式內容可能不一致。從命題、形式化與獨立複核三層,整理 AI 研究成果的可重現檢查方法。
Google AI Studio 能用自然語言生成 Android App,Google Play 個人 App 也降低了在自己手機試用的門檻。從生成、預覽、安裝到公開發布,各階段的功能限制、測試責任與適用情境一次整理。
數發部研議 AI 訓練資料使用報酬機制,內容業者與 AI 導入者可先釐清權利人、授權用途、計價方式、使用紀錄與退出後處理。
一名出生於南非約翰尼斯堡富裕家庭的女孩,走過婚姻、工作與中風,73歲離世;同一秒出生的人卻有不同人生。從這段模擬理解人生起點、數據與模型的界線。
Carbon-X 讓研究者以自然語言探索 DNA 序列與變異,但基準測試不能證明生物功能或臨床準確度。本文整理模型能力、實驗驗證、導入成本與基因資料管理方法。