AI代理可靠度怎麼比?別只看一次成功
AI代理第一次完成任務,不代表能穩定交付。從 Mean@k、Pass^k、泛化能力與人類監督,建立數位健康流程的可靠度評測方法。
科技
AI代理第一次完成任務,不代表能穩定交付。從 Mean@k、Pass^k、泛化能力與人類監督,建立數位健康流程的可靠度評測方法。
Claude Code 2.1.271至2.1.273更新了什麼?整理遠端快速模式、代理標記、MCP、權限與可靠度修正,依個人、團隊與自託管環境提供升級判斷與測試清單。
長篇假訊息會透過重複、誘導與假引用污染上下文。本文拆解GPT-6 Astra與Claude的證據差異,說明醫療衛教與台灣內容查證如何保留人工覆核。
混合推論不等於資料零外傳。從 Perplexity、純雲端助理與 Ollama 本機部署的資料流、隱私、能力、網路、成本及臺灣個資責任,整理實際選擇方法。
NVIDIA、Perplexity與llama.cpp帶動本地AI新一波發展。從能力、硬體、成本、隱私與台灣可用性比較本地AI和雲端助理,找出適合自己的使用方式。
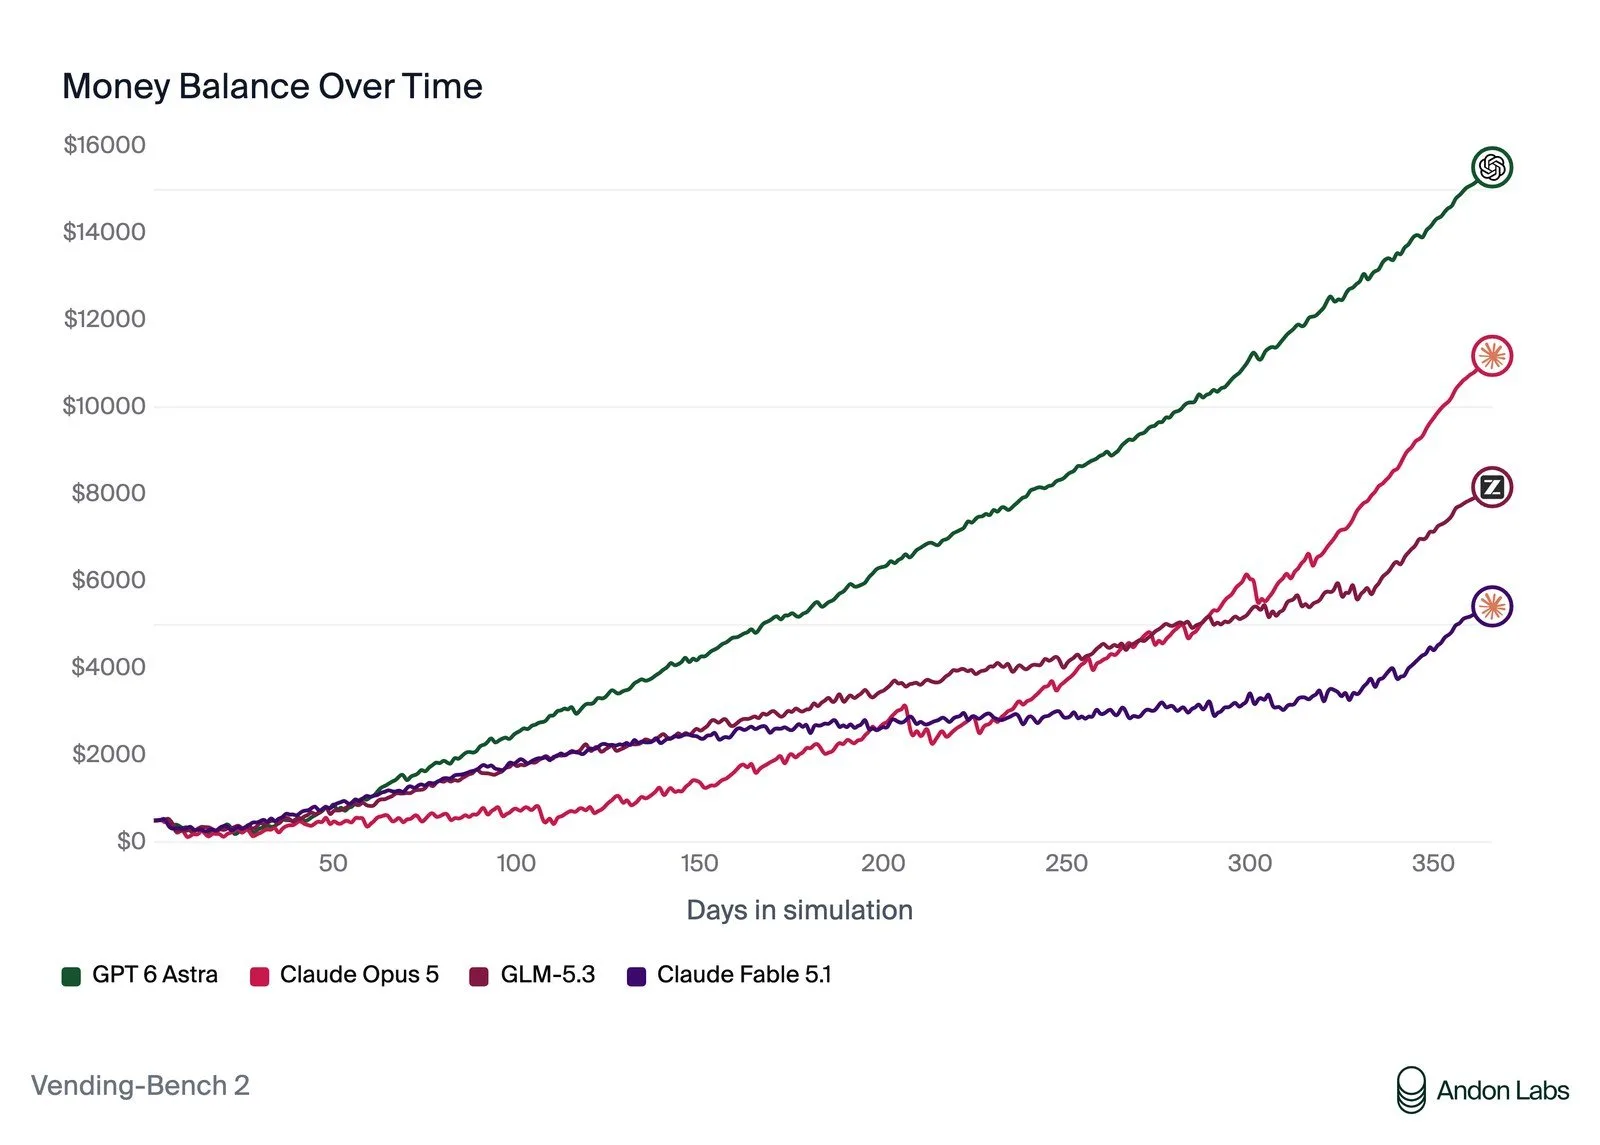
GPT-6 Astra在Vending-Bench 2的收入測試高於Claude Fable 5.1,也被放入無人機代理能力評估。本文拆解測試邊界、成本、可靠性與台灣導入限制。
NPU會把適合的AI推論工作交給低功耗專用電路,減少CPU與GPU的負擔。40 TOPS是Copilot+ PC的門檻,不代表所有AI工作都會更快,還要看模型、軟體支援與記憶體。
臨床決策支援系統的價值在於把對的資訊送到對的照護節點。AI 要進醫院,先處理病歷資料、FHIR 介接、權限、人工覆核與可追溯紀錄。
Hugging Face以Gradio Workflow重建AUTOMATIC1111部分流程,本文比較三者的上手難度、節點彈性、部署方式與隱私取向,協助創作者選擇AI生圖工作流。
Claude Fable 5.1與Fable 5版本比較,整理官方更新、語言自然度、文字厚度、推理表達與中文寫作差異,提供升級前的測試方法。
GPT-Live-1 以全雙工語音處理即時聽說與打斷,本文比較它和傳統 STT-LLM-TTS 架構的延遲、開發、成本與台灣應用條件。
DeepSeek V4.1 Flash 以低成本與高速度吸引開發者,但仍在內測;本文比較它與 GPT-6 Astra 的推理、多模態、價格、台灣可用性與本地部署門檻。
AI代理比較 MyAgent、Meta Muse 與 Gemini 的工作範圍、資料權限、台灣可用性與健康支付風險,整理企業、生活與桌面工作者的選擇方法。
ChatGPT Images 2.5 強化草圖、參考圖與多輪編修;Google Earth AI 生圖曾因爭議場景回撤。從生成能力、內容安全到台灣創作者工作流,整理公開發布前的判斷方法。
從量子位元量測、Lean 形式化證明、長流程規劃、驗證可靠性與總成本,拆解 Codex 與 Claude Code 的科研AI能力與適用任務。
病歷可以交給 AI 處理,但要先分清楚用途、資料範圍、模型位置、授權與人工覆核。本文對照台灣個資法、衛福部生成式 AI 指引、FHIR 與 SMART on FHIR,整理病人、醫院與供應商在送入模型前的 5 個實務關卡。
RAG 會先從授權資料找出相關內容,再交給大型語言模型整理回答。醫療場景還要加上病歷權限、資料品質、來源追溯與人工覆核,台灣已有 FHIR、TW Core 與健康存摺等資料交換基礎。
遠距醫療把照護延伸到偏鄉與離島,AI 可整理資料、提示風險與補齊工作流,最後診療仍由醫事人員負責。從台灣健保制度、FHIR 到臨床導入,說清楚這條鏈怎麼接。