中醫 AI 值不值得信任?上線前該查清楚的六件事
中醫 AI 可不可信,看展示影片的準確率沒有意義。六件事沒查過,就只是一個包裝精美的黑箱:推理能不能追溯、資料來源站不站得住腳、藥材溯源、法規分級、資料互通、出事誰負責。
科技
中醫 AI 可不可信,看展示影片的準確率沒有意義。六件事沒查過,就只是一個包裝精美的黑箱:推理能不能追溯、資料來源站不站得住腳、藥材溯源、法規分級、資料互通、出事誰負責。
GPT-5 Pro 幫免疫學家解開卡三年的 T 細胞謎題,還預測了沒公開過的實驗結果。但把這件事讀成『AI 會做科學了』,就解錯題了。
AI 真的自己做出化學發現了嗎?讀準一點:GPT-5.4 提假設、自動化實驗室跑一萬筆反應、人工逐筆驗證,三者缺一都不成。被解掉的是『沒人跑得起一萬次』的通量問題,不是智力問題。台灣要接住這波,缺的不是模型,是實驗室與資料。
AI 連自家出的生命科學考卷都只過三成,這件事該怎麼讀?分數是一回事,出題兼改考卷兼頒獎的是同一個人,又是另一回事。
AI 拿奧數金牌很亮眼,但那是自然語言、靠人工評審判對錯。用 Lean 4 逐行驗證的證明才解掉了難題:不用人幫忙也知道它是對的。這才是 AI 可信度第一次有的工程解法。
200 萬 token 是量產最長脈絡,但廣告脈絡不等於可用脈絡。長脈絡真正划算的只有幾類場景,其餘知識庫問答用 RAG 更省更準。這篇給一個先分清楚任務類型的選型判準。
上海 MiniMax 6/1 推出開源權重的 M3,前沿級 coding、百萬 token 脈絡、原生多模態一次到齊,定價只有西方旗艦零頭。但對台灣團隊真正的訊號不是又一個跑分新王,而是自架可行性與選型的成本結構被重寫。
為什麼一個還沒公開發布的模型,賭盤能開到六十幾萬美元?因為不確定性被商品化了。但賠率不是路線圖,跟著它調整選型是把工程問題交給賭客投票。
OpenAI 說新模型的健康答案贏過醫師,但分數全在它自家內部跑、未公開外審。真正的重點不是它贏了幾項,是每週 2.3 億人已在用 ChatGPT 問健康。AI 取代的不是醫師,而是 Google 搜尋。
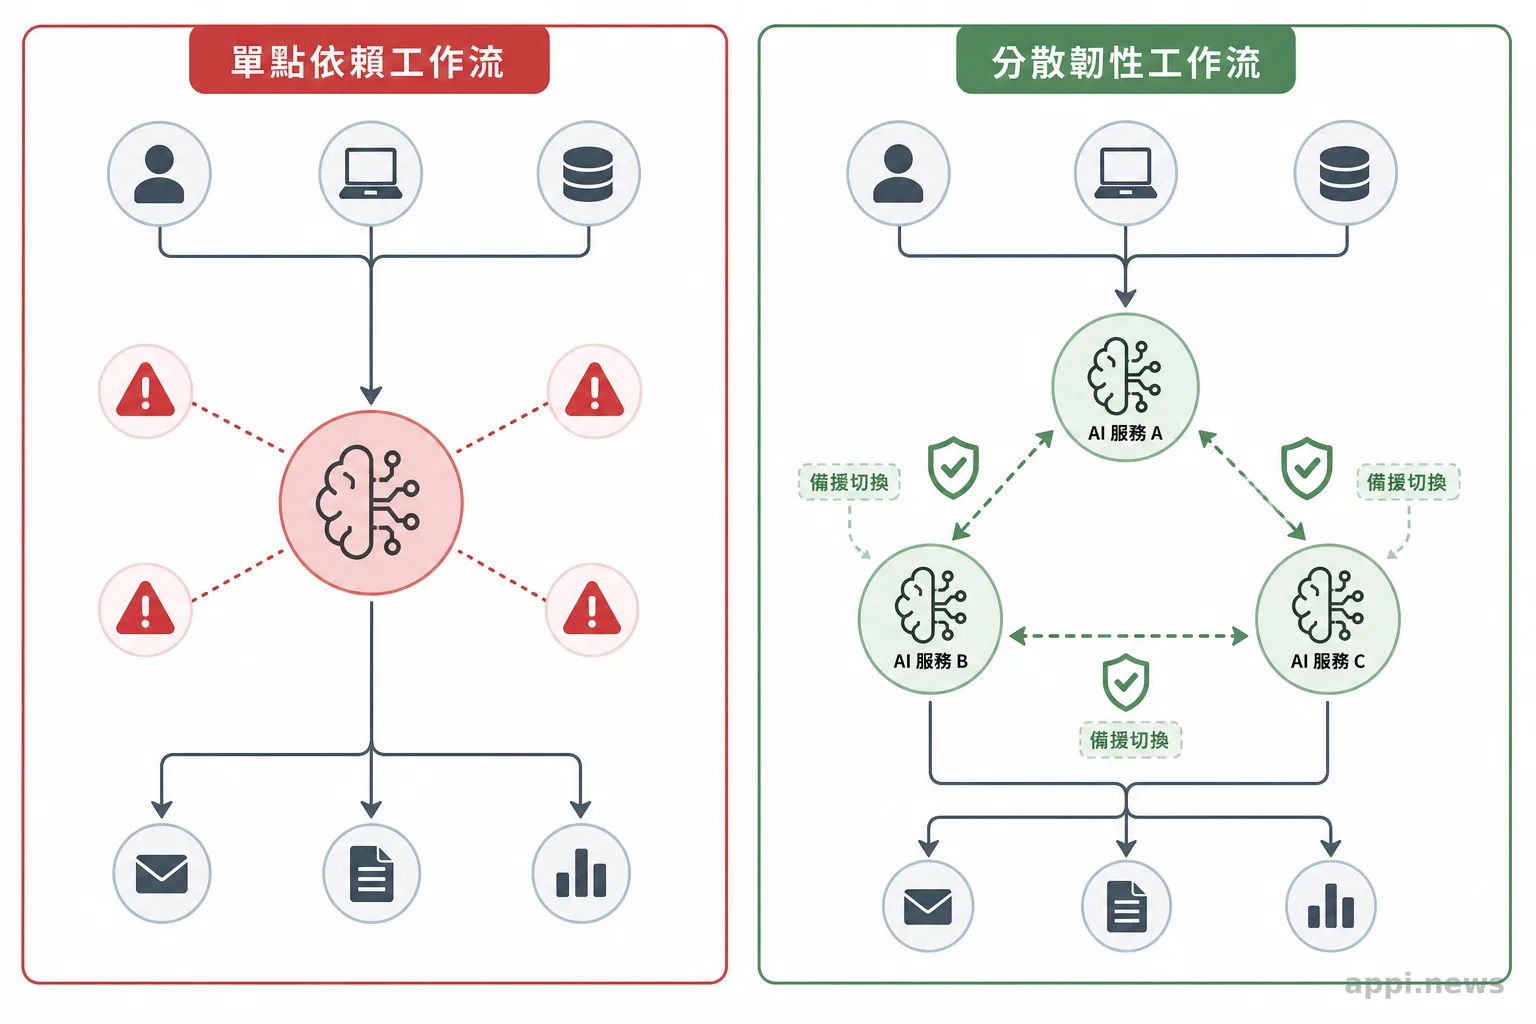
最強 AI 模型被比照核彈等級管制禁用,加上各版本服務持續出現錯誤率攀升,正在揭露一個更根本的問題:工作流對單一 AI 服務的過度依賴。本文從備援設計、容錯邏輯、管制趨勢應對、Prompt 跨模型可移植性四個面向,提出可執行的準備原則。
OpenAI 拿約 130 萬則真實對話重放、餵給待上線的新模型測試,比合成測題更早抓到行為漂移。上線前驗收該從跑分搬回真實情境,企業導入 AI 也一樣。
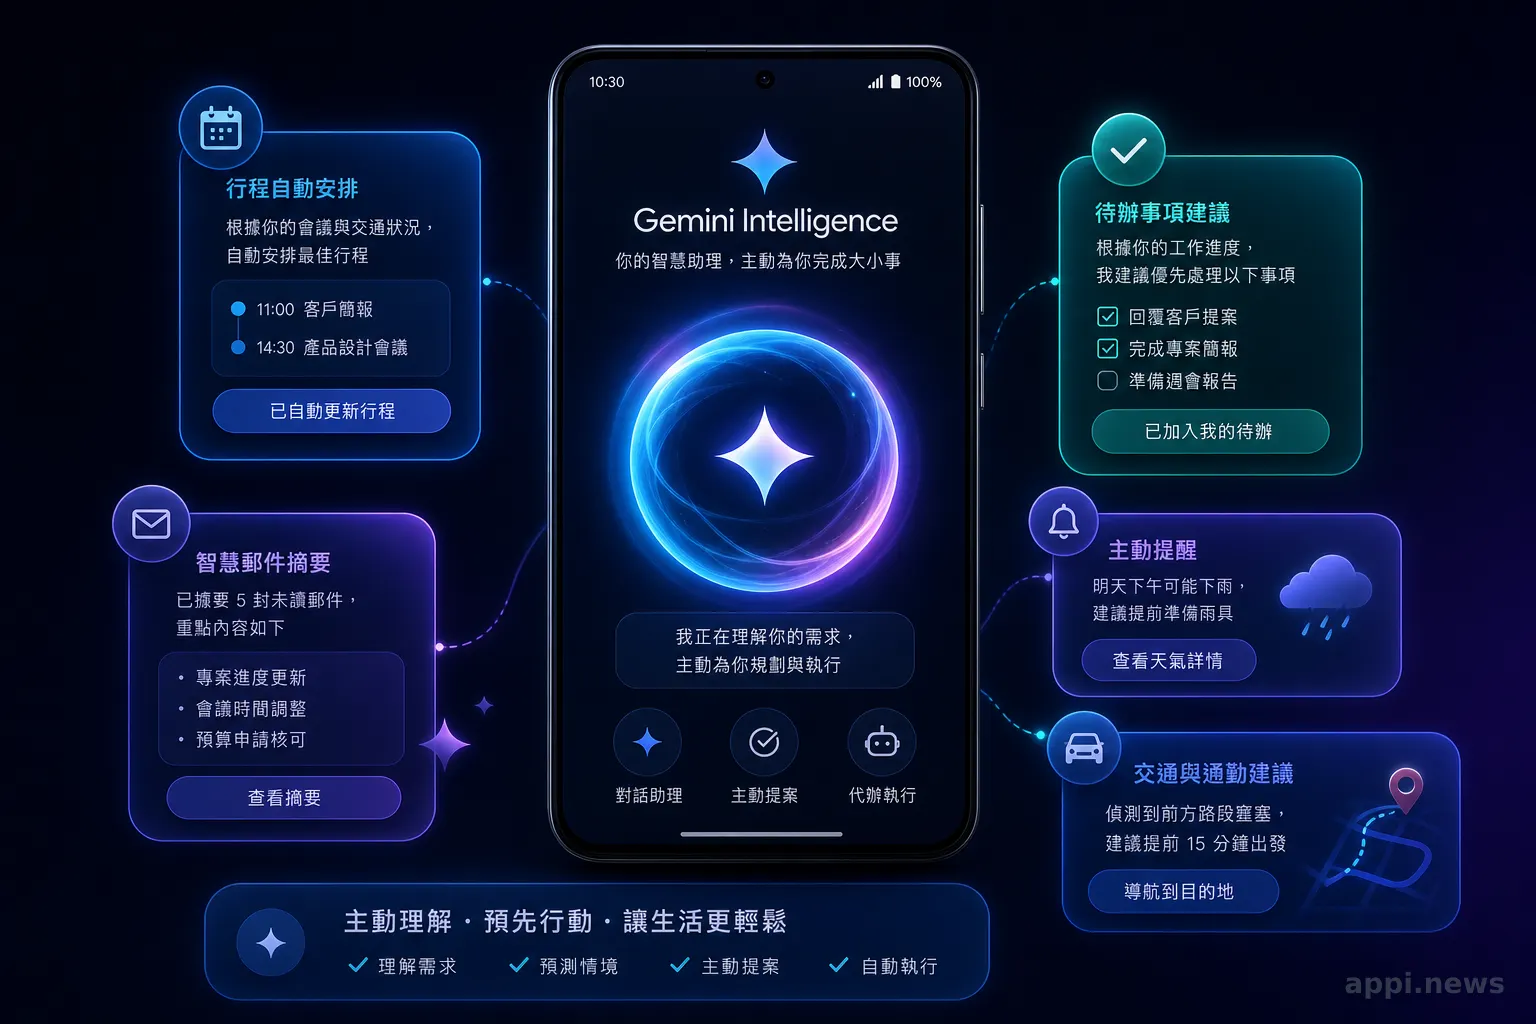
Android 17 把 Gemini AI 整合進系統層級,推出 Gemini Intelligence 功能套件。本文拆解五項核心能力、硬體門檻,以及裝置端 AI 推論對使用者隱私與實際使用的意義。
Anthropic 6 月 9 日把 Fable 5 推上「Mythos 級」,一個比 Opus 高一階的正式產品層。真正該看的不是 80.3 這種跑分,而是它在長任務、agentic coding 上的領先會隨任務難度拉開。這篇拆解這個分層對開發者選型的實際意義。
急診室第一線觀察:台灣每年逾 750 萬次急診就診,多數原因有跡可循。了解急診常見成因、日常必備準備清單,以及判斷什麼情況才真正需要掛急診。
企業普遍把導入 AI 的問題定義為「如何省成本」,但這可能是在解錯題。本文拆解 AI 對齊的三層失敗模式,說明為何無法保證 AI 確實在做你以為它在做的事,以及企業需要先問的核心問題。
AI 在製藥的落地,往往從臨床試驗管理、受試者篩選與法規送件開始,而非藥物發現前端。本文拆解背後的流程結構、資料條件與治理邏輯,說明這個順序為何不是偶然,以及如何判斷一個 AI 應用是否真正落地。
刊登於 European Heart Journal 的研究分析逾 12 萬張乳房攝影,顯示 AI 可從乳房動脈鈣化訊號推估女性心血管風險。這不只是一項新技術,而是醫療 AI 設計邏輯的轉變——從做好一件事,到順手讀出已存在的訊號。
中醫 AI 的可信度不只取決於準確率。本文分析三個關鍵層次:辨證推理是否透明可追溯、藥材供應鏈是否存在洗產地或加料通過檢驗等造假手段、炮製品質能否被數位化記錄,並提出評估可信度的系統性架構。