Hugging Face 在 2026 年 9 月 22 日宣布,Transformers 開始支援載入並執行部分 llama.cpp 常用的 GGUF 量化模型。符合相容條件的量化權重可接到 Python、PyTorch 與 Transformers 的實驗流程。
這項整合降低格式轉換摩擦,但硬體、模型架構與維運差異仍在;選擇取決於工作負載。
一、Transformers 支援 llama.cpp 量化模型,這次新增了什麼?
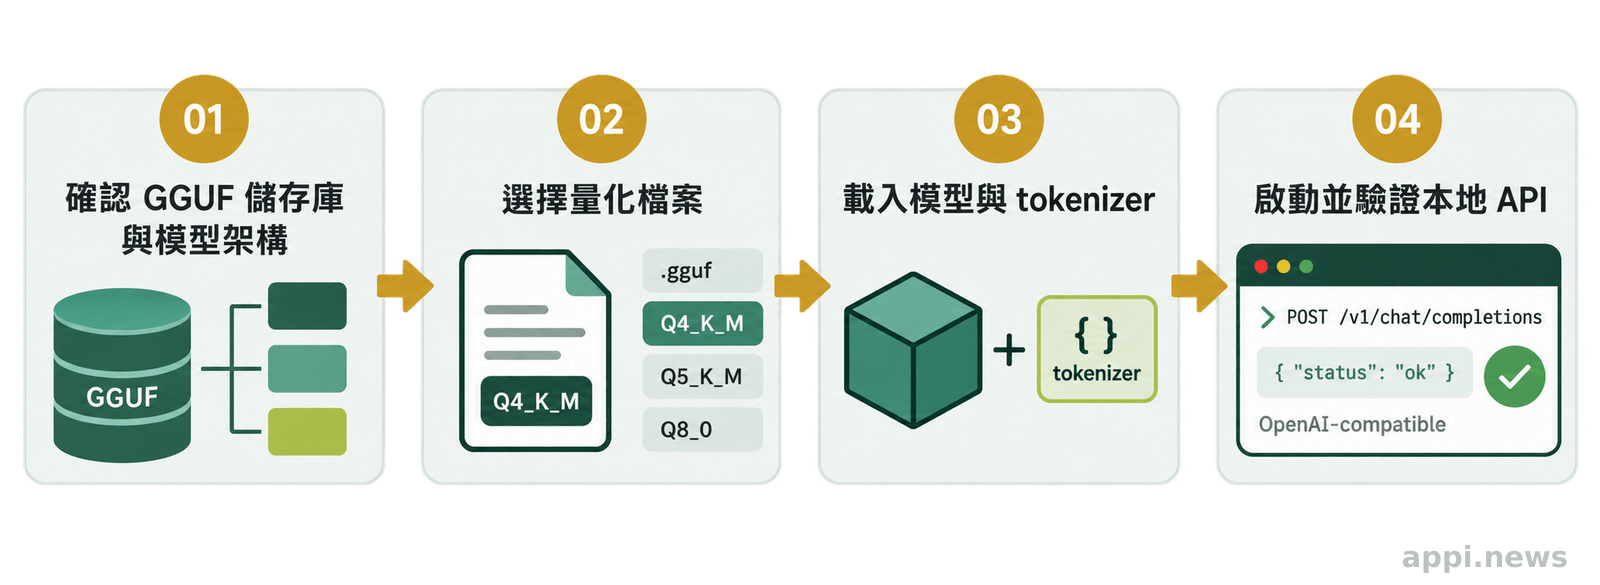
Transformers 現在能以 gguf_file 指定 GGUF 檔案,將部分量化模型接到既有的 Python 與 PyTorch API,減少模型格式轉換步驟。
GGUF 是 llama.cpp 常見的單檔格式,可包含權重與 tokenizer 資訊;量化則用較低位元數表示部分權重,在品質、檔案大小與記憶體間取捨。
現在可從 Hub 選擇含 GGUF 的 repository,再把指定檔名傳給 from_pretrained() 載入模型與 tokenizer。
GGUF 仍不是 Transformers 原生權重,載入器會依模型架構與量化類型處理,底層支援範圍仍要確認。
Hugging Face 官方公告將 llama.cpp 定位為優先考慮本地推論效率時的建議引擎;這項整合則讓開發與評估可使用同一批 GGUF 檢查點。
二、如何在 Transformers 中載入 GGUF 量化模型?
先確認 repository、GGUF 檔名與模型架構,再用 gguf_file 載入模型和 tokenizer;若要走壓縮權重路徑,還要確認相容的 kernels 與硬體後端。
在符合支援範圍的環境安裝並驗證 kernels,確認是否能處理 packed weights;安裝套件不代表所有模型都支援這條路徑。
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "unsloth/Qwen3.5-4B-GGUF"
gguf_file = "Qwen3.5-4B-Q4_K_M.gguf"

model = AutoModelForCausalLM.from_pretrained(model_id, gguf_file=gguf_file)
tokenizer = AutoTokenizer.from_pretrained(model_id, gguf_file=gguf_file)
載入後先用固定提示驗證 tokenizer、chat template 與生成結果。
在該 CLI 與模型支援範圍內,transformers serve 可用 <repository>:<file>.gguf 啟動 OpenAI 相容 API;首次部署應先以單一請求驗證 tokenizer、chat template 與生成結果,再實測排程、批次、記憶體與延遲。
三、Q4_K_M、Q5_K_M 與 Q6_K 的差異怎麼看?
較低位元的量化通常能縮小檔案與記憶體壓力,但品質和速度的變化要看模型、任務、核心與硬體;量化名稱本身不能代替實測。
以 Qwen3.5-4B 為例,Q4_K_M 檔案小於 Q5_K_M、Q6_K 與 BF16;差異不等於執行時總記憶體。
量化選擇要回到任務。Q4_K_M 可作為一般任務的初始候選;嚴格格式、長上下文或推理任務,仍要比較其他等級並用固定測試集驗證。
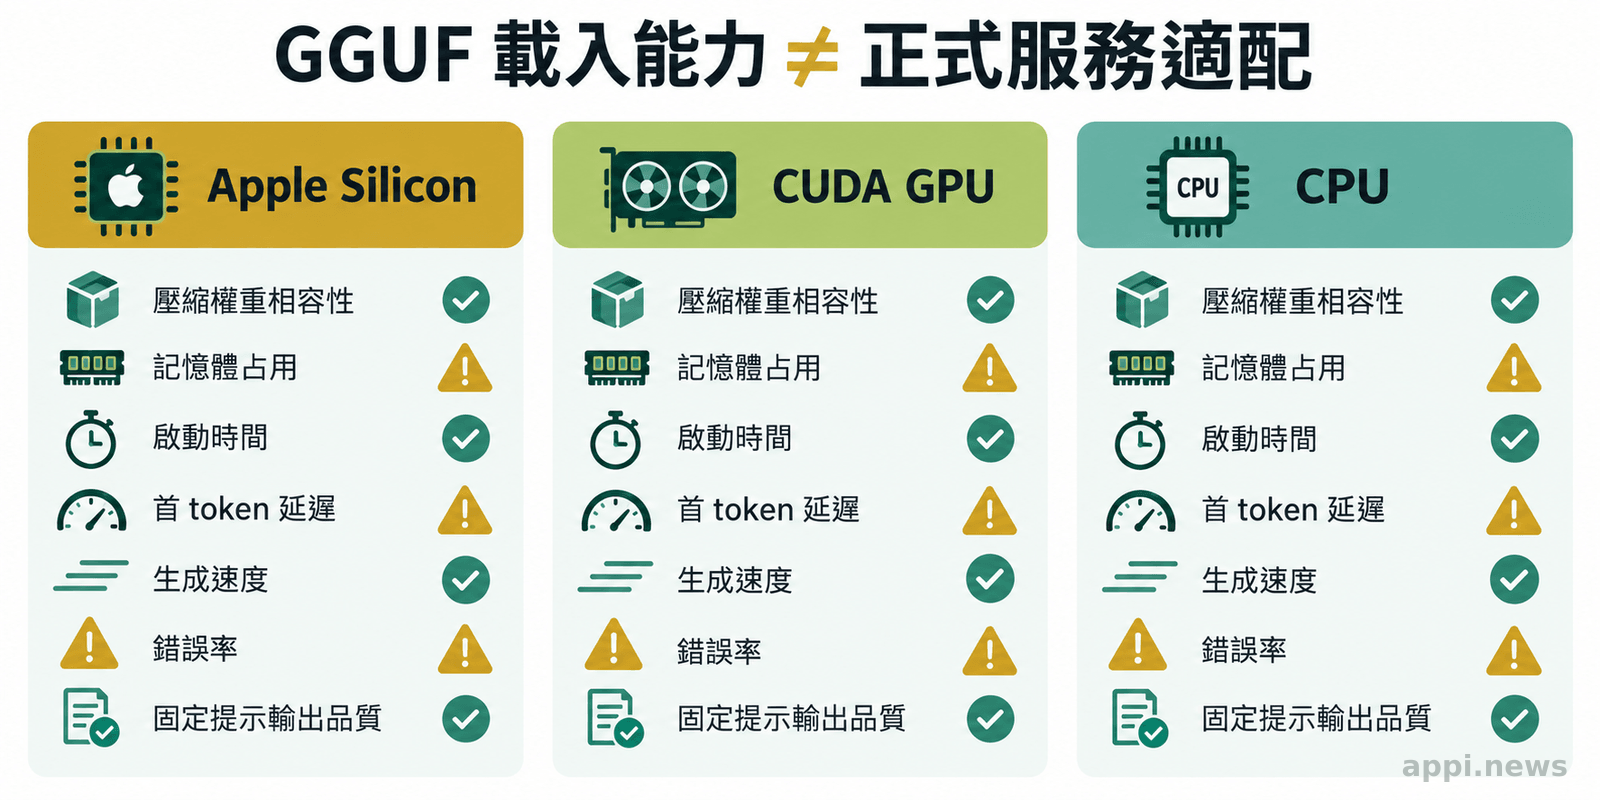
檔案變小不等於服務成本按比例下降。載入可能需要解量化暫存,推論還會使用 KV cache 與工作區;並發請求也會改變峰值需求。Apple Silicon 結果不能外推到 CUDA 或純 CPU。
四、Transformers 與 llama.cpp 怎麼選?
在相容模型、量化核心與目標硬體條件下,需要 Python、PyTorch、評估工具或自訂生成邏輯時,可將 Transformers 列入評估;已驗證 GGUF 且重視低開銷本地服務時,可將 llama.cpp 列入評估,實際效能仍須在目標硬體測試。
llama.cpp 提供多種硬體後端與命令列、伺服器工具;若只是讓已驗證的 GGUF 穩定回應,導入 Python、PyTorch、Transformers 與 kernels 可能增加維護面積。
| 條件 | 可列入評估 |
|---|---|
| Python、評估或自訂生成 | Transformers |
| 已驗證模型、低開銷本地服務 | llama.cpp |
| 已驗證 OpenAI 相容介面、中等負載 | transformers serve |
大型生產環境仍應比較 vLLM、SGLang 等專用後端的批次、並發與監控能力。
五、硬體、相容性與維運成本仍要怎麼檢查?
最需要確認的是模型架構與量化核心是否走到真正的壓縮路徑;若退回完整解量化,記憶體、啟動時間與推論效能都可能和預期不同。
只有在相容 Hub kernel、受支援架構與硬體後端同時成立時,權重才可能維持 packed 狀態。官方目前以 Qwen3.5 與 Qwen3.5 MoE 為例;Apple Silicon/MPS 等環境仍須驗證。其他架構或缺少 kernel 時,模型可能走 legacy loader 並完整解量化,增加載入記憶體。
官方文件列出的部分架構可能走 legacy loader;實際路徑須依版本、模型與硬體環境驗證。能讀 GGUF,與能以壓縮權重執行,是兩個驗收項目。
維運還包括套件、驅動與硬體版本;升級後應重測啟動時間、記憶體、速度、延遲與錯誤率。
- 選定模型與 GGUF 檔,記下 repository、架構與版本。
- 在目標硬體測試兩條路徑,記錄版本、legacy loader、解量化、記憶體、速度與固定提示結果。
- 依自訂流程或穩定服務選擇後端,建立可重跑基準。
- 在相容條件下,Transformers 可銜接評估與自訂生成;已驗證的 GGUF 可將 llama.cpp 列入本地服務評估。
- 量化取捨、解量化與模型架構都必須用目標硬體測試。
- 台灣使用者應建立基準,再決定單一路徑或兩者並存。
常見問題
Q1:GGUF 模型現在都能直接用 Transformers 執行嗎?
不能這樣推論;部分模型會走 legacy loader 並解量化。
Q2:使用 Q4_K_M 就一定比 Q6_K 快嗎?
不一定,仍受量化核心、硬體後端、上下文長度與並發影響。
Q3:已經有 Transformers 支援後,還需要 llama.cpp 嗎?
仍要視工作負載判斷:Transformers 適合開發評估;llama.cpp 適合本地服務。
Q4:transformers serve 可以直接當正式 API 服務嗎?
在 CLI、模型與硬體支援條件成立時,它可列入本地、評估、實驗與中等負載的方案;大型生產環境仍要比較專用後端。
六、結論:本地模型更好接了,但部署問題仍需驗證
本地模型在格式接合與 Python 開發流程上更容易開始,但這不代表部署問題消失。 GGUF 能否以壓縮權重執行,仍取決於模型架構、Tokenizer、Chat Template、量化核心、硬體後端與套件版本。
對台灣使用者而言,較穩妥的做法是先用實際模型與工作負載建立基準,記錄峰值記憶體、首 token 延遲、生成速度、錯誤率與輸出品質,再決定採用 Transformers、llama.cpp,或讓兩者並存。這樣評估的結論,才不會把「檔案能載入」誤當成「已適合正式服務」。