很多人評估小型模型時,第一眼會先看參數量和速度。但更前面的問題是,代理流程有哪些判斷能列成選項?判錯後會觸發什麼動作、影響誰?AWS Strands Labs 於 2026 年 10 月 1 日發布 Strands Decider 2B,將小型決策模型帶入 Strands 代理開發工具。它處理流程中的選擇、是非判斷與評分;是否能降低延遲或成本,仍須用自己的工作負載測量。
一、Strands Decider 2B 將判斷工作獨立成模型
Strands Decider 2B 是供代理流程使用的小型決策模型,能在預先定義的選項間選擇、做是非判斷或評分。它適合處理範圍明確的流程判斷,無法代替大型語言模型撰寫文字或進行複雜推理。
一般大型語言模型(LLM)可以依照提示生成各種長短不一的文字,也能解釋推理過程;決策模型的輸出空間則較窄。開發者提供一段狀態或文字,再列出問題和選項,模型只需要判斷哪個選項較符合條件、回答是或否,或按指定尺度打分。比如客服代理收到「付款連續失敗三天」的訊息,可以將工單分派給帳務、銷售或零售團隊;模型負責挑選路由,後續回覆仍由其他模型或程式處理。
Strands 官方將這類模型定位在大型語言模型與傳統分類器之間,可處理開發者定義的分類與評分,不必為每個類別另訓練分類器。官方也提醒,因輸出不是自由生成,它較不適合寫程式、聊天、摘要或複雜推理。決策模型處理的是代理流程中的特定判斷環節,並未承接整個代理任務。
「決策模型的設計目標,是在一組選項中做選擇,並為結果評分。」(中譯)— Strands Agents 團隊,官方發布文章
這項產品以 Qwen3.5-2B 為基礎,移除負責文字生成的語言模型輸出頭,改用比較選項的指標頭。官方專案說明,模型以單次前向運算評估答案,不需逐字生成或逐步解碼。輸出因此限定在選項中,無法直接回傳一般文字答案。
「2B」指約 20 億個參數。Strands Labs 表示模型可在本機 CPU 或 GPU 執行,專案採 Apache 2.0 授權並公開訓練資料與腳本。使用前仍應查看官方專案及授權檔,確認依賴套件、硬體與資料處理方式;開放原始碼不會自動補足監控、權限或安全設計。
二、先找流程裡的明確判斷,再安排模型位置
當輸入資料已經到位、可選動作能明確列出,而且判斷結果有清楚後續處理時,決策模型較值得評估。工具選擇、請求分流、參數檢查和模型路由都可能符合這些條件,但各自仍需用實際資料驗證。
以工具選擇為例,代理收到「台北明天下雨嗎?」後,可在天氣查詢與一般回答間選擇。參數檢查可確認工具呼叫是否包含必要欄位、輸入是否有使用者提供的依據;請求分流則可將工單送往帳務、技術支援或人工服務。模型判斷後,由既有程式執行動作。
「選項明確」不代表「選項設定正確」。若路由漏掉退款申訴的專責窗口,模型即使穩定選中某一項,案件仍會送錯地方。應先梳理流程、欄位定義和例外,確定選項涵蓋真實工作,再評估模型能否改善效率。問題定義錯誤,分數與速度都無法補上流程缺口。
官方 GitHub 專案展示一個 Strands 代理範例:代理準備呼叫天氣工具前,決策模型先檢查城市參數是否有使用者陳述作為依據,以及是否應先向使用者詢問。範例在工具執行前介入,若資訊不足就讓代理先澄清。這只是說明整合方式的示例,提問內容、門檻與動作都由開發者手動設定,不能當成已在多種產品環境證實的通用成效。
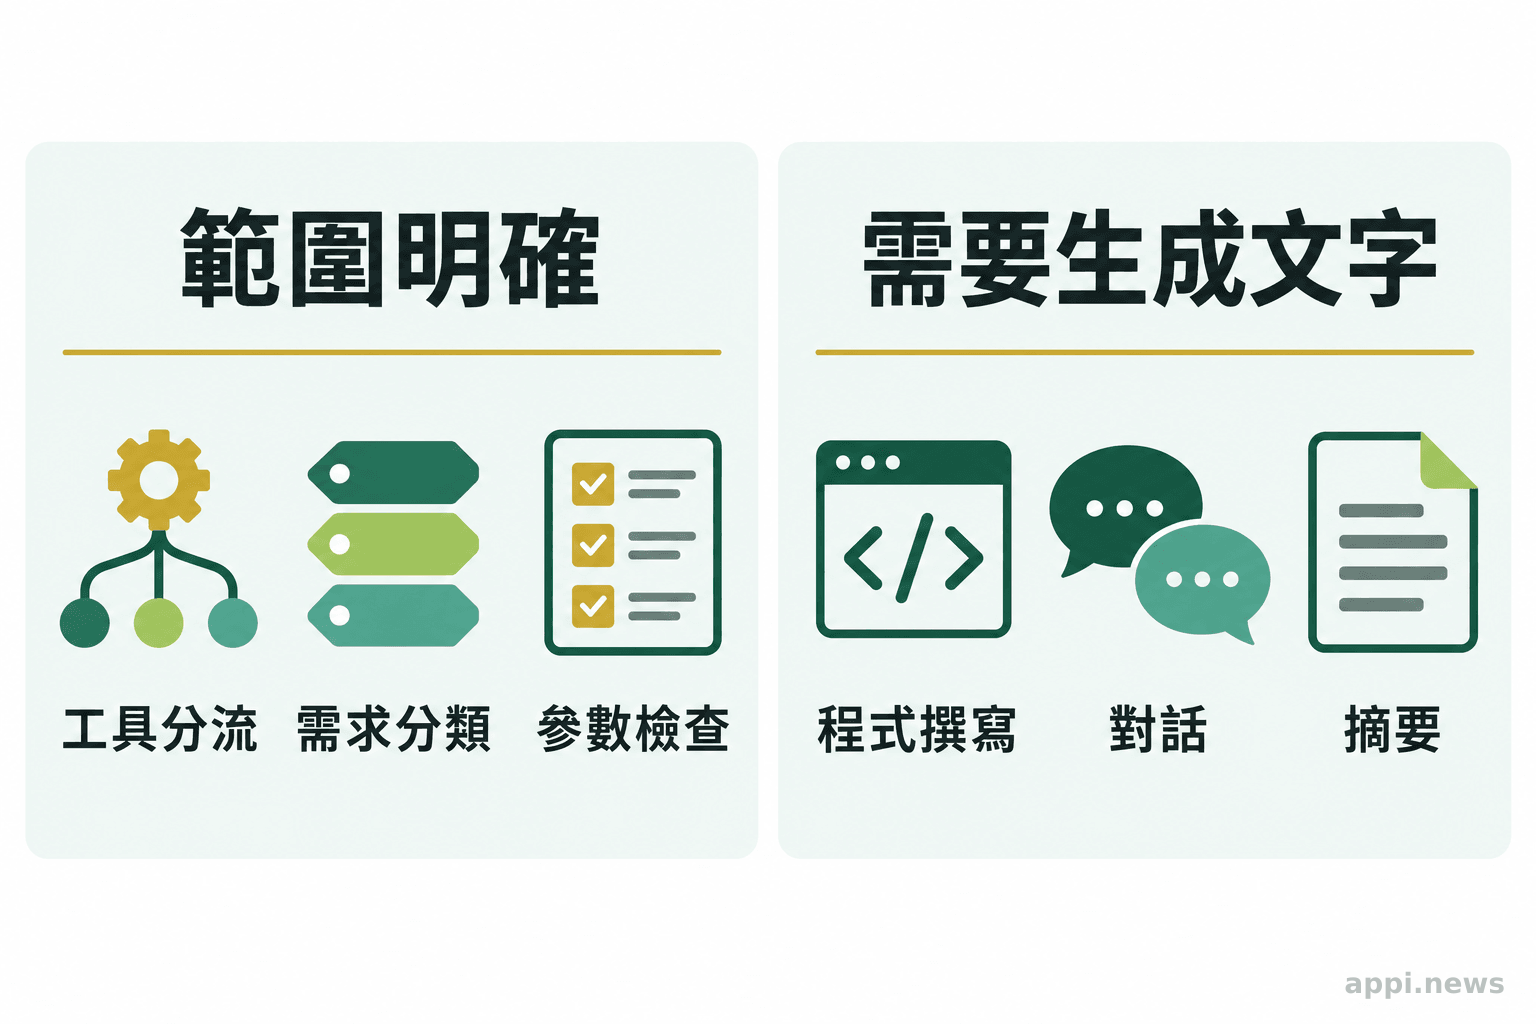
複雜推理、程式撰寫、聊天和文件摘要需要多樣文字或多步驟處理,仍應交給大型語言模型、固定流程或人工。大型模型可負責較難任務與文字生成,決策模型處理重複、選項固定的檢查;每增加一個判斷節點,也會增加錯判、漏列規則和維護版本的機會。
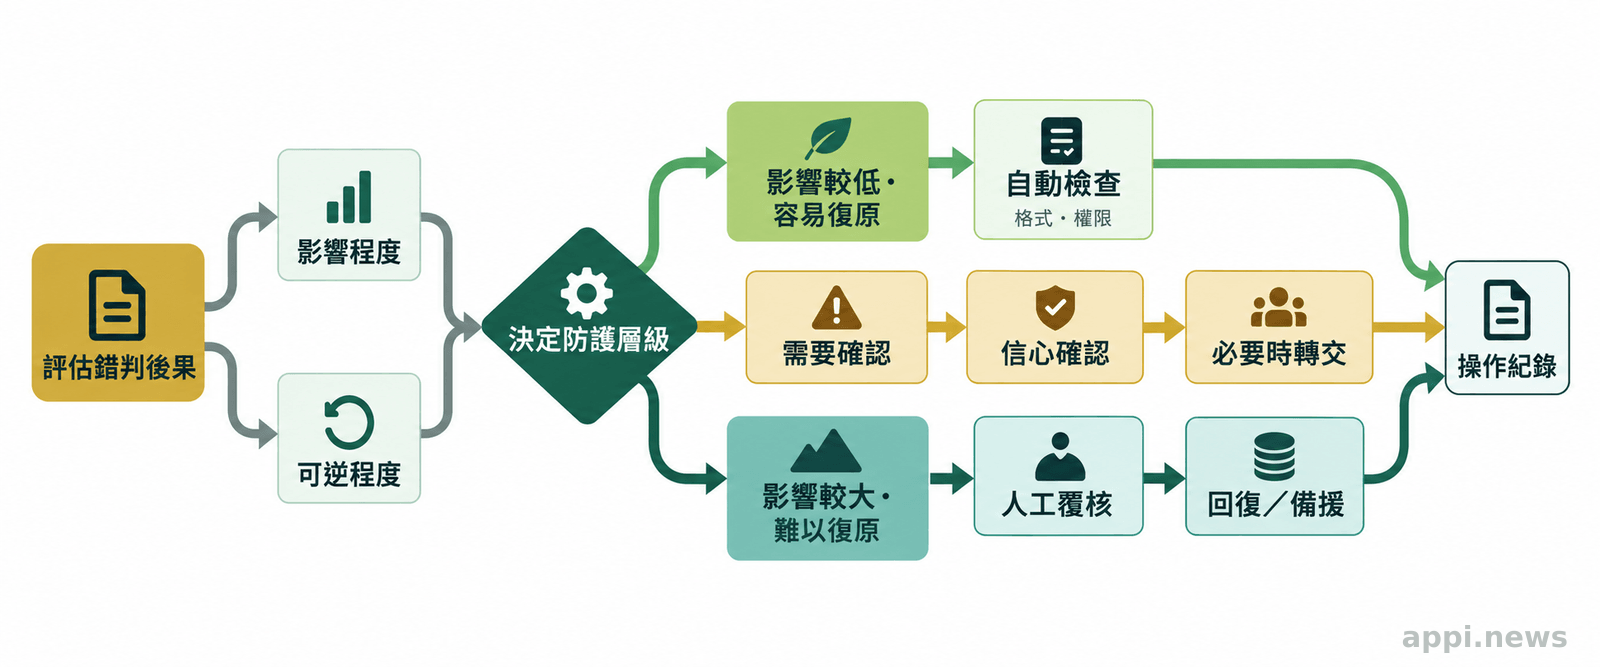
更要留意輸出接到工具後的責任邊界。模型選出的參數應先經程式檢查欄位格式、資料依據及使用者權限,再由工具執行;遇到缺值、逾時或信心不足時,流程需知道如何停止、要求確認或交給人工。若模型能直接觸發付款、刪除資料或修改帳號等高影響動作,錯判可能造成實際損失,必須採取較嚴格的覆核與回復設計。示範程式不等同完整安全方案。
三、速度、準確度與信心都要看測試條件
目前公開數據只能描述特定基準與硬體下的結果,不能保證每個團隊都能重現。輸入長度、問題難度、同時處理量、執行硬體和現有流程都會影響延遲、準確度與整體成本。
Strands 官方稱,在 JevBench 公開測試集的 2B 參數模型中,Strands Decider 2B 的準確度與校準排名第三;特定工作負載在 RTX 3090 的中位延遲約 115 毫秒,在 M3 MacBook 小型任務約 153 毫秒。這些模型團隊引用的測試有特定硬體、輸入長度和任務組成,不能直接預測讀者環境。
專案列出的 v19 結果為 JevBench 公開集 231 題答對 167 題,準確率約 72.3%;RTX 3090、WSL2 環境延遲中位數為 115 毫秒,第 95 百分位為 299 毫秒。專案提醒,231 題樣本仍少,單次測試相差不到約 10 題時,不宜判定模型間有明確優劣。這些結果可用來提出測試假設,實際選擇仍須用自有流程比較。
「231 個任務仍然不多,單次測試相差不到約 10 題,差異可能尚未能確定。」(中譯)— Strands Decider 專案評估說明
小模型每次只需計算候選選項分數,不必生成完整文字;本機執行也可能省去雲端往返延遲。但 GPU、CPU、記憶體、批次策略和輸入長度都會改變結果。若上下文較長、併發量高,或前面仍需其他模型整理資料,瓶頸可能在別處。
成本不能只看單次推論,還要計入整合、硬體或雲端運算、監控、更新、資料整理、錯誤追查和人工覆核。錯誤分流造成重工或工具執行失敗,都可能抵銷推論節省。評估時應記錄成功任務的總成本與處理時間。
信心分數則是協助流程決定「直接處理、再確認或轉交」的訊號,不是答案正確證明。即使專案在某些短分類任務中報告高信心答案有相應正確率,也不能推論相同分數放在不同語言、領域或資料分布仍有相同意義。使用者輸入方式、錯誤類型及選項設計改變時,信心校準也可能偏移,因此門檻應從自有測試資料估算並持續監測。
四、導入前要先算清錯判後果與回退方式
先找出每種錯判會造成的後續動作、受影響角色和修復成本,再決定模型是否能介入。錯誤若容易發現且可逆,可從小範圍測試;若會觸發高影響或難以復原的行動,就應保留人工確認或不讓模型直接執行。
可以先列出流程可能發生的錯誤,例如把急件分到一般佇列、把使用者未提供的資料當成真實參數,或把不符合權限的請求交給工具。接著問三件事:錯誤會影響誰、多久能被發現、修正是否會留下不可逆後果?若錯誤只造成延遲,可以設定回退佇列;若會修改重要資料,就要在工具端再次驗證授權,並留下可追溯的操作紀錄。
安全設計不應只依靠模型的信心。低於門檻時,可交由大型模型進一步判斷、向使用者補問,或轉交人工;高於門檻也應先通過格式、權限和業務規則檢查。模型、工具與流程各自負責的範圍要清楚,否則出錯時難以判斷是輸入資料、候選選項、模型結果還是執行程式造成。
比較方案時,可把現有規則式流程、大型語言模型和決策模型放在相同資料與相同任務上測量。若既有規則已能可靠處理判斷,增加模型可能沒有必要;若問題需要解釋、推理或生成文字,小型決策模型也可能不合用。真正要比較的是端到端成功率、錯誤成本、延遲、人工介入率和維護負擔,而非單看排行榜或參數規模。
採用開源模型前,應確認商用與再散布授權、模型權重及訓練資料條件、硬體需求和套件維護責任。即使模型在本機執行,代理流程其他部分仍可能連接外部 API;資料路徑須逐段檢視,不能假定整體資料都留在內部。
導入前的評估步驟
- 挑一個輸入與候選選項明確、目前已有人工或程式判斷的環節。
- 整理具代表性的測試資料,標出正確選項、可能錯誤及各錯誤的影響程度。
- 以相同資料比較現有方法、決策模型和必要時的大型模型,記錄準確度、延遲、信心校準與人工介入率。
- 設定參數驗證、權限檢查、低信心轉交和失敗回復方式,再以小流量觀察實際錯誤。
- 把整合、監控、硬體、維護與人工覆核納入總成本,確認指標改善後再評估擴大。
五、從小範圍試驗開始,依結果決定是否擴大
用自有資料建立基準,觀察準確度、延遲、錯誤後果和全流程成本,再決定是否擴大。測試結果應能回答模型適不適合某個明確環節,而非只證明它在展示案例中可以運作。
測試集要涵蓋一般輸入、邊界案例、資訊不完整、措辭變化和少見但影響大的例外。把模型判斷與人工標註比較,並分開記錄各類錯誤。例如客服分流不只看總體準確率,還要看高優先案件是否被漏掉、不同部門是否有偏高的錯派率,以及低信心案例是否被妥善轉交。平均數字可能掩蓋少數高風險情境。
延遲也應從端到端流程測量,包含資料整理、模型載入、網路、規則驗證、工具呼叫和等待人工確認。測試期間可以先採影子模式,讓模型輸出暫不控制正式流程,再與既有決策對照。確認問題後,才讓模型處理低風險且容易回復的部分;每次擴大範圍,都應保留停止條件和回復舊流程的方式。
如果模型輸出會改變工具行為,日誌至少要保留輸入、候選選項、模型版本、信心值、採取的動作和後續結果。模型更新、選項或流程規則調整後,也應重新驗證關鍵指標。
決策模型把明確定義的判斷交給較精簡的計算方式,讓大型模型或人工處理文字生成與複雜推理。能否改善流程,取決於問題定義、資料品質、動作權限和錯誤處理。可先挑選選項清楚、錯誤能被發現且可安全回退的環節,用實際資料比較準確度、信心校準、延遲與總成本,再決定是否導入。
- Strands Decider 2B 適合選項明確的分類、是非判斷與評分,不能承接一般文字生成或複雜推理。
- 官方基準和硬體數據不代表所有部署環境;信心分數需用自有資料校準。
- 導入評估要計入錯判後果、整合與維護成本,並設計參數檢查、權限邊界和回退路徑。
常見問題
Q1:Strands Decider 2B 可以取代大型語言模型嗎?
應與既有流程整合。它輸出限定選項或分數,適合部分明確判斷;需要撰寫、摘要、聊天或複雜推理時,仍需其他模型或流程。
Q2:信心分數高,就代表判斷一定正確嗎?
不代表。信心分數可協助設計轉交門檻,但可靠程度會受任務與資料影響,應用自有測試集檢查校準,並保留錯誤處理路徑。
Q3:如何確認小型決策模型是否能降低成本?
在相同資料與任務上比較現有流程、決策模型及必要時的大型模型,計入延遲、硬體、整合、監控、錯誤修復和人工覆核,再看整體成功任務成本。
參考來源
- Marc Brooker, Mike Chambers, Fabio Nonato de Paula (2026). *Introducing Strands Decider 2B: a small, open source, decision model*. Strands Agents
- Strands Labs (2026). *GitHub - strands-labs/strands-decider: A small, fast decision model, or system one model, for agentic workflows. Pick between options or rate on a scale faster than an LLM, with a calibrated confidence on every decision. · GitHub
- Strands Labs (2026). *strands-decider/evaluation/results.md at main · strands-labs/strands-decider · GitHub