多人會議逐字稿即使每個字都轉對,若沒有標出發言者,承諾、異議和待辦仍可能對不上人。語音系統要把聲音轉成文字,也要判斷每段由誰發出。NVIDIA 的 Nemotron 3 Diarization 是開放權重的說話者分離模型,官方標示約 9,920 萬參數、最多支援八位說話者。它提供發言區段與時間資訊,仍須串接自動語音辨識(ASR)才會形成附標籤的逐字稿。
一、逐字稿有文字,為什麼還需要辨識說話者?
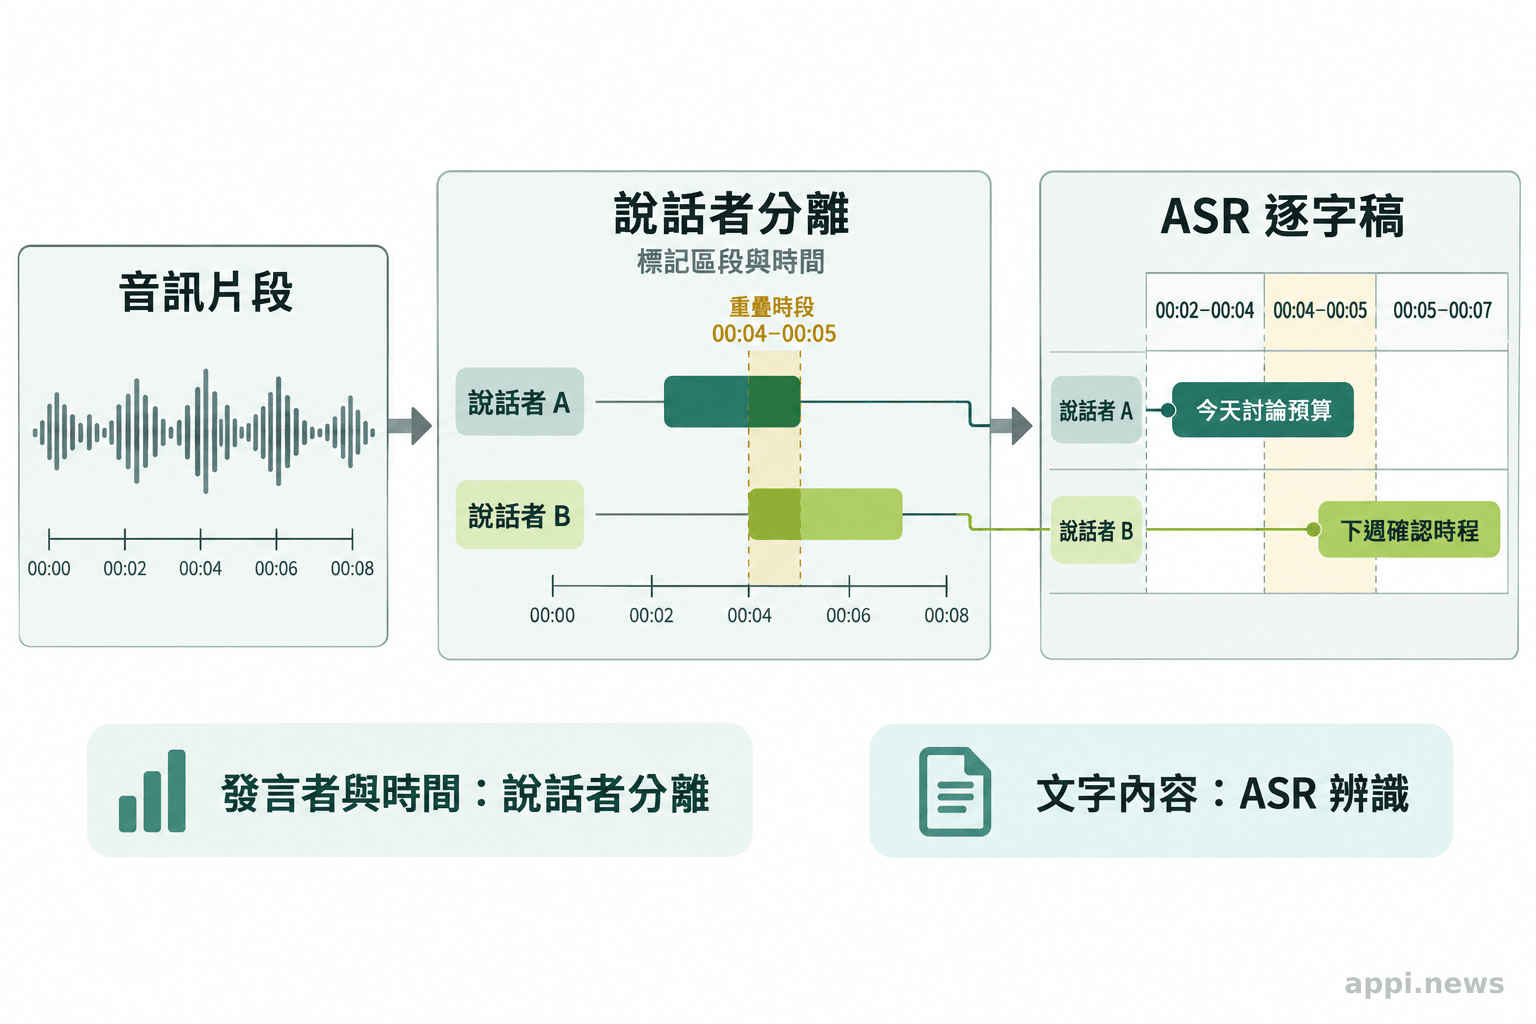
自動語音辨識(ASR)負責把語音轉成文字;說話者分離則標記各段語音的發言者與起訖時間。兩者資訊對齊後,系統才能把句子附到匿名的說話者標籤上。
會議逐字稿若只記下「週五前交付」「規格還要確認」,卻沒有發言者標籤,閱讀者就難以確認誰承諾交付、誰提出疑慮。說話者分離為搜尋、摘要或待辦擷取補上對話角色,但不會替使用者決定責任或驗證發言真偽。
ASR 輸出字詞,說話者分離輸出活動區段和時間戳,系統還要把兩者對齊。Nemotron 的 speaker_0、speaker_1 是匿名代號,不代表姓名或身分核驗;重疊發言的文字準確度也取決於 ASR 和收音。Sortformer 論文討論依首次發言時間排列標籤,方便下游對齊,但不會消除錄音含混造成的錯誤。
二、Nemotron 3 Diarization 增加了哪些能力?
官方模型卡標示此模型約 9,920 萬參數,支援離線與串流說話者分離,最多可輸出八個匿名說話者通道。它辨識的是「誰在什麼時間發言」,不會單獨產生逐字稿。
參數量不能說明模型該接在哪個環節。Nemotron 3 Diarization 估計各時間區段的說話者活動並產生起訖時間。離線模式處理錄音檔;串流模式逐段接收音訊並延續前面片段的標籤。切段後要跨過沉默、插話與發言輪替維持標籤,否則同一人可能被拆成不同說話者。
串流 Sortformer 研究提出 Arrival-Order Speaker Cache(依出現順序保存說話者特徵的快取),讓前段音訊線索延續到後續片段。Nemotron 3 Diarization 也用說話者快取和近期音訊佇列維持通道。這只能協助追蹤標籤,不能辨認姓名或保證不會錯置。
「開發者應使用符合具體用途的資料評估模型,並確認完整系統符合相關產業與部署情境的要求。」— NVIDIA Nemotron 3 Diarization 模型卡(譯)
模型權重開放下載,不等於毫無條件。官方模型卡列明使用條件依 OpenMDW License Agreement 1.1,部署者仍要讀取授權條款並確認自己的使用方式符合條件。自行部署也要計算硬體、推論服務、監控、升級和故障處理成本;參數量較小不會自動抵銷這些工程工作。
三、即時辨識如何在延遲與表現之間取捨?
官方串流設定的輸入緩衝延遲包含 1.04、0.64 與 0.32 秒等選項;這些數字不含模型運算、網路、ASR 和應用程式處理時間。緩衝縮短可較早送出結果,卻會減少模型判讀上下文的時間。
| 處理方式 | 適合情境 | 評估重點 |
|---|---|---|
| 離線 | 會後整理、批次逐字稿 | 運算時間、人工修正成本 |
| 串流 | 即時字幕、通話介面 | 端到端延遲、標籤更新穩定度 |
模型卡的延遲指音訊片段與前瞻音訊(look-ahead)累積後、模型開始推論前的等待時間。端到端延遲還包括推論、ASR、傳輸與介面更新。客服字幕可能要求快速顯示,會議紀錄則可會後處理,兩者設定未必相同。
官方評測數字來自特定資料集與硬體,可用來比較設定,不能當成台灣會議室、客服電話或消費裝置的保證值。麥克風距離、混響、噪音、語言、口音、人數及重疊發言都會影響輸出。中文或中英夾雜情境尤其要用目標音訊驗證,不能由英文基準測試推定效果。
「更多右側上下文能協助判讀說話者轉換,較少上下文則能減少等待輸出的時間。」— NVIDIA Nemotron 3 Diarization 技術文章(譯)
先定義產品可容忍的標籤等待時間,再比較不同設定的錯置率與修正時間。0.32 秒不代表整個產品的端到端延遲;若輸出會觸發即時行動,也要評估標籤錯置時如何更正或提示不確定性。
四、哪些語音工作流適合先試接?
已經有 ASR、而且逐字稿需要保留發言角色或時間脈絡的工作流,較適合先評估說話者分離,例如會議紀錄、客服通話分析或即時語音產品。若只需要單人語音轉文字,額外加入 diarization 可能沒有足夠效益。
會議紀錄可在錄音完成後產生標籤,再由人工核對決策、異議與待辦的發言者。客服分析要確認標籤能否穩定對應通話兩端;即時語音產品還須同步處理片段輸入、ASR 和介面更新,接上音訊串流只是整合的一部分。
先確認 ASR 時間戳、音訊格式與取樣率、硬體吞吐量、緩衝時間,以及授權和聲音資料治理。模型卡範例使用 16 kHz 單聲道音訊,部署前應核對前處理要求。
錄音含個人聲音時,還要規劃告知、適用的同意程序、保存期限、存取權限和刪除流程。本地部署不會免除資料治理責任;多人插話或遠距收音的標籤也可能需要人工校正。
五、導入前如何用小規模測試確認適用性?
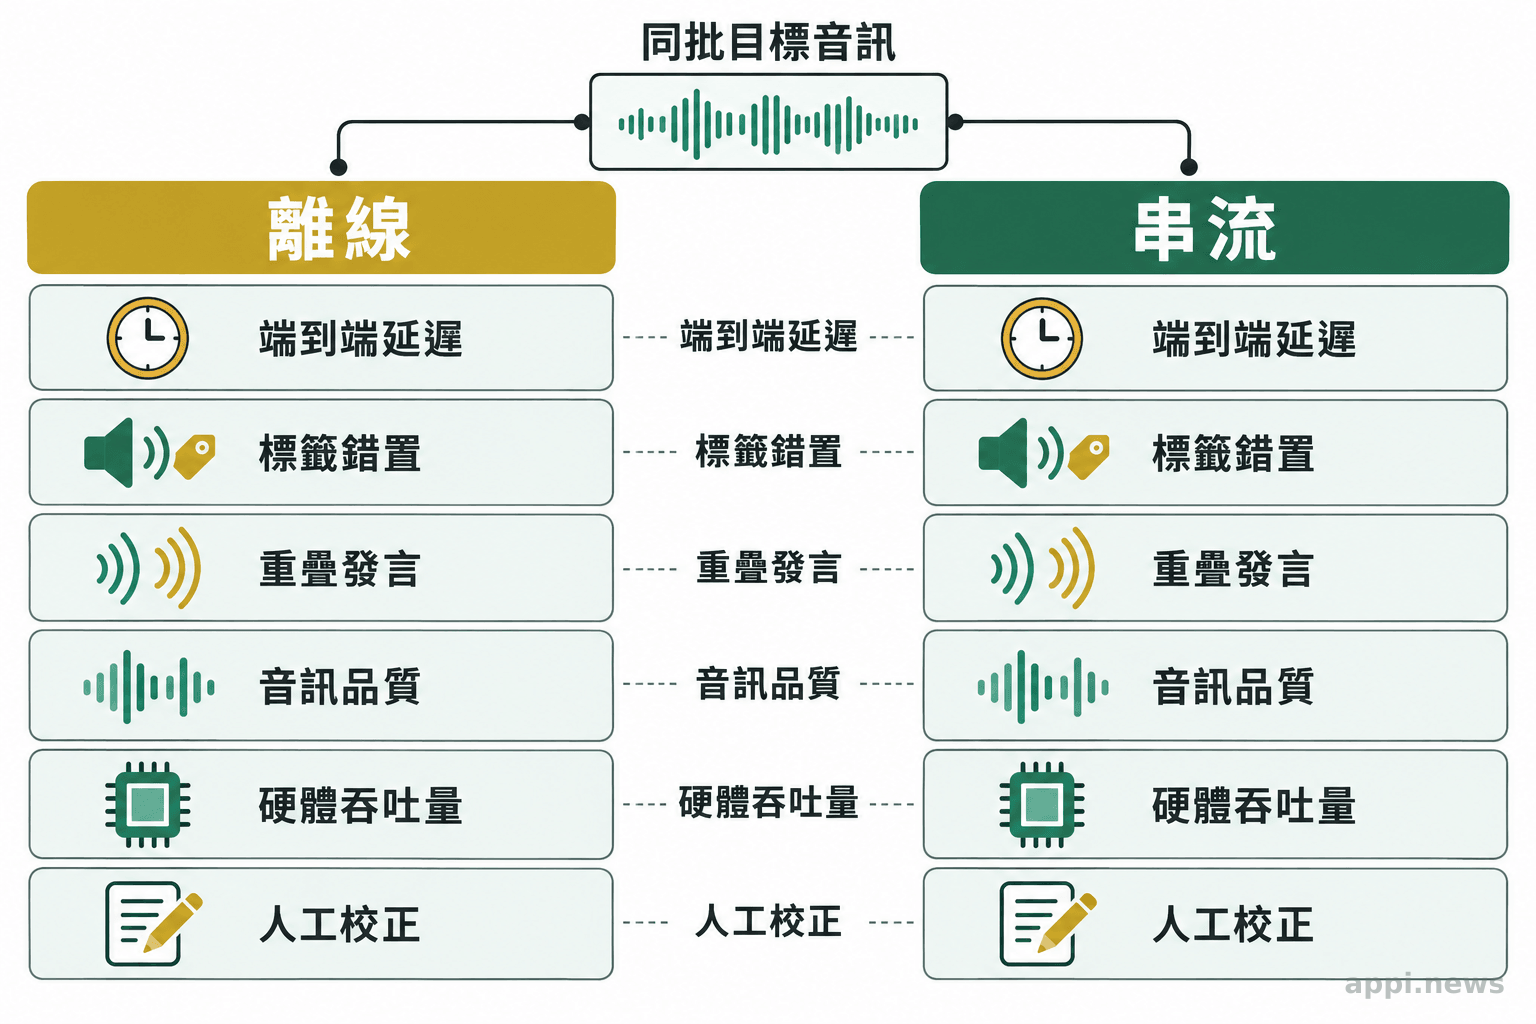
用涵蓋典型與困難情境的自有音訊,並排比較離線和串流設定,記錄端到端延遲、說話者錯置、重疊發言處理及人工修改成本。結果能接回既有 ASR 流程後,再評估擴大部署。
測試素材涵蓋實際人數、麥克風距離、噪音、插話、重疊發言與使用語言。以人工標註為參考,分別記錄說話者錯誤、時間偏差和 ASR 字詞錯誤。
用相同素材比較緩衝設定,量測端到端時間,以及標籤改動是否讓摘要或待辦反覆變更。離線測試記錄運算與修正時間;串流測試確認縮短延遲後標籤和介面是否可接受。固定硬體、精度與軟體版本,才便於比較。
- 挑選符合實際人數、語言與收音環境的測試音訊,並先定義可接受的延遲和修正成本。
- 對照離線與串流緩衝設定,分別評估說話者錯置、重疊發言、ASR 對齊和端到端延遲。
- 確認標籤能接上現有逐字稿流程、資料治理與授權條件,再決定是否擴大部署。
Nemotron 3 Diarization 為語音模型選型增加說話者分離選項。相較先前談到的 Qwen Audio 3.1,這款模型聚焦在「誰何時發言」,定位為 ASR 流程的補充。評估時先確認發言者脈絡是否為現有工作流的缺口,再以目標延遲和維護條件測試。
- 模型標記匿名說話者與時間區段,逐字稿文字仍需 ASR。
- 緩衝設定不等於端到端延遲,公開評測也不能取代目標音訊測試。
- 先比較離線與串流的錯置、延遲和人工修正成本,再決定是否整合。
常見問題
Q1:Nemotron 3 Diarization 能直接輸出逐字稿嗎?
不能。它產生說話者活動及時間區段,逐字稿文字需由 ASR 等語音辨識元件提供,再依時間資訊對齊。
Q2:最多八位說話者代表所有多人會議都適用嗎?
不代表。八位是官方標示的支援上限,不保證每種人數、重疊程度、語言與收音條件都能維持相同表現,需使用目標音訊測試。
Q3:開放權重代表沒有授權與部署成本嗎?
不是。官方模型卡列出的使用條件依 OpenMDW License Agreement 1.1;硬體、整合、維護和資料治理仍需納入成本與流程評估。
Q4:說話者標籤能辨識發言者姓名嗎?
不能。模型輸出的匿名通道只能區分音訊中的說話者,若要連結姓名,須由應用端透過會議資料等資訊處理,且不能把通道標籤當成身分驗證。
參考來源
- NVIDIA (2026). *nvidia/Nemotron-3-Diarization · Hugging Face
- NVIDIA (2026). *Know Who Spoke When: Build Real-Time, Multi-Speaker AI with NVIDIA Nemotron 3 Diarization*. Hugging Face
- Medennikov I, et al. (2025). *Streaming Sortformer: Speaker Cache-Based Online Speaker Diarization with Arrival-Time Ordering*. arXiv
- Park T, et al. (2024). *Sortformer: A Novel Approach for Permutation-Resolved Speaker Supervision in Speech-to-Text Systems*. arXiv