很多人評估醫療 AI,第一個問題是模型準不準。但北京一項眼科門診部署經驗顯示,影像分析表現提高,仍須面對資料標註、操作流程和臨床需求是否接得上的考驗。AI-TEC 團隊整理的早期經驗中,專家標註影像對特定辨識任務的 AUROC 超過 0.93;另一項門診使用紀錄則顯示,AI 流程使用率曾只有 3.8%,介面簡化後的隔月提高至 23%。這些結果提供了醫療 AI 導入的觀察線索,不能直接當作病患治療成效已改善的證明。
一、AI-TEC實測回答的問題,不只在模型表現
AI-TEC 的部署經驗顯示,醫療 AI 要進入日常照護,需一併檢視資料品質、工作流程、人員參與和患者相關結果,單看模型指標不足以判斷成敗。
AI-TEC 全名為 AI-Agent Augmented Tsinghua Eye Clinic,是清華大學與北京清華長庚醫院團隊設計的眼科臨床框架。團隊在 2025 年 11 月將原型整合進院內日常流程,涵蓋診前資訊整理、分流、眼底影像分析、診療決策支援、患者衛教與追蹤。這種設計嘗試讓不同階段的資料和輸出能往下傳遞,減少各自獨立的 AI 工具留下的資訊斷點。
這篇刊載於《Nature Medicine》的文章類型是 Comment,內容為團隊對建置與真實場域部署經驗的整理,未採隨機對照試驗設計。它可以協助醫院辨認系統整合會遇到的問題,卻不能單獨證明這種架構適用於所有院所或眼科任務。研究團隊也提醒,臨床現場的參考診斷可能有不確定性,影像模型設定的疾病任務未必等同病患實際就醫原因。
因此,讀者在看這類醫療 AI 報導時,可以先辨認證據回答的是哪一層問題:模型在測試資料中能否區分影像、在門診是否有人實際使用,或使用後是否改變診療與患者結果。三者互相關聯,卻需要不同的資料和研究設計才能回答。把評論文章、部署觀察和臨床成效研究分開閱讀,較能看出目前證據支持到哪一步。
二、影像資料多,標註品質仍會改變模型表現
影像數量不能取代可判讀性和可靠標註;若影像品質或診斷標記不一致,模型學到的訊號也可能混雜,經專家檢視的資料可讓特定任務的區辨表現改善。
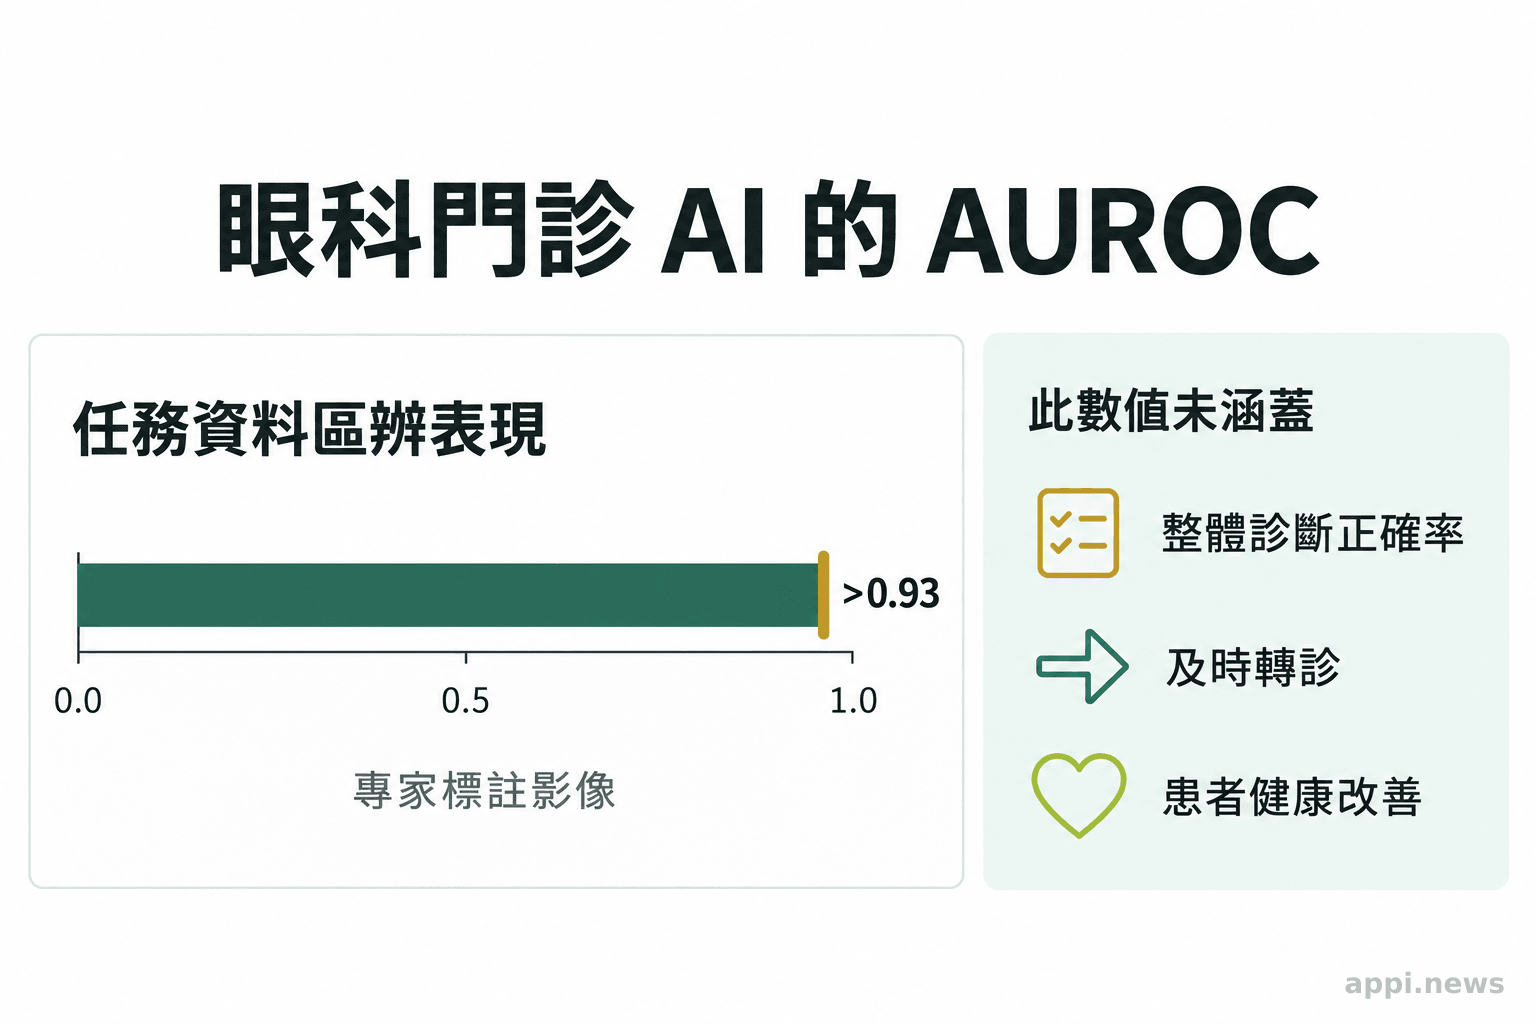
TechNews 報導指出,AI-TEC 團隊整理近 2.7 萬張品質與標註程度不一的眼底影像,再以 1,426 張由眼科專家精確標註的影像檢視模型表現;在該報導描述的特定辨識任務中,採用高品質標註資料後,AUROC 超過 0.93。解讀這組數字時,應把影像任務、資料來源和標註方式一起看,不能只留下「資料多」或「分數高」的結論。
AUROC 是 ROC 曲線下面積,用來衡量模型在不同判定門檻下區分陽性與陰性樣本的能力。數值愈高,通常表示在該測試資料裡,模型較能把兩類樣本排出高低;它不等於整體診斷正確率,也不直接回答漏診、誤報、轉診是否及時,更無法單憑一個分數證明患者健康結果變好。臨床採用還要看不同疾病、設備、影像品質與患者組成下是否穩定。
補充資料列舉了若干判讀分歧案例:嚴重糖尿病視網膜病變可能與視網膜靜脈阻塞難以區分,若缺少糖尿病病史,單看影像會少了重要線索;視神經盤反光也可能影響青光眼辨識。部分影像同時存在共病或次要診斷,AI 與參考標記不一致,不一定代表模型輸出全無臨床意義,仍需醫療人員把病史及檢查結果放在一起判讀。
三、使用率從3.8%升至23%,操作成本是重要線索
門診工作量下,額外點擊、重複輸入或切換系統都會增加操作成本;工具若不能融入既有步驟,即使模型表現良好,也可能很少被使用。
TechNews 報導引用門診使用紀錄:一段上線初期的五個月快照中,1,113 次檢查有 41 次使用 AI 流程,約 3.8%;團隊簡化操作介面、減少手動輸入後,隔月 1,126 次檢查中有 259 次使用,約 23%。分母與觀察時段不同,這是前後兩個期間的使用情形。介面調整與使用率回升同時出現,足以提示操作摩擦值得處理,但無法排除人員熟悉度、流程變動或其他同期因素,也不能據此宣稱介面改版單獨造成全部增幅。
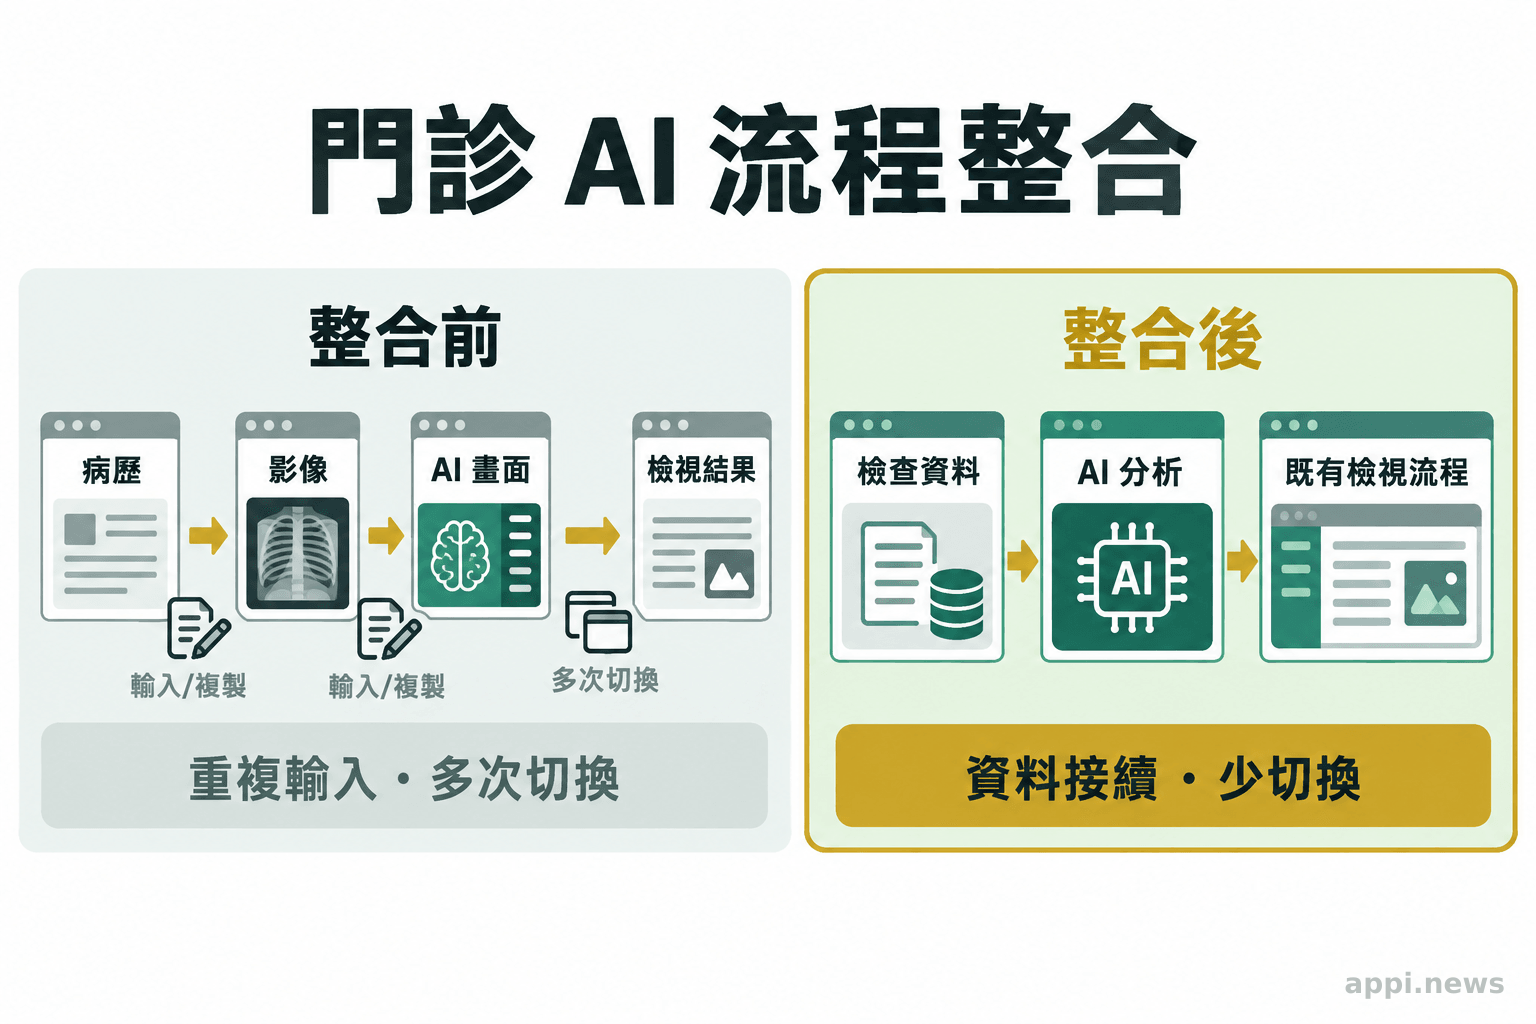
這背後的根因是工具增加了一個步驟,還是協助完成原有工作?若醫師得在病歷系統、影像工作站和 AI 頁面之間反覆切換,還要重打患者資料,使用 AI 便成為額外負擔。相反地,若既有檢查資料能在適當時間出現,輸出能直接進入醫療人員原本的檢視流程,採用門檻便可能降低。實際導入前可逐項確認觸發時機、主要使用者、輸入來源、結果呈現位置和看到異常後的責任人,找出每一個新增或重複操作。
因此,使用率是流程訊號,並非臨床效益的替代指標。使用率提高,可能表示操作較順或人員更熟悉;要判斷有沒有改善照護,還需追蹤判讀是否改變、錯誤能否及時攔截、轉診和追蹤是否完成,以及病患是否因此獲得適切處置。
四、影像辨識要接上病患需求與臨床角色
眼底影像辨識只處理診療流程的一部分;AI 輸出必須與症狀、病史及其他檢查結果對照,並明確指定由誰確認、如何處置和追蹤,才可能接近實際照護需求。
病患走進眼科門診的起點可能是視力模糊、疼痛、飛蚊增加,也可能是慢性病追蹤或例行檢查。影像 AI 從掃描結果辨認疾病特徵,與醫師從主訴、既往病史、檢查和患者目標綜合判斷,起始資訊並不相同。若系統只提供影像標籤,卻沒有說明結果適用的影像條件、可能的不確定性及下一步,輸出就不容易轉成照護行動。
補充資料描述的 AI-TEC 試行流程,先由臨床人員在看不到 AI 輸出的情況下提出初步診斷,之後再檢視 AI 預測,記錄其是否可能影響決策,最後提出診斷。這類設計可觀察輸出與臨床判斷的關係;但研究作者也指出,靜默試驗不會讓 AI 直接影響照護決策,因此無法完整衡量對醫師決策、醫療效率或患者結果的影響。評估時需分清楚「模型預測了什麼」、「醫療人員是否採納」和「患者後續是否得到適切處理」。
權責安排也要在試點前寫進流程。影像不足、病史缺漏、模型輸出矛盾或系統無法回應時,使用者應能辨認問題並採用既有人工流程;若結果需要轉診或加做檢查,要指定接收者與完成追蹤的責任。資料介接則須依院所制度確認用途、存取權限、紀錄留存和資安措施,避免病歷或影像在不清楚的權限邊界間流轉。
研究團隊在《Nature Medicine》摘要中指出,從 AI 輔助工具轉向更整合的照護模式,需要工作流程整合、臨床人員參與,以及可衡量的臨床價值。這項要求對台灣醫療機構同樣提供評估方向;具體介接方式仍須依現有病歷系統、設備和院內治理設計,不能把單一場域的架構直接視為通用標準。
「從 AI 輔助工具走向更整合的照護模式,需要工作流程整合、臨床人員參與,以及可衡量的臨床價值。」— Yan 等,《Nature Medicine》,2026(摘要中譯)
五、台灣醫療AI試點要同時看技術、流程與患者結果
試點應同時追蹤模型表現、資料品質、系統可用性、使用者負擔、錯誤處理和患者相關結果,並先界定每項指標的責任人與基準值,再討論是否擴大部署。
對醫療機構而言,AI-TEC 案例可轉成一組可執行的檢查問題:第一,輸入資料來自哪些設備和流程,影像品質及標註責任如何管理?第二,系統會在哪個時間點出現,結果由誰查看,是否要重複登錄資料?第三,模型失準或系統中斷時,如何回退到既有照護方式?第四,院內如何控管資料存取、稽核使用紀錄並處理資安事件?第五,除了辨識分數和使用率,是否追蹤後續檢查、轉診完成、工作負擔或患者結果?
評估設計最好先說明基準期間、觀察對象、任務範圍和資料缺漏處理方式。若只在部署後記錄使用次數,便難以辨認原先流程的瓶頸;若只比對模型預測與標記,也看不出資訊是否改變臨床行動。分階段試點可先確認資料與介接可靠,再檢視人員操作和錯誤處理,最後追蹤與患者照護有關的結果。每一階段均應預先定義何種情況暫停、修改或擴大使用。
清華大學研究團隊對 AI-TEC 的說明也提到,真實臨床落地仰賴資料品質、工作流程整合、臨床人員參與和持續迭代。這是部署經驗整理,並非已建立的臨床標準。醫療機構可以採用這些面向設計自己的評估表,再依疾病任務、患者族群和院內系統驗證結果。
資料治理同樣影響結果能否被信任。院方應能追溯影像來自哪種設備、使用何種標註規則、資料是否經過品質檢查,以及模型更新後由誰重新確認表現。若不同院區的攝影設備、病患年齡或疾病比例不同,整體平均分數可能掩蓋少數群體或特定影像條件下的退化。試點報告宜分層呈現關鍵族群及影像品質,並保留人工覆核和錯誤回報管道。
「在真實臨床實踐中導入醫療 AI,不只是演算法挑戰,也是涉及資料品質、工作流程整合、臨床人員參與與持續迭代的系統挑戰。」— 清華大學研究團隊,2026(官方研究介紹中譯)
醫療機構規劃試點前,可先完成以下盤點:
- 選定一段明確的臨床流程與目標任務,記錄現行資料來源、步驟及耗時基準。
- 指定資料品質、標註審查、AI 結果確認和後續處置的負責角色。
- 實測系統介接、輸入負擔、錯誤回報及故障時的人工替代流程。
- 同時追蹤模型指標、採用情形、工作負擔、轉介追蹤和患者相關結果。
- 依預先設定的安全與效益門檻,決定修改、暫停或擴大試點。
- AUROC 描述特定資料和任務下的區辨能力,不能單獨代表診斷正確率或患者效益。
- AI 流程使用率提高可提示操作摩擦減少,前後觀察仍不足以證明因果或健康結果改善。
- 醫療 AI 試點要把資料、流程、責任、資安和患者結果納入同一套評估。
試點若用於眼科照護,AI 輸出只能作為流程中的資訊或決策支援,患者仍應與醫療團隊討論判讀與處置。藥品或保健品交互作用不在醫療 AI 部署評估的討論範圍;孕婦、兒童、慢性病患者及長期服藥者如有眼部症狀或治療疑問,應依個人狀況向醫療人員確認,不以 AI 輸出取代專業判斷。
常見問題:醫療AI導入眼科門診怎麼判斷成效?
先分辨技術區辨能力、臨床採用情形與患者結果三種證據,再確認資料品質、工作流程和責任分工是否支撐預期用途。
常見問題
Q1: AUROC 超過 0.93,代表 AI 診斷準確率超過 93% 嗎?
不代表。AUROC 衡量特定資料及任務下的區辨能力,不能直接解讀成診斷正確率、漏診率或治療效果。臨床使用仍需查看敏感度、特異度、錯誤案例和適用條件。
Q2: AI 流程使用率升至 23%,是否證明患者受益?
使用率記錄的是流程採用情形。它可反映操作便利度或人員熟悉度,無法單獨證明診療決策或患者健康結果改善,需搭配後續照護指標評估。
Q3: 台灣醫院導入眼科 AI,第一步可以做什麼?
先挑選範圍清楚的臨床任務,盤點資料來源、現場步驟、使用者和錯誤處理方式,再訂出模型、工作負擔及患者結果的追蹤指標。
Q4: AI 眼底影像結果可以取代眼科專業判讀嗎?
不可以。影像結果需要結合症狀、病史和其他檢查,由醫療團隊依院內制度判讀及安排處置。患者有症狀或疑問時,應與醫療人員討論。
參考來源
- Yan T, Zhang D, Chen L, et al. (2026). Initial lessons from real-world implementation of an AI-agent eye clinic in China. *Nature Medicine
- Department of Automation, Tsinghua University (2026). Nat Med 2026 | Initial Lessons from Real-world Implementation of an AI-Agent Eye Clinic in China
- Peggy Tseng (2026). 中國首座「AI 眼科門診」實測,直擊醫療 AI 落地的三大痛點. *TechNews 科技新報