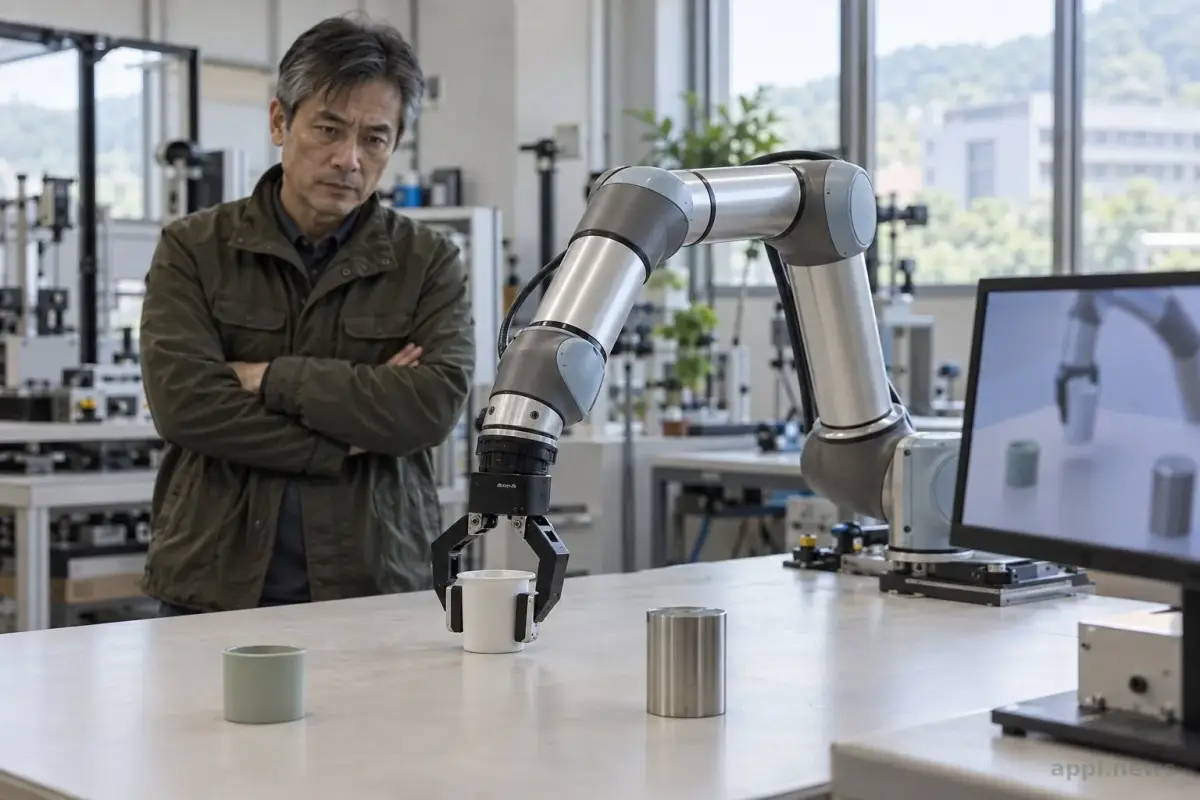
機器人訓練資料不足時,世界模型可以在虛擬環境生成互動經驗,讓策略先不占用實體設備反覆練習。不過,資料「看起來像真的」不等於機器人照著做就會成功;仍要確認模型預測是否符合目標設備的動作、感測與接觸結果,以及能否通過小規模實機驗收。
很多人第一個會先想到,真實資料不夠就用世界模型多生成一些。這個方向確實有研究展示,但要先問前一步:模型依據哪些真實互動學習?生成軌跡涵蓋了哪些失敗情境?它預測的是畫面,還是足以支撐控制的物理狀態?這些答案決定了合成資料補上的缺口,也決定它不能替代哪些現場測試。
一、機器人訓練為什麼缺資料?
真實機器人的示範與試錯需要設備、操作時間和安全監督,難以快速涵蓋所有物件、位置、光線及失敗情境;因此缺口在資料數量,也在情境覆蓋與罕見錯誤。
機器人的資料通常是感測器觀察、機械臂或移動底盤的動作,以及動作之後環境如何改變。要收一筆資料,實體設備得真的移動、碰觸物件,再由人或控制程式確認任務結果。若要學習抓取不同材質的杯子,還得考慮尺寸、表面摩擦、杯中重量、擺放角度和遮擋。每次重置場景、重新示範都要付出設備與人力成本。
安全限制也會讓資料不平均。研究人員不會任由機械手臂以各種力道撞擊物件,生產線也不可能為了蒐集資料一直中斷流程。結果是常見且安全的動作較容易取得,卡住、滑落、碰撞、抓取失敗等例子反而稀少。模型若只練過成功路徑,換到稍有差異的物件或起始位置,可能就無法判斷如何修正。
因此,擴大資料量不代表已補足缺口。導入者要先列出任務需要的狀態與錯誤類型,再找出最難取得的樣本。若瓶頸是相機視角變化,增加相似抓取畫面幫助有限;若接觸力與滑動結果不準,增加逼真影像也未必改善控制。
二、世界模型如何在模擬環境生成練習經驗?
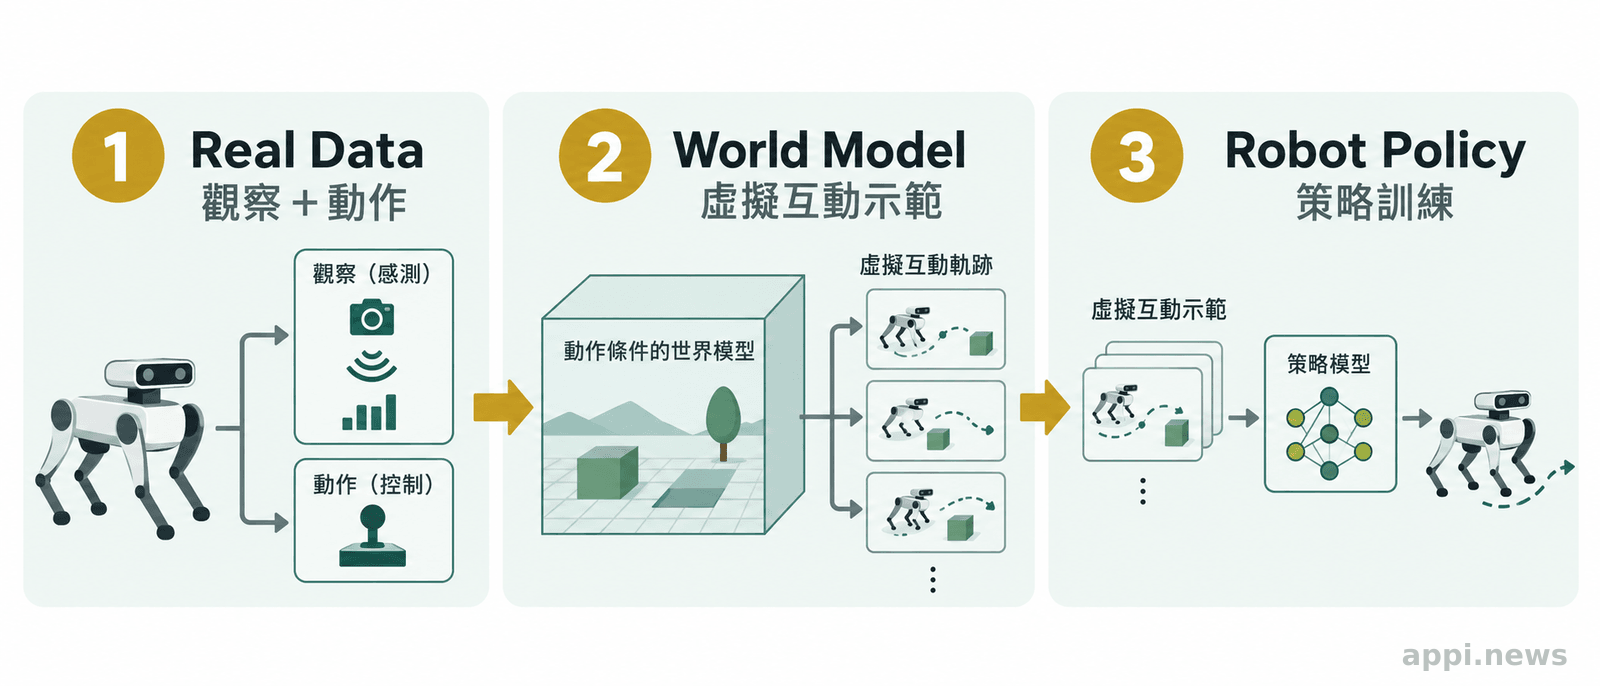
世界模型根據既有觀察與機器人動作,預測環境接下來會如何變化,再把生成的互動軌跡用於示範收集、策略訓練或初步評估;它仍從有限的真實資料起步。
「世界模型」在機器人研究中有多種實作。本文討論的一種做法,是以機器人互動資料訓練「動作條件式影像預測模型」:輸入目前看到的畫面與下一個動作,模型生成動作後可能出現的畫面。使用者可在生成環境中控制虛擬機器人,收集虛擬示範,再用這些示範訓練模仿學習策略。模仿學習是讓模型從示範軌跡學會動作選擇。
Wang 等人 2026 年的 arXiv 預印本 Interactive World Simulator,先以真實機器人互動資料建構影片預測模型,再在生成環境收集示範。測試包含抓杯、整理繩索、推動物件和掃動物件堆等桌面操作;作者報告,在這些任務中,世界模型生成資料訓練的策略,表現可與同量真實資料訓練者相比。研究也發現,測試任務的模擬與實機策略表現呈正相關。
「在測試的操作任務中,世界模型生成資料訓練的策略,表現與同量真實資料相近。」— Wang 等人,Interactive World Simulator(2026)
這項結果說明,世界模型有機會把一部分示範蒐集移到虛擬環境,讓研究者快速比較策略。但它不表示系統從零開始就能生成可靠經驗:模型先前仍以真實互動資料學習,能生成什麼也受訓練資料與模型表達能力限制。論文作者並將延伸至更多環境、複雜操作,以及研究資料量和算力如何影響效能列為後續方向。
三、世界模型和物理模擬器差在哪?
常見物理模擬器以明確設定的物理引擎計算物件運動和接觸;本文所說的世界模型則從資料學習動作與觀察結果的關聯,並可直接預測影像。兩者都有模型誤差,適合處理的問題不完全相同。
物理模擬器將重力、摩擦、碰撞、關節限制等條件放入引擎,再依機器人動作計算下一個狀態。工程師可調整參數、讀取狀態變數,並改變物件位置或物理條件來訓練策略。這種方式便於測試明確的動態與控制問題;若引擎參數和實際世界有落差,模擬成功仍可能在實機失敗。
資料驅動的世界模型則學習影像或潛在狀態如何隨動作改變。它可能保留畫面細節,也能讓人以視覺方式收集互動示範;但若模型只預測影像,畫面中物體接觸的位置合理,不代表內部的力、摩擦或物件形變已準確建模。換言之,像素逼真度、物理可信度和策略可遷移性是不同的驗收問題。
兩種方法也可以組合。例如先用物理模擬器大量探索,再用少量真實資料修正策略;或用世界模型產生視覺示範、用實機檢查接觸結果。選擇依據應是目標任務的誤差來源、所需觀察方式與設備條件,而不是把「世界模型」或「物理模擬」當作單一標準答案。
| 做法 | 主要產生方式 | 可先處理的工作 | 主要待驗證差異 |
|---|---|---|---|
| 物理模擬器 | 依物理引擎與設定參數計算狀態 | 動作控制、狀態探索、改變物理條件 | 摩擦、碰撞、致動器和感測器與實機的差異 |
| 世界模型 | 從互動資料學習動作後的狀態或影像 | 視覺互動、虛擬示範、策略候選比較 | 生成內容是否符合真實接觸和長時間互動 |
| 真實資料微調 | 在目標設備上補充示範或試錯 | 修正目標設備上的策略偏差 | 樣本成本、安全範圍與場景涵蓋程度 |
四、模擬訓練如何遷移到實際設備?
常見做法有直接遷移、用少量實機資料微調,以及模擬與實機交替校正;任務愈仰賴精準接觸與受力,愈需要在目標設備上檢查並修正策略。
直接遷移是先在模擬環境訓練,接著把策略部署到實機測試。流程簡單,適合用來檢驗模擬是否已涵蓋目標任務,但零樣本遷移無法預先保證成功。
2025 年 ICLR 的 Simulation-Guided Fine-Tuning 研究指出,任務若需要精確且對力敏感的操作,直接從物理模擬遷移可能失敗。研究以模擬學到的價值函數引導實機探索,並在五種實際靈巧操作任務中測試。論文報告其方法比基準微調方法所需的真實樣本最多少一個數量級,但這是該方法與該組任務的結果,不能直接推成所有世界模型或機器人都能減少相同成本。
「模擬到真實世界的直接零樣本遷移仍有挑戰,尤其在精確且對力敏感的操作任務。」— Yin 等人,ICLR 2025
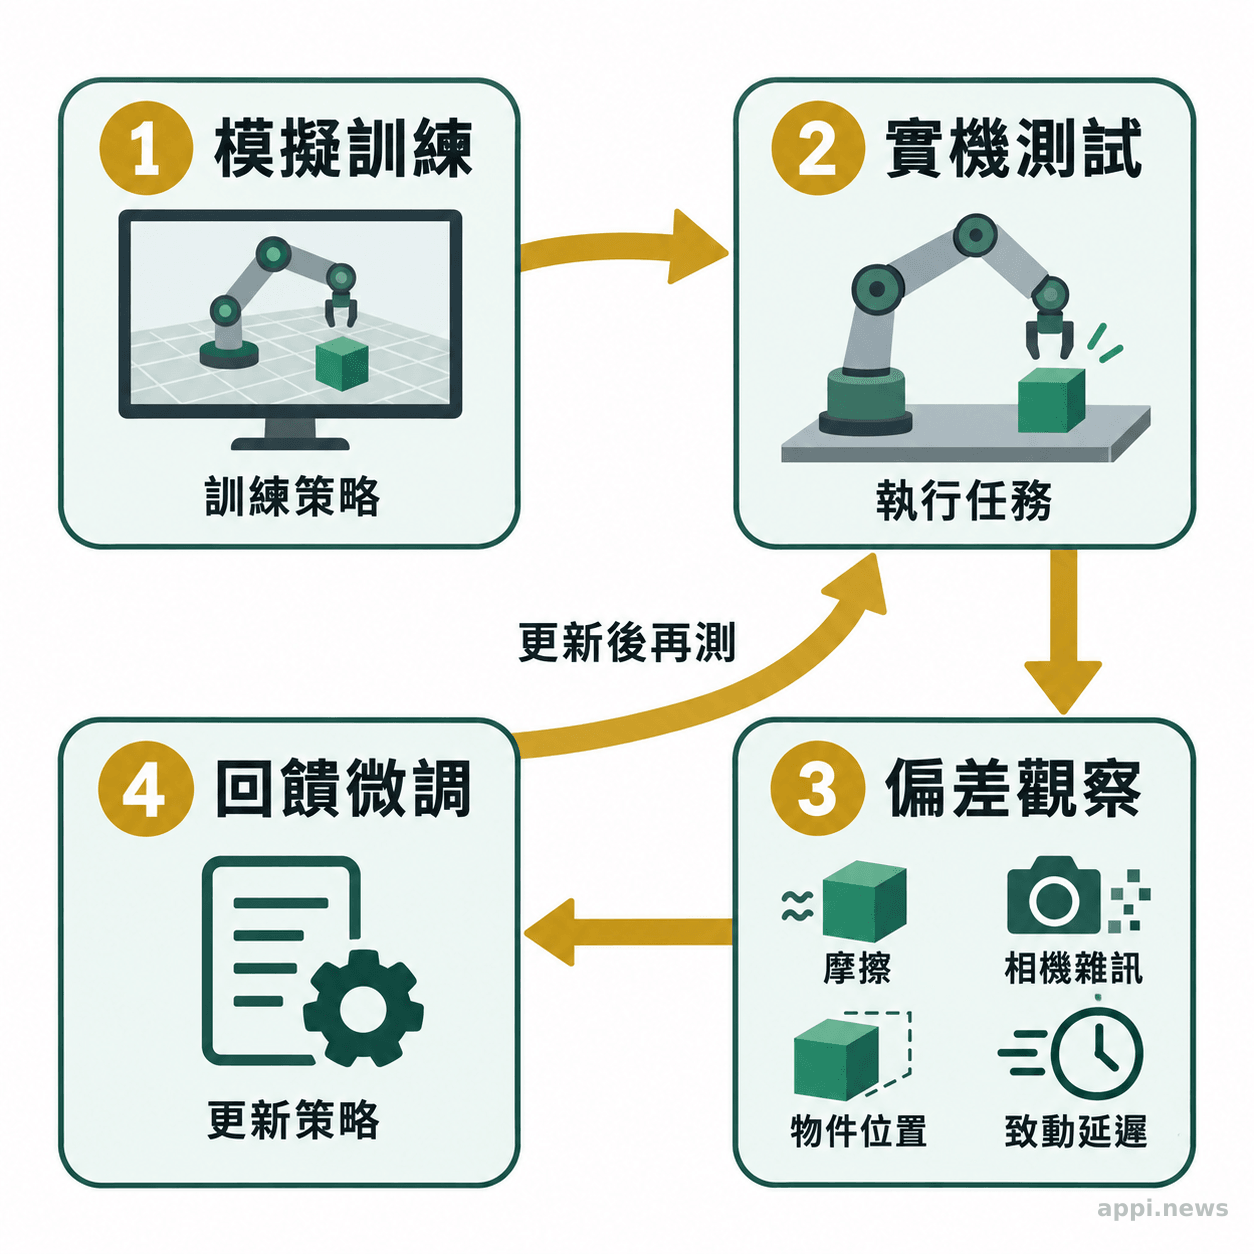
第二種方式是模擬預訓練後,以少量目標設備資料微調。實機樣本可讓策略看到真正的相機噪聲、夾爪反應、物件滑動和操作延遲。第三種方式則在模擬與實機間交替:模擬先提出候選動作或擴大狀態覆蓋,實機測試再找出偏差,更新資料或模型。
Zhao 等人的 2020 年綜述整理深度強化學習機器人的模擬到實機遷移方法,包括領域隨機化、領域適應、模仿學習、元學習和知識蒸餾。Annual Review 的 2026 年回顧也將領域隨機化、真實到模擬、狀態與動作抽象,以及模擬實機共同訓練列為處理現實落差的途徑。
「模擬到真實落差」指虛擬環境與實際設備的觀察或動態不一致。差異可能來自摩擦、物件重量、夾爪間隙、感測器噪聲、光線、遮擋、控制頻率或延遲。世界模型生成的影片若在長時間預測中逐步偏離真實狀態,錯誤會沿著連續動作累積;動作策略就可能在後續步驟建立於錯誤的物件位置或接觸狀態上。
五、導入前要驗收哪些項目?
先鎖定單一任務、設備與場景,再以未參與訓練的物件和起始條件測試成功率、失敗型態及安全界線;模擬結果只能篩選候選策略,最終遷移判斷仍需目標實機測試。
驗收前先定義任務完成條件,例如物件是否放入指定區域、抓取後是否保持穩定、操作時間是否在可接受範圍。也要把失敗定義具體化:掉落、碰撞、錯誤抓取、超出安全力道、需要人工介入,各自如何記錄。若只比較單一平均成功率,策略可能掩蓋少見但後果嚴重的錯誤。
接著比對生成環境和部署環境。機器人型號、工具、相機角度、光線、物件材質、桌面摩擦與控制頻率都可能影響結果。測試應納入模型未見過的物件或位置,避免訓練與驗收使用同一批場景而高估表現。無法在模擬中重現的變化,應列為實機測試項目。
再來要確認生成經驗的內容是否符合任務需求。若目標是抓取,需檢查手指接觸點、遮擋後的物件狀態、夾持力和滑落情境;若目標是推動或整理物件,則要看物體碰撞後是否依合理方向移動、堆疊如何改變、物件是否會形變。模型可能生成視覺上自然但動作結果不合物理規律的片段,因此不能只由人工觀看幾段影片判定可信。
評估應比較同一策略在世界模型、物理模擬和實機的成功率、任務時間、失敗類型與安全事件,也要記錄訓練資料量。若研究聲稱省下實機資料,須與同量真實資料和既有方法比較,並交代任務、設備及測試條件。
- 選定一項可清楚判定成功或失敗的任務,固定機器人、工具與測試場景。
- 列出模擬與實機差異,挑出高風險條件和模型未見過的測試案例。
- 先在模擬環境篩選策略,再安排小規模實機測試,記錄成功率、失敗型態、介入次數與安全事件。
- 設定停止、回退和重新訓練條件;只有在目標設備與任務都達到門檻後,才擴大部署範圍。
六、常見問題:世界模型能取代真實機器人訓練嗎?
現有研究顯示它能在特定操作任務中補充或部分替代真實示範,但世界模型仍以既有互動資料建立,且生成經驗與目標設備之間可能有落差,因此不能省略實機驗收。
常見問題
Q1:世界模型生成的資料算真實資料嗎?
不算。它是模型根據既有資料和動作生成的虛擬觀察或互動軌跡。訓練時可作為合成資料使用,但需要另外測試它是否代表目標設備會遇到的狀態。
Q2:畫面很逼真,代表策略可以直接上機嗎?
不代表。畫面相似度沒有涵蓋所有力學、感測與控制誤差。應檢查任務結果、接觸狀態和失敗案例,再以實機測試確認策略遷移。
Q3:世界模型和物理模擬器只能選一種嗎?
不一定。物理模擬器可用來探索物理條件,世界模型可從互動資料生成視覺經驗,也可以用實機資料補足兩種模擬的偏差。怎麼組合須依任務和可取得的資料決定。
Q4:導入評估最先該看什麼?
先確認研究任務、機器人硬體和部署場景是否接近自己的條件,再比較模擬與實機的成功率、失敗類型及安全表現。若測試只在單一物件或理想光線下進行,結論就應限於該範圍。
- 世界模型可用虛擬互動經驗擴充特定任務的訓練資料,生成品質受真實資料、任務範圍和模型誤差限制。
- 畫面預測準確、模擬策略表現佳,都不能單獨證明能遷移到不同的實際設備。
- 導入前先固定任務與設備,以未見條件做小規模實機驗收,並設定失敗與安全回退門檻。
參考來源
- Wang Y, Syed R, Wu F, et al. (2026). *Interactive World Simulator for Robot Policy Training and Evaluation*. arXiv:2603.08546
- Zhao W, Queralta JP, Westerlund T. (2020). Sim-to-Real Transfer in Deep Reinforcement Learning for Robotics: a Survey. *IEEE Symposium Series on Computational Intelligence*, 737–744
- Yin P, Westenbroek T, Cheng C-A, et al. (2025). Rapidly Adapting Policies to the Real-World via Simulation-Guided Fine-Tuning. *International Conference on Learning Representations (ICLR 2025)
- Aljalbout E, Xing J, Romero A, et al. (2026). The Reality Gap in Robotics: Challenges, Solutions, and Best Practices. *Annual Review of Control, Robotics, and Autonomous Systems*, 9, 403–432