
目錄(5 節)
OpenAI於2026年11月18日發布的研究加速報告指出,AI代理獨立完成「人類預估需二至四小時」研究任務的估計成功率,從3月的23%升至10月的46%。但監看訓練與撰寫推論服務程式的表現,差距仍大。
但這裡要先問一個更前面的問題:團隊準備交出去的工作,究竟需要代理執行步驟,還是判斷研究結果值不值得繼續?這會影響驗收方式,也決定人應該在哪裡介入。
二至四小時任務成功率,代表代理能做什麼?
46%是OpenAI內部對該工時組別任務的零人工介入成功率估計;工時指人類完成任務所需的時間,並非代理實際連續運作的時長。
23%到46%增加了23個百分點,數值為原來兩倍。這個比較描述的是任務成功率變化,不能解讀成整體研究效率翻倍,更不能直接換算成可減少多少人力。
報告屬單一研究組織的內部觀察,任務分派、模型與代理工具都會變動;研究者也可能逐漸把不同工作交給代理。因此,前後月份的差異同時反映能力與使用方式,不能視為同一套固定考題的純模型進步。
對準備導入的台灣研發團隊,可先把「做研究」拆成能單獨交付的工作,例如整理一次實驗結果、定位一個錯誤或修改一段程式。若連交付物都無法描述,就難以知道代理究竟完成了什麼。
這也涉及程式代理與軟體交付的衡量差異:產生程式只是流程中的一站,仍要確認結果能否被下一位同事重現、使用與維護。
為什麼同樣是研究工作,能力落差這麼大?
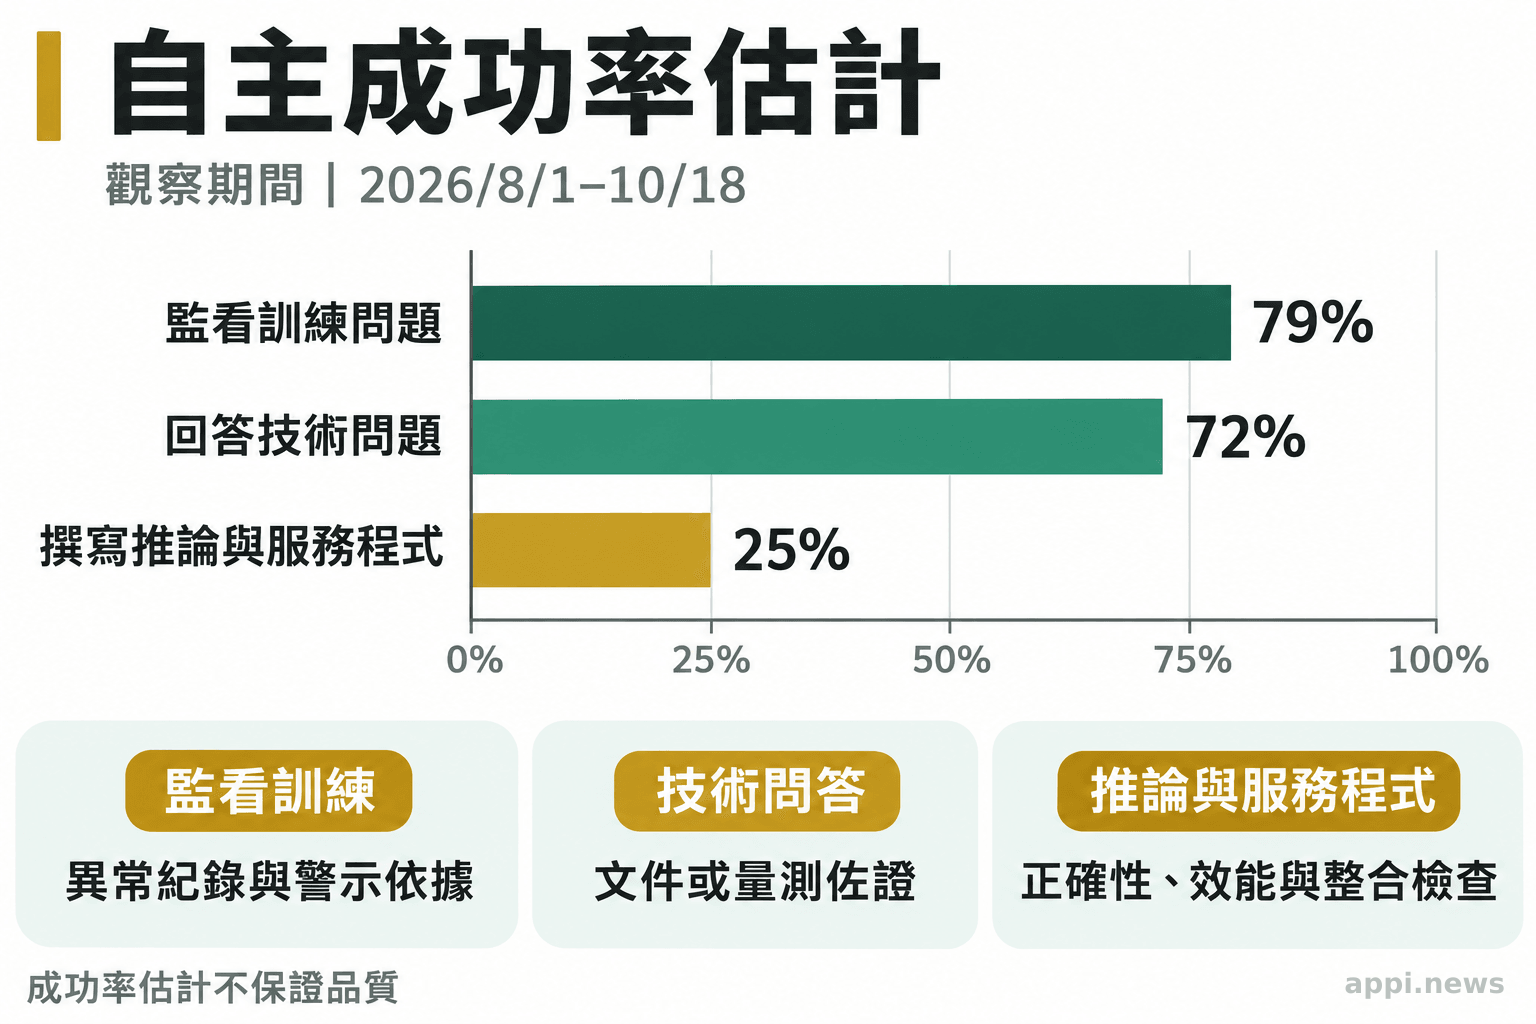
OpenAI在2026年8月1日至10月18日的任務分類中,估計監看訓練問題的自主成功率為79%,回答技術問題為72%,撰寫推論與服務程式為25%。這些數字對應不同任務,不能互當品質保證。
| 報告中的任務 | 估計零介入成功率 | 團隊試行時可檢查的交付物 |
|---|---|---|
| 監看訓練執行中的問題 | 79% | 異常紀錄、告警依據與漏報情形 |
| 回答技術問題 | 72% | 答案能否由文件或實測支持 |
| 撰寫推論與服務程式 | 25% | 正確性、效能及整合檢查結果 |
成功率來源為OpenAI十一月報告;右欄是導入評估建議。
推論是讓已訓練模型產生輸出的運算;服務程式則負責把這些能力提供給其他系統。這類程式即使能執行,也可能在負載、資料格式或既有系統的交界出錯。
為什麼工時相近,交付難度仍不同?一個可供團隊檢驗的解釋是:任務需要多少隱含背景,以及錯誤多久才會浮現。告警可以對照紀錄,架構選擇的代價卻可能要整合後才看得見。這是流程判讀,不能從上述比例單獨證明原因。
分派時可加上一個問題:「同事要看到什麼證據,才能接受這份結果?」若答案只是代理說完成了,驗收條件就還需要補足。
人類介入,應放在研究流程的哪裡?
人類先界定研究問題與接受標準,代理負責可交付的執行工作,再由人類判讀結果及決定下一步。執行途中協助與最後驗收,應分別記錄。
OpenAI的九月研究加速報告提供了前一階段的例子:過去六個月中,成功的四至八小時任務,超過一半涉及至少一次人工介入。該分析排除結果不確定的分類,不能把「成功」一概讀成獨立交付。
OpenAI九月報告指出,人類仍設定研究優先順序,判斷哪些想法與結果值得追求。(意譯)
團隊可以把介入分成補充背景、修正方法與處理環境問題。若每次都需要資深同事重設研究方向,代理節省的可能只是部分操作時間;若只是補一個檔案位置,改善輸入資料或許就能減少中斷。
驗收也要有人負責。實驗順利跑完後,仍須確認對照條件、資料版本與結果是否回答原問題,才決定是否擴大。關於人工覆核與流程驗收的安排,重點是先指定誰有權接受成果,避免責任隨著工具輸出而消失。
METR外部評測,為何不能直接與OpenAI比高低?
RE-Bench是研究工程基準測試,使用指定環境與評分目標;OpenAI報告觀察內部實際委派的工作。兩者的任務、時間定義及評分方式不同,分數不能直接排名。
METR在2024年發表的RE-Bench研究,設計七個機器學習研究工程環境,收集61名專家的71次八小時作業紀錄。任務包含縮短程式執行時間等明確目標,讓人類與代理在相近條件下比較。
該研究發現,短時間預算下代理較有優勢,人類則更能從增加時間中改善成績。研究也採用多次嘗試取最佳結果的評估方式,因此總預算不必然等於單一代理連續工作的時長;這是2024年受測系統的結果,不能當作2026年的能力上限。
METR以總電腦使用時間計算預算,例如八小時可用於一次八小時嘗試,也可拆成十六次半小時嘗試。多數環境允許執行者自行取得評分回饋,再挑選成果;這使「如何分配嘗試」也成為受測流程的一部分。團隊比較工具時,可固定總預算,並同時呈現單次表現與挑選後的結果,讓選擇成本可見。
METR研究提醒,在評測環境中勝過人類,仍不足以證明能在實務上自動化AI研發。(意譯)
外部評測的用途,是提供另一種可檢查的測量方式。採購或試用工具時,可要求供應商交代任務樣本、重試次數、人工協助與失敗紀錄,再選取團隊自己的工作測試。
只展示最好的一次,會漏掉平時必須處理的返工;只看平均分數,也可能遮住少數代價很高的錯誤。驗收資料應保留成功、失敗與無法判定三種結果。
導入AI代理前,先回答哪四個問題?
先檢查輸入輸出、可重現性、失敗成本與總成本。挑一項反覆執行且結果可檢查的工作,小範圍試行後再決定是否擴大。
- 輸入輸出是否明確?寫下可用資料、可修改範圍及交付物,讓執行者與驗收者使用同一份任務說明。
- 結果能否獨立重現?保留資料版本、執行指令與檢查方法,交由另一位同事驗證。
- 失敗成本有多高?先測試可回復的工作;涉及正式環境、資料刪改或大量運算支出時,預先設定停止與人工核准條件。
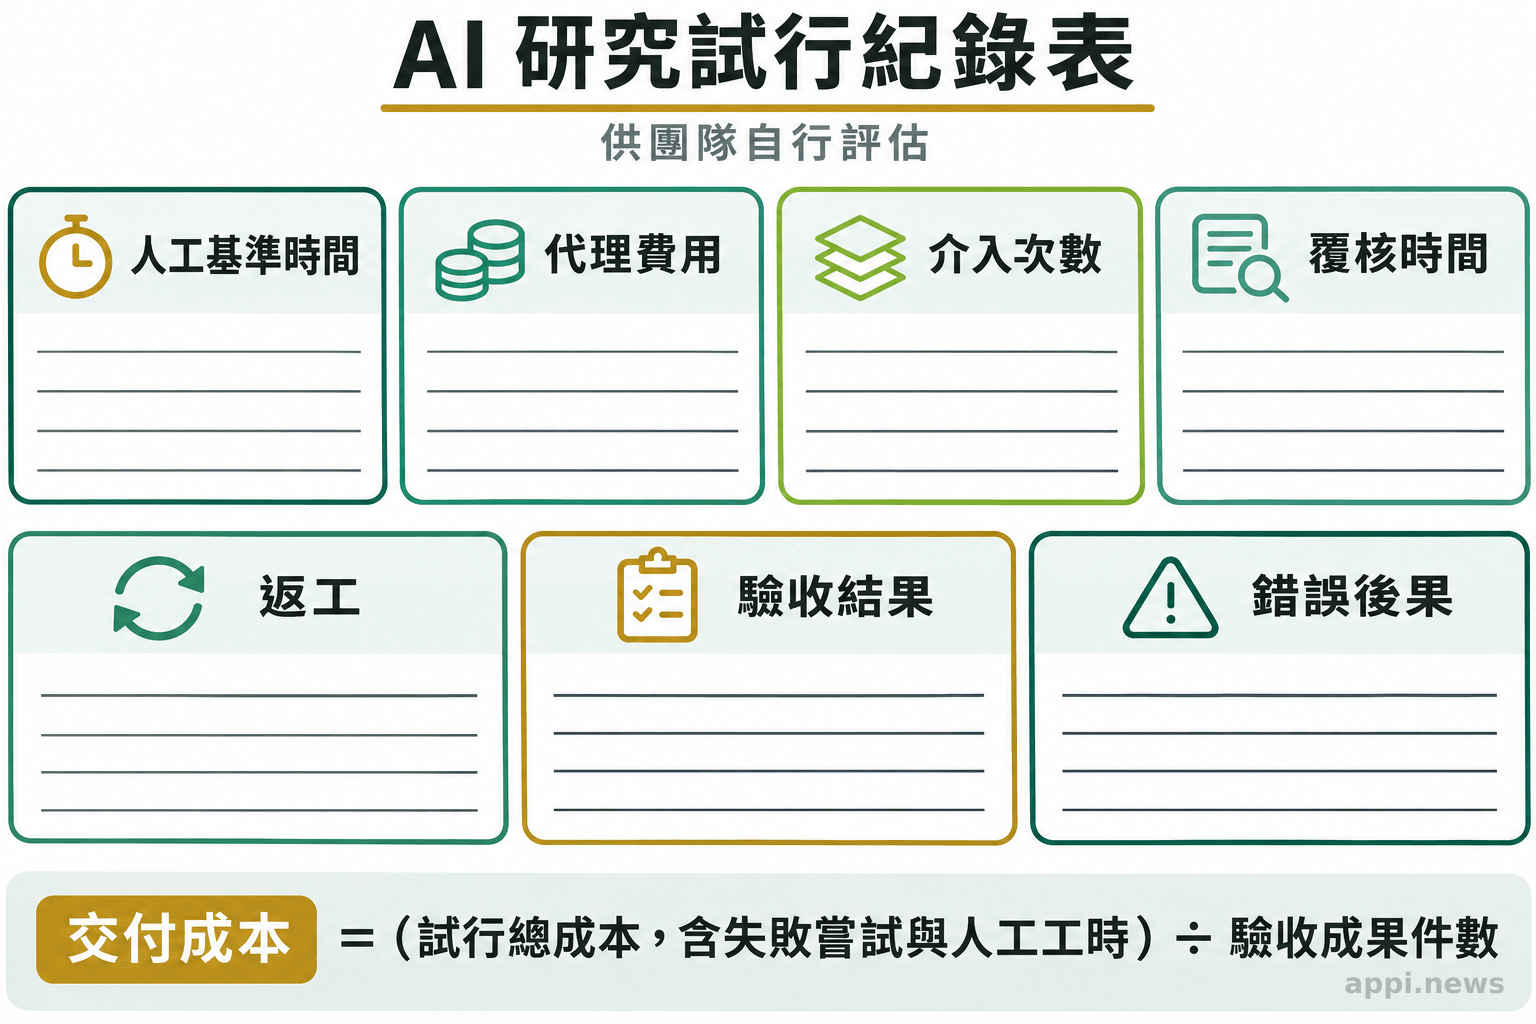
- 省下的時間是否抵銷總成本?同時記錄任務說明、介入、覆核與返工工時,加上代理及實驗運算費用。
具體試行可參考METR的一項任務:在不改變程式行為的前提下,縮短模型微調腳本的執行時間。微調是以既有模型繼續訓練,使它適應特定資料或任務。這項設計把速度目標與行為限制放在一起,避免只以執行時間判斷成果。
沿用這個思路,台灣研發團隊可挑一支已有正確性檢查的內部腳本,先保存原始版本、測試資料與硬體設定,再讓代理提出修改。驗收者應先確認輸出符合原先約定的誤差範圍,檢查是否跳過必要計算,通過後才比較耗時;這是試行建議,成效需由團隊實測。
測試資料也可分成代理能反覆查看的開發樣本,以及驗收者保留的樣本。兩組都檢查,才能辨認修改是否只適用於反覆調整過的輸入。若速度改善卻增加維護負擔,紀錄表應留下新增依賴、閱讀修改所需時間與回復原版的方法,供負責人決定是否採用。
可用「每件驗收通過成果的成本」比較兩種流程:把試行期間所有成功與失敗嘗試的費用,以及人工工時成本加總,再除以驗收通過件數。若尚無成果通過,先回查失敗原因,避免用低單次價格掩蓋反覆重做。
紀錄時另留一欄「錯誤後果」:同樣花十分鐘修正,拼字錯誤與錯用實驗資料的影響不同。若模型或工具更新,保留版本與原任務重新測試,才知道改善發生在哪裡。
- 用可交付的任務選擇代理工作,再為每類任務設計驗收證據。
- 把獨立成功、介入後成功與結果不明分開,保留重試及失敗紀錄。
- 從一項可重現工作開始,同時比較品質、總成本與錯誤後果。
常見問題
Q1:AI代理可以獨立完成整個研究專案嗎?
部分任務的成功率不足以支持這個結論。完整專案還包含研究方向、跨任務整合與結果判讀,應分段確認責任及交付條件。
Q2:46%成功率能套用到公司的工作嗎?
不能直接套用。任務來源、資料與工具環境不同,應用自己的工作樣本建立人工基準,再測代理流程。
Q3:代理需要人工協助,還值得使用嗎?
要看協助與覆核耗時、通過驗收的成果及總成本。低介入次數也可能伴隨一次很昂貴的修正,不能只數次數。


