
程式模型能不能修好程式,不能只看它生成一段程式碼的能力,還要看它能否理解程式碼庫、找到失敗原因、呼叫工具修改檔案,最後用測試確認結果。JetBrains 開源的 Mellum 2.1 正是往這個工作流程前進:官方稱它能探索程式碼庫、編輯檔案並檢查修改。
JetBrains 自行公布的 SWE-bench Verified 解決率,從前代 2% 升至 47%。這是明顯進步,但仍略低於同設定測試的 Qwen3.5-9B 之 50%,也不能直接換算成團隊專案的修復成功率。
一、程式代理要走完探索、修改與驗證
程式代理除了產生程式碼,還要能操作工具、讀取程式碼庫並根據檢查結果調整修改。 模型只是工作流程中的推理與生成元件,實際可做什麼取決於外接工具及權限設定。
單次程式碼生成通常從明確提示開始,模型輸出程式片段後由開發者自行貼上、編譯和測試。代理式程式設計則多了幾個環節:讀取專案檔案與錯誤紀錄、透過命令列執行測試、定位可能原因、提出差異檔,再重新執行檢查。程式碼庫探索,是代理搜尋相關模組、設定與測試的能力;工具呼叫則讓它能使用 shell、檔案讀寫或測試指令。這些能力必須由模型與代理框架共同提供。
JetBrains 將 Mellum 2.1 的用途描述為代理系統中的工作模型,可負責「找出失敗測試的根因、草擬並檢查修補」。這是官方產品定位,並不表示模型單獨啟動後就能讀取任何人的程式碼,也不代表它已經有執行命令的權限。團隊要自行接上工具,並設定可讀寫的目錄、可執行指令及批准流程。JetBrains 官方介紹說明了這種定位與訓練方向。
一個可控的修復流程,至少應把「提議」和「採用」分開。代理產生差異檔後,先由測試、靜態分析或人工檢視找出錯誤,再決定是否合併。若測試未通過,應讓流程停下並回報失敗,不可將模型回覆視為修復完成。這個界線也方便追蹤問題源頭:錯在模型理解、工具介面、測試覆蓋,還是權限與環境。
二、Mellum 2.1 的改變在後訓練與工具任務
JetBrains 表示架構維持不變,主要把更新投入後訓練,尤其是強化學習與代理式軟體工程任務。 訓練時模型在真實程式碼庫環境使用 shell 與檔案編輯工具,並依測試結果取得回饋。
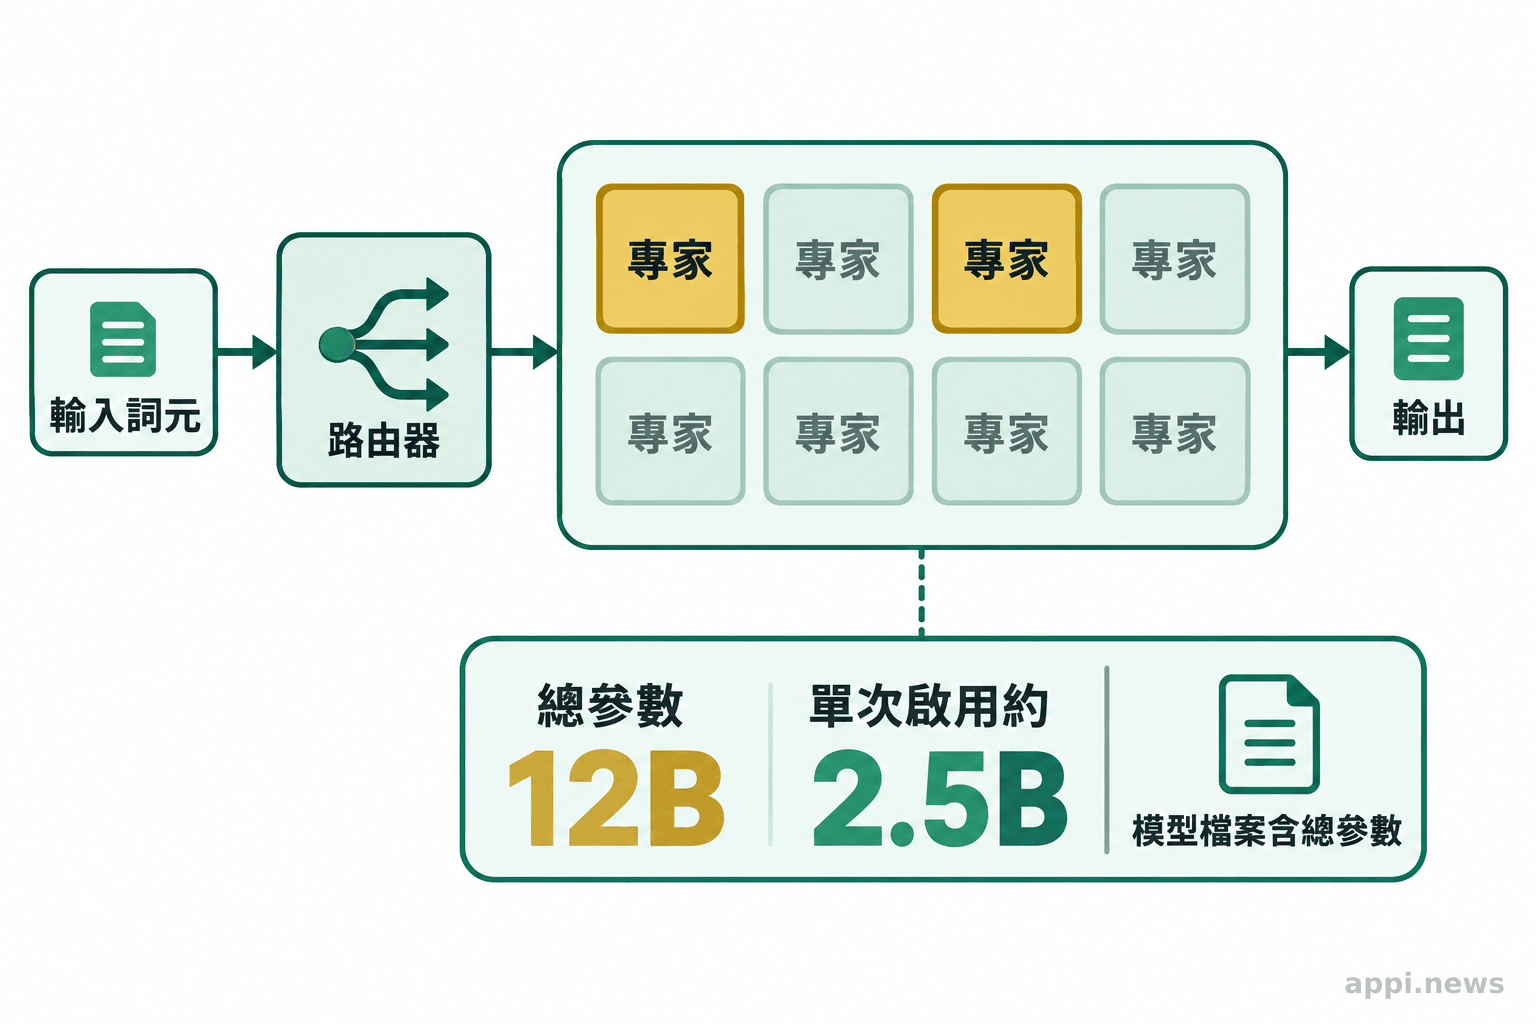
Mellum 2.1 是 120 億參數的混合專家模型(Mixture of Experts,MoE),每個詞元約啟用 25 億參數。MoE 會按輸入選用部分專家網路參與計算;「啟用參數較少」說明每次推論的計算方式,並不表示下載檔案只含 25 億參數。官方模型卡列出 131,072 個詞元的最大上下文長度,讓模型在適用設定下可處理較長的程式碼與對話脈絡;實際可用長度及記憶體需求仍取決於推論引擎與執行設定。
強化學習(Reinforcement Learning,RL)是讓模型依行動結果調整策略的訓練方法。JetBrains 表示,2.1 的 RL 不再只是訓練末段的一小部分,而成為後訓練的主要工作;資料包括數學、競賽程式設計、科學、工具使用和軟體工程任務。
軟體工程訓練在程式碼庫中進行,模型使用命令列和檔案編輯工具,測試通過會成為回饋訊號。官方提到訓練期間執行了數百萬次沙箱任務,但這描述的是訓練規模,不能視為每項程式任務都已被驗證。
Mellum 2.1 因此較適合被理解成程式開發代理中的工作模型或子代理,例如受託查看一組錯誤測試、找出可能相關的檔案、草擬小範圍修補,再把變更與測試結果交回主流程。它本身不會取代代理協調器、命令執行環境、版本控制和審核程序。
三、47% 修復解決率是評測結果,不是專案保證
JetBrains 公布的 SWE-bench Verified 解決率由 Mellum 2 的 2% 升到 Mellum 2.1 的 47%,顯示它在該測試設定下的代理式修復能力進步;同表 Qwen3.5-9B 為 50%。 這些是廠商自行評估的基準結果,不能直接推算真實團隊的修復率或節省工時。
SWE-bench Verified 是以真實軟體專案的問題與測試為基礎,衡量模型能否提出通過指定測試的修改。Mellum 2.1 官方模型卡指出,代理評測採用同一套 Pi v0.73.1 開源代理框架,提供 shell 與檔案工具,設定 114K 上下文,並限制每回合輸出量。
模型卡也說明數據由 JetBrains 使用相同流程評估,數值為 JetBrains 自行回報。官方模型卡列出的 SWE-bench Verified 成績,Mellum 2.1 為 47.0、Mellum 2 為 2.0、Gemma 4 E4B 為 23.0、Qwen3.5 9B 為 50.0;在 SWE-bench Pro,Mellum 2.1 是 28.0,Qwen3.5 9B 是 38.0。
「所有模型都由 JetBrains 使用相同流程評估;所有數值均由 JetBrains 自行回報。」這項註記適用於解讀表中的比較結果。— JetBrains,Mellum 2.1 官方模型卡
同一設定有助比較這幾個模型在該代理框架中的表現,但不等於獨立第三方重現,也不代表你的程式庫、測試品質、語言組成和工具設定與基準相同。SWE-bench Verified 的 47% 是評測題目的解決比例,不是「任意專案的修復成功率」,更不是有 47% 的程式缺陷都會被自動修好。評測結果受題目難度、上下文、工具能力、採樣方式與成功判定條件影響。
其他基準也呈現不同強弱:JetBrains 模型卡列出 Mellum 2.1 在 LiveCodeBench v6 為 82.0,高於同表 Qwen3.5 9B 的 75.4;但在 SWE-bench Verified 與 SWE-bench Pro,Qwen3.5 9B 分別為 50.0 與 38.0,高於 Mellum 2.1。比較時要看任務類型,不能抽一個分數推論全面勝出。
速度數據也有條件限制:JetBrains 指出單張 H200 的高負載測試中,Mellum 2.1 吞吐量接近 Qwen3.5-9B 的兩倍;使用多詞元預測(Multi-Token Prediction,MTP)時,單一請求約快 1.6 倍。這是官方硬體與測試條件下的結果,不宜當作一般桌機的速度承諾。
四、先交付範圍小、可以回復的程式任務
先從範圍明確、結果能由測試判斷、錯誤可以回復的任務開始。 複雜跨模組修改、涉及部署或資料安全的變更,應保留開發者審查與批准。
可先評估的工作包括:依錯誤訊息搜尋可能相關檔案、解釋一組失敗測試、提出小幅度修補草案、補上單元測試,或在代理流程中擔任快速子任務。這些工作適合試行的條件,是有清楚輸入、可觀察輸出,而且測試或人工檢查能確認它是否完成。
任務描述也應限定檔案範圍與變更目標,避免代理為了修一個測試而擴大改寫。團隊可以先讓它只讀取某個模組,再逐步開放在臨時分支寫入;每次任務要求它回報改了哪些檔案、採取了哪些工具操作,以及哪些測試仍未通過。這些記錄能協助區分模型誤判與工具設定問題,也讓審查者不必只憑自然語言摘要判斷成果。
高風險任務則包括大範圍重構、認證與權限邏輯變更、資料庫遷移、刪除檔案、部署到正式環境,以及測試覆蓋不足的關鍵模組。這些工作往往需要跨檔案理解、組織內部規則和產品脈絡。模型可能提出語法正確但破壞既有行為的修補,也可能因測試不足而誤判成功。遇到此類工作,應將代理產出限制在建議或差異檔,交由熟悉系統的開發者核准。
「Mellum 2.1 在代理式程式設計方面,相較 Mellum 2 的進步幅度最大。」— JetBrains,Mellum 2.1 發布文章
這段定位說明 JetBrains 本次更新想改善的方向,不會自動回答模型是否適合某一團隊。實際適配度要看工作流程:代理能否取得正確上下文、工具是否提供必要操作、失敗時能否停止,以及審核者能否快速辨識風險。
五、自架之前要核對授權、格式與執行資源
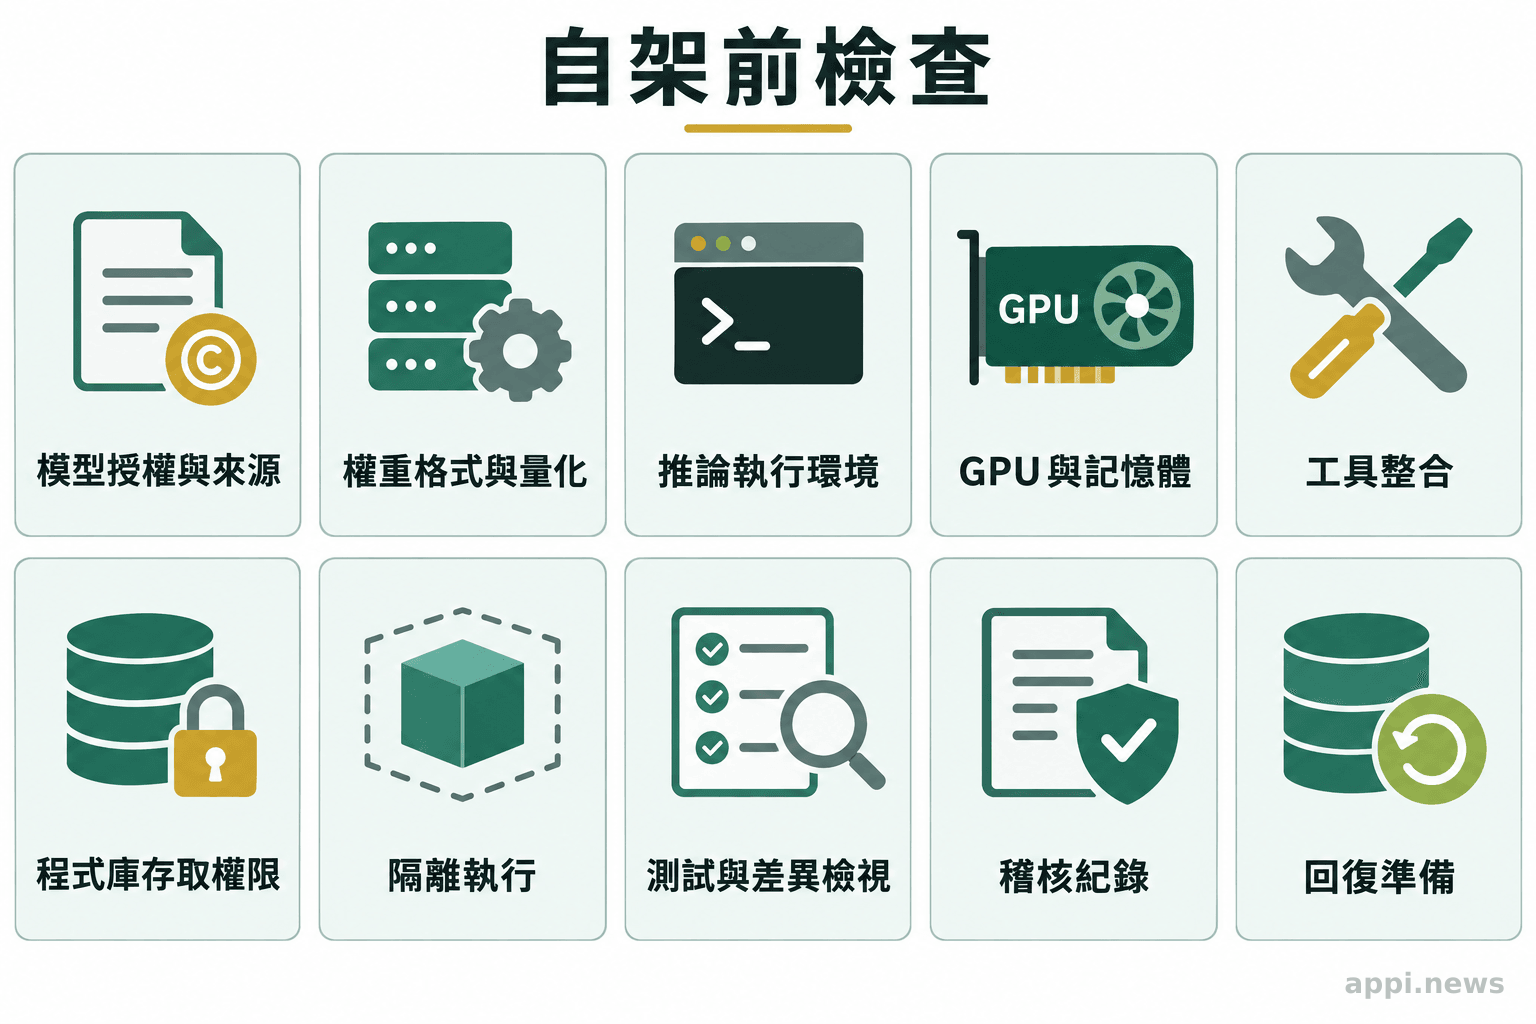
Mellum 2.1 的官方模型權重採 Apache 2.0 授權,支援的部署格式與整合方式正在增加;下載權重不代表每種推論框架、硬體和代理工具都已相容。 導入前需按實際版本逐項確認。
目前官方 Hugging Face 模型卡提供 safetensors 權重與 vLLM 使用方式,也列有啟用工具呼叫的設定;官方 GGUF 儲存庫已提供量化版本,可搭配 llama.cpp、Ollama、LM Studio 等支援 GGUF 的執行工具。GGUF 模型庫列出 BF16、Q8_0、Q6_K、Q4_K_M 與 MXFP4_MOE 等權重格式。
以官方頁面標示的檔案大小為例,BF16 約 24.3 GB,Q4_K_M 約 8.1 GB,MXFP4_MOE 約 7.0 GB。這只是模型檔案,不含上下文快取、執行框架、作業系統和其他服務所需記憶體;尤其長上下文可能增加額外資源需求。量化會以較低精度儲存權重以減少檔案與記憶體占用,品質與速度仍應以目標任務實測。
自架的價值在於增加部署者對程式碼、提示和執行環境的控制選項;它不會自行建立權限政策,也不等於零資料風險。若模型可讀取程式碼庫或執行命令,應限制可存取目錄與工具權限,採隔離環境執行,避免提供不必要的憑證或機密。模型生成的修改可能有錯,也可能在日誌或提示中暴露敏感內容,因此要檢視差異、執行測試、保留操作紀錄並準備回復方式。
授權也要分層檢查。JetBrains 模型卡標示模型權重為 Apache 2.0;但部署產品還可能包含轉換後權重、推論程式、代理框架、程式碼索引和外掛,各自可能有不同授權或使用條款。應核對實際下載來源、版本及整合元件,不能只憑「開源」兩字判斷整個系統的商用條件與支援狀態。
六、用內部基準決定是否擴大使用
挑一組常見、可回復的失敗測試,在隔離環境比較它與現行工具,並同時記錄修補正確率、測試通過率、定位時間及人工檢查成本。 確認權限與回復機制後,再逐步擴大任務範圍。
評估前先固定測試題目、模型版本、代理框架、工具設定與執行硬體,否則數據無法比較。可挑選近期常見、歷史上容易重現且已有預期結果的缺陷案例,分成語法錯誤、測試失敗、局部邏輯錯誤等類型,避免只挑模型容易處理的題目。
除了記錄是否通過測試,也應記下代理修改了哪些檔案、是否碰觸任務範圍以外的內容、人工花多少時間檢查,以及失敗後能否乾淨回復。若只統計「成功修好幾題」,可能忽略它為了通過測試而引入的副作用。定位時間可從收到任務到提出可審查差異計算;人工成本則包含審閱、補測與修正代理產出所花的時間。這些指標才能顯示模型是否讓既有流程變得更有效率。
接著設置基本治理條件:使用隔離分支或沙箱、給予最小必要讀寫權限、限制命令清單、保留差異與執行紀錄,並規定哪些操作必須由開發者核准。模型或工具出錯時要能停止流程並回復變更。這些措施同時幫助釐清責任:模型提出修改,代理框架執行,測試提供訊號,開發者決定是否合併。沒有明確分工,便很難判定問題是模型輸出、環境設定還是審核流程造成。
若測試結果不理想,應先拆解失敗原因,再決定是否換模型。代理若找錯檔案,可能需要補充檢索或索引;若修改正確卻未通過測試,需檢查測試環境與任務描述;若工具呼叫錯誤,則應檢查格式和權限。這種逐層排查能避免把整個問題歸因於模型,也能確認團隊實際需要改善的是哪一段工作流程。
- Mellum 2.1 的主要更新是後訓練與代理式程式任務能力;模型本身仍需搭配工具和代理框架。
- SWE-bench Verified 47% 是 JetBrains 自行公布的基準成績,Qwen3.5-9B 同表為 50%,兩者都不能直接代表你的程式庫表現。
- 本地部署前核對權重格式、硬體與推論框架;程式碼存取須採最小權限、隔離執行、差異審查、測試及回復。
常見問題
Q1:Mellum 2.1 會直接修改整個程式庫嗎?
不會只因下載模型就取得程式碼庫存取權。代理流程需接上檔案與命令工具,團隊應限定可讀寫路徑和可執行操作,並設定人工批准點。
Q2:本地部署是否代表程式碼完全沒有資料風險?
不代表。資料可能經由代理工具、日誌、遠端推論服務或錯誤設定流出;應確認資料流向、權限、記錄與網路設定,並只提供任務所需內容。
Q3:47% 的解決率可以當作團隊導入後的預期修復率嗎?
不可以。它是特定基準題目及代理測試設定下的廠商自評結果。應用自家代表性任務建立基準,並檢查測試通過與修改品質。
參考來源
- JetBrains. (2026). *Mellum2.1 Gets to Work: A Fast Open Model for Coding Agents - The JetBrains Blog
- JetBrains. (2026). *JetBrains/Mellum2.1-12B-A2.5B-Thinking · Hugging Face
- JetBrains. (2026). *Mellum2.1-12B-A2.5B-Thinking-GGUF*. Hugging Face
- 李建興(2026)。〈JetBrains開源Mellum2.1模型,程式修復評測解決率從2%升至47%〉。《iThome》


