
目錄(5 節)
SnapLogic 表示,其代理 Jean-Paul 將季度業務檢討資料準備時間從 8 至 10 小時縮短到 20 分鐘。這是公司自家平台與流程的案例,不能歸因於 Muse Ember;其他團隊可先界定重複整理步驟,再驗收輸出。
Meta 於 2026 年 11 月 9 日公布 Muse Ember,定位為供大量重複工作使用。Meta 說明它可承接較大型代理流程中的子代理任務、工具呼叫與路由。官方 API 一般費率每百萬輸入 token 為 0.10 美元、輸出為 0.50 美元。低輸入價格帶出導入問題:哪些工作能明確驗收,錯誤又由誰接手?
可參考Meta Muse Wonder 長任務代理的評估方式;Muse Ember 則偏向大量重複子任務。只比較輸入單價,容易漏算輸出、重試、工具與人工處理。
一、Muse Ember 適合接哪一段代理工作?
Meta 將 Muse Ember 定位為處理高頻重複工作的執行模型,可承接代理子任務、工具呼叫與路由;實際表現仍須依工作流程測試。
Meta 將它放在大型模型規劃、小型模型處理工作量的分工裡。可拆出的子任務包括讀取指定欄位、依規則分類、從文件擷取資料,再交回主代理整合。若工作需理解模糊目標或自行決定跨系統的下一步,低價無法證明它適合擔任主要決策者。
Meta 在自家評測中公布,Muse Ember 在 Agents’ Last Exam 的 Linux 子集、max reasoning 設定下得分為 61.6%。Meta 註明這是內部評測結果;測試集、工具環境和評分方式都會影響分數,因此不能直接當成企業實際任務的成功率。
同樣是 Muse 系列,任務分配、授權範圍和工具入口會改變代理實際能做的事。若團隊正在研究代理可接觸哪些資料與操作,先看入口與授權邊界;模型價格無法取代權限界定。
二、哪些 AI 代理重複任務適合先交給小型模型?
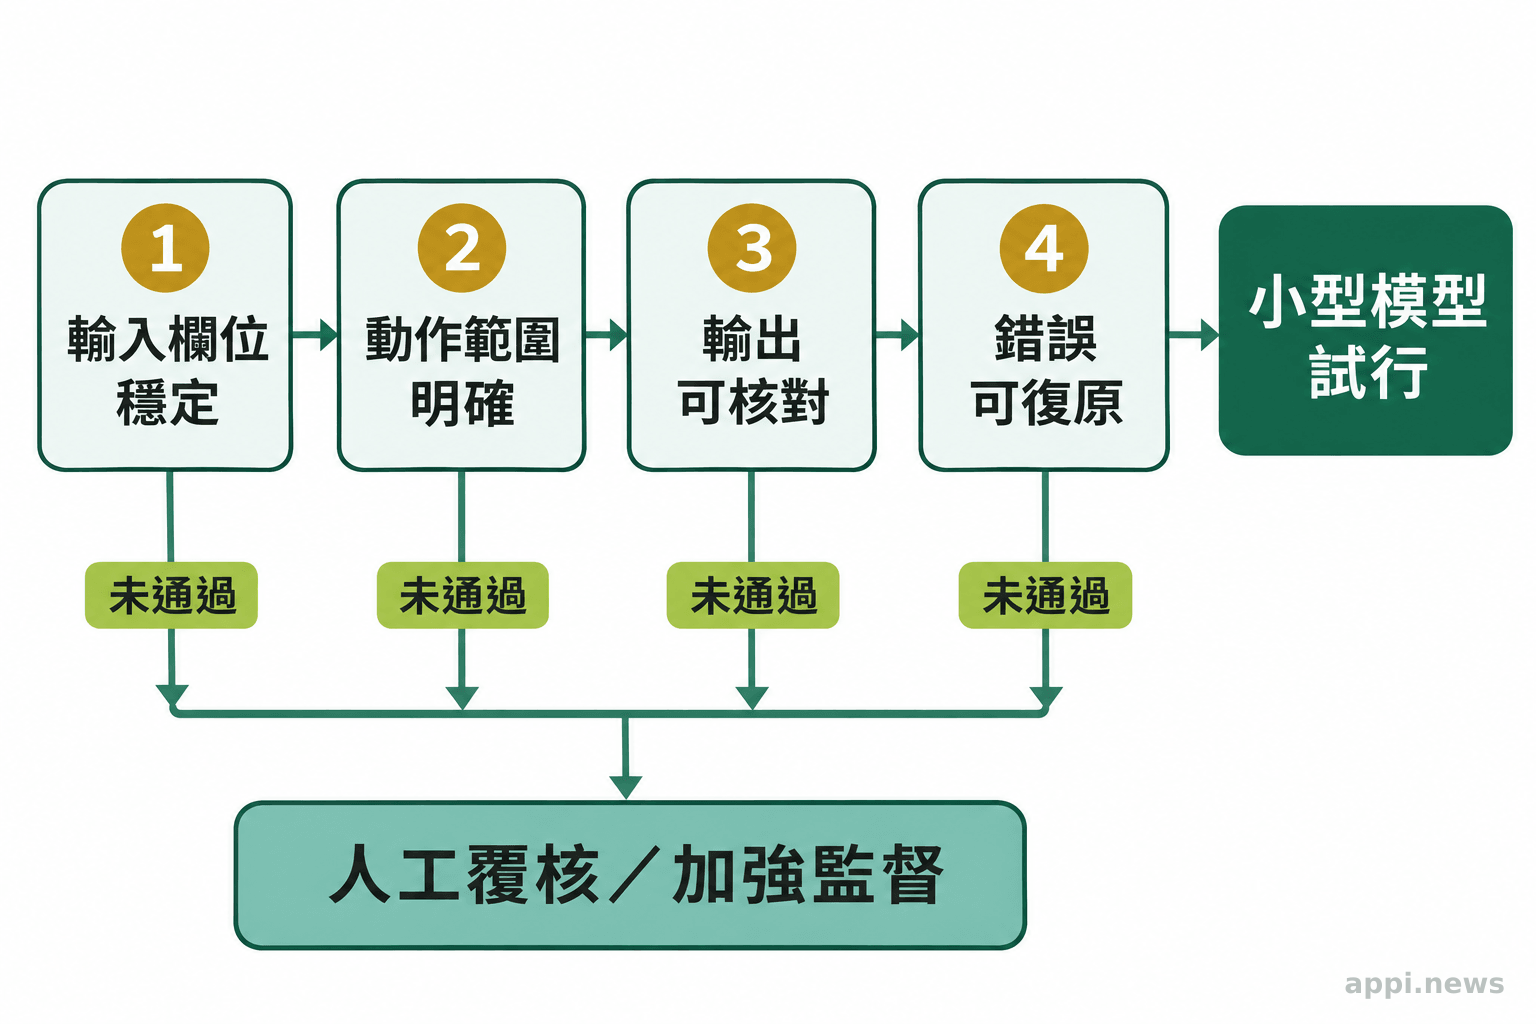
輸入格式穩定、步驟可以描述、輸出有明確檢查方式,而且失敗可以復原的任務,較適合先做小型模型試行。
可先檢查四項:輸入是否固定,例如客服單欄位一致;任務是否有界,例如只分類、不自行退款;輸出能否用規則或抽查驗證;錯誤能否復原。若操作會寄出承諾、刪除資料或改動正式紀錄,就須有人監督。
IBM 的 AskHR 專頁稱,系統可處理 94% 的常見員工詢問,支援服務單較 2016 年減少 75%。這是 IBM 的企業流程案例,不能歸因於小型模型或 Muse Ember,也不是其他團隊的成效保證。它呈現的自動化條件包括常見問題、整理過的知識與轉人工流程;知識更新和例外處理仍需維護。
SnapLogic 稱,其代理 Jean-Paul 串接 Salesforce、Zendesk、BigQuery,將季度業務檢討資料準備時間從 8 至 10 小時縮短至 20 分鐘,並在一個 30 天期間回收 2,141 小時。這是公司對自家平台與流程的說明,未經第三方審計,也不能歸因於 Muse Ember。試行前應確認資料可否連接、步驟是否明確、結果由誰核對。
SnapLogic 執行長 Brad Stewart 將完成後的體驗描述為:
「幾分鐘內就能收到整理完成的答案,而不是一個還得自己搜尋處理的結果。」Brad Stewart,SnapLogic 執行長。
若任務包含多步推理、例外處理或高影響決策,小模型可以先整理資料,再交由較強模型或人員判斷。任務是否「重複」不是唯一判準;關鍵在每次輸入和驗收標準是否足夠一致。
試行範圍宜先小後大。先挑一種資料來源、一個任務類型和一組明確的成功條件,並保留原流程作為退回路徑。抽查樣本時可分開記錄格式錯誤、漏抓欄位、錯誤分類與越權操作,因為這些錯誤的處理方式不同。若只算整體正確率,少數高風險失誤可能被大量簡單任務掩蓋。
三、每百萬輸入 token 0.10 美元,代表總成本比較低嗎?
不能。輸入價格只涵蓋計費的一部分,輸出 token、長上下文、重試、工具呼叫及整合與驗收人力,都會改變單次任務成本。
Meta 官方定價頁列出一般請求的輸入每百萬 token 0.10 美元、快取輸入 0.004 美元、輸出 0.50 美元。輸入超過 200K token 時,整筆請求改按長上下文費率:輸入 0.30 美元、快取輸入 0.012 美元、輸出 1.50 美元。網頁搜尋等工具也可能另計費,應依使用模式核對帳單。
成本試算要合計輸入、輸出、快取、工具、重試與人工時間。長對話若持續帶入先前內容,輸入量可能超過預期;常需重跑、校正或補資料,也會拉高整體成本。
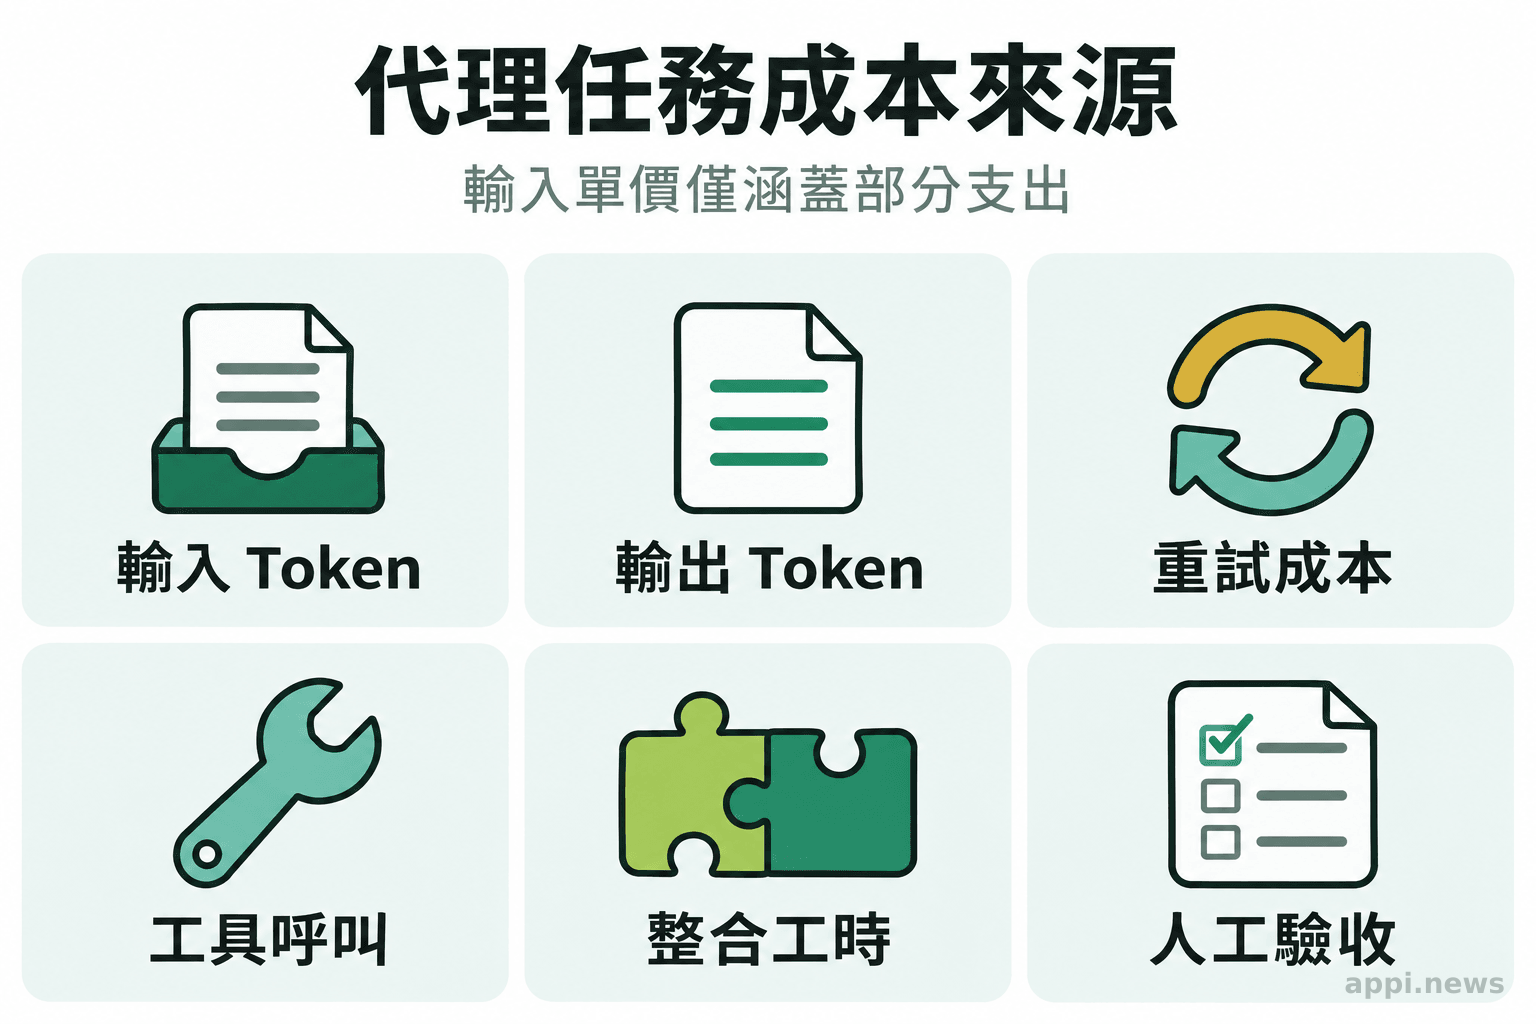
代理成本也包含整合。SnapLogic 的案例仰賴既有平台與連接器,部署才得以在數天內開始;尚未串接系統的團隊,還要估算欄位整理、權限建置、監控與稽核工時。
| 評估項目 | 小型模型先試的情況 | 需要提高把關的情況 |
|---|---|---|
| 輸入與步驟 | 欄位固定、步驟可重複 | 資訊缺漏、每次都需大量判斷 |
| 輸出驗收 | 可用規則、比對或抽查確認 | 沒有明確正確標準 |
| 錯誤後果 | 可回復、可重跑 | 會對外承諾、付款或改寫正式資料 |
| 成本來源 | 模型與工具用量已記錄 | 重試、人工覆核與整合工時未計入 |
四、如何把小模型放進既有代理流程?
先定義可委派的子任務、最低驗收條件與升級路徑,再限制模型能讀取和改動的範圍。
由主代理或既有系統拆出有界步驟,交給小型模型處理。結果應附分類、擷取內容、來源位置及失敗原因,再依格式、規則與抽查結果決定接受、重試或升級。信心分數不能單獨作為放行條件。
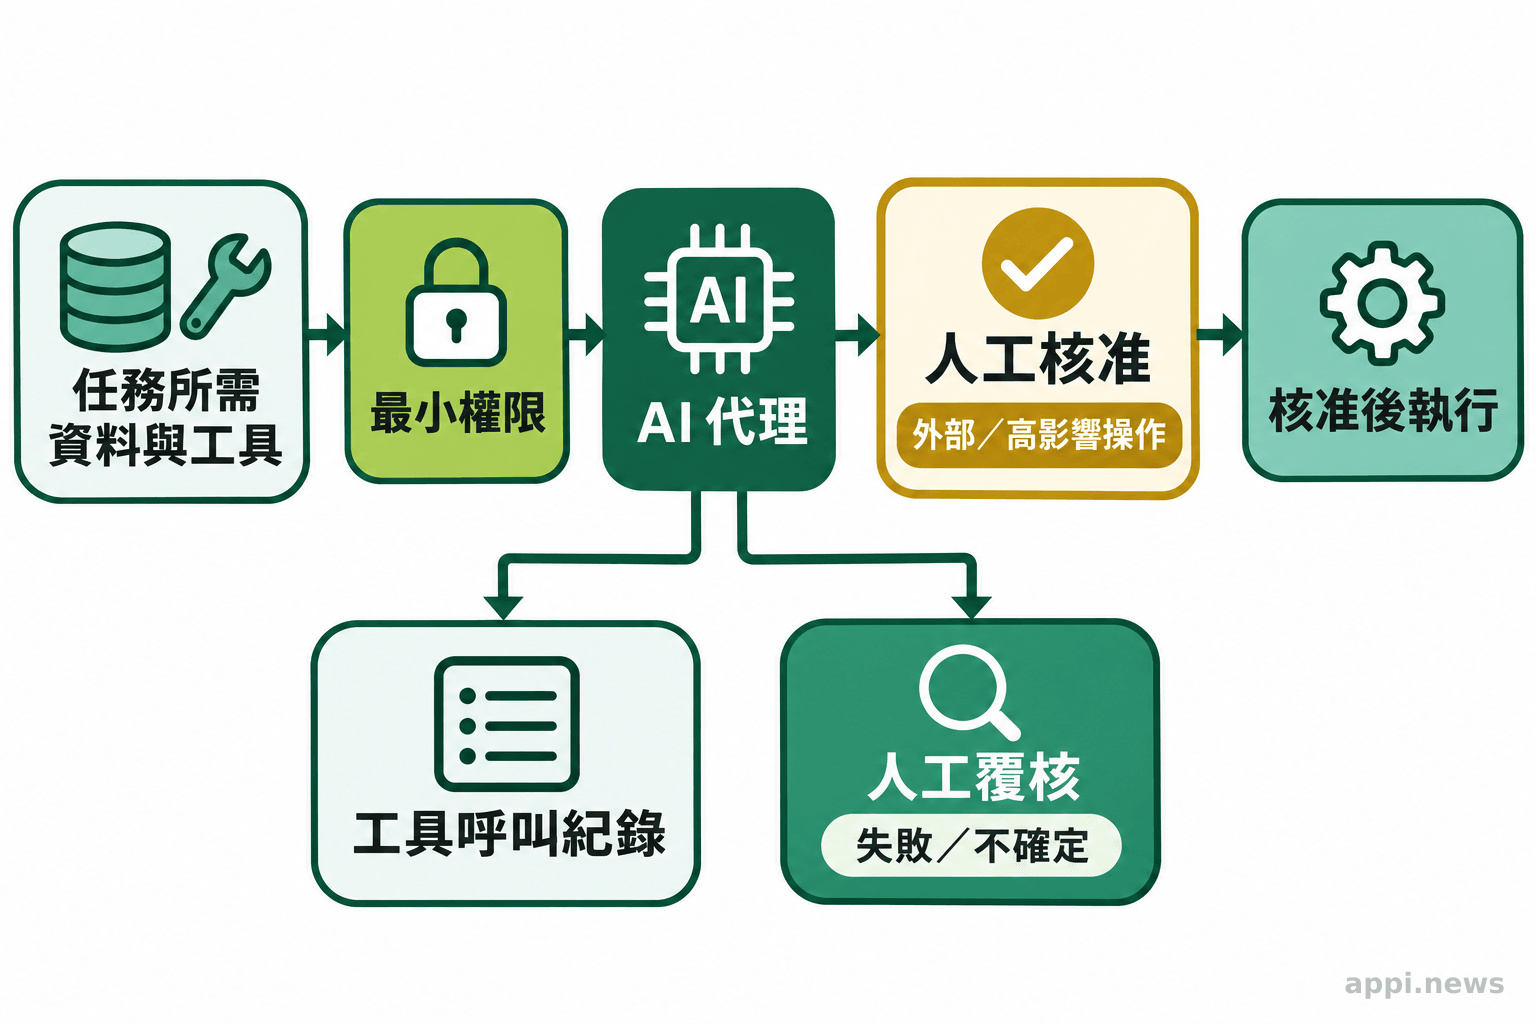
若模型能呼叫工具,就要把工具權限限縮在任務需要的範圍。例如讀取可用於分類的資料,不代表也應取得刪除或寄送權限;可能改動外部系統的操作,應先採草稿或待核准模式,並保留呼叫紀錄。這能讓錯誤有跡可循,也能在流程偏離時查出是哪個步驟造成影響。
資料條款也要在接入前確認。Meta 區分 Standard 與 Contributor 模式;後者以允許將輸入內容和模型回覆用於未來訓練,換取折扣或更多用量。Muse Ember 官方文件標示為 Standard mode。
涉及敏感資料時,仍要確認保存期限、處理地區、存取權限、刪除機制和合約條款。 官方文件列出 Model API 與 Muse Code 兩種入口,但模型頁未列服務區域;台灣團隊仍須確認帳戶可用性、付款與 API 條件。
試行也要指定任務負責人、資料來源、輸出接收者、錯誤處理方式與停止條件。涉及個資或商業機密時,先用測試資料驗證並確認資料處理條款。上線前可先採影子模式,讓模型產生結果但不直接執行外部動作,再由人員比對舊流程與新流程的差異。累積到足以辨認常見錯誤後,才逐步開放低風險動作;付款、刪除、對外回覆等步驟仍保留核准關卡。每次擴大任務範圍,都應重新檢查工具權限、抽查比例和停止條件。
五、試行前用哪些指標判斷是否值得保留?
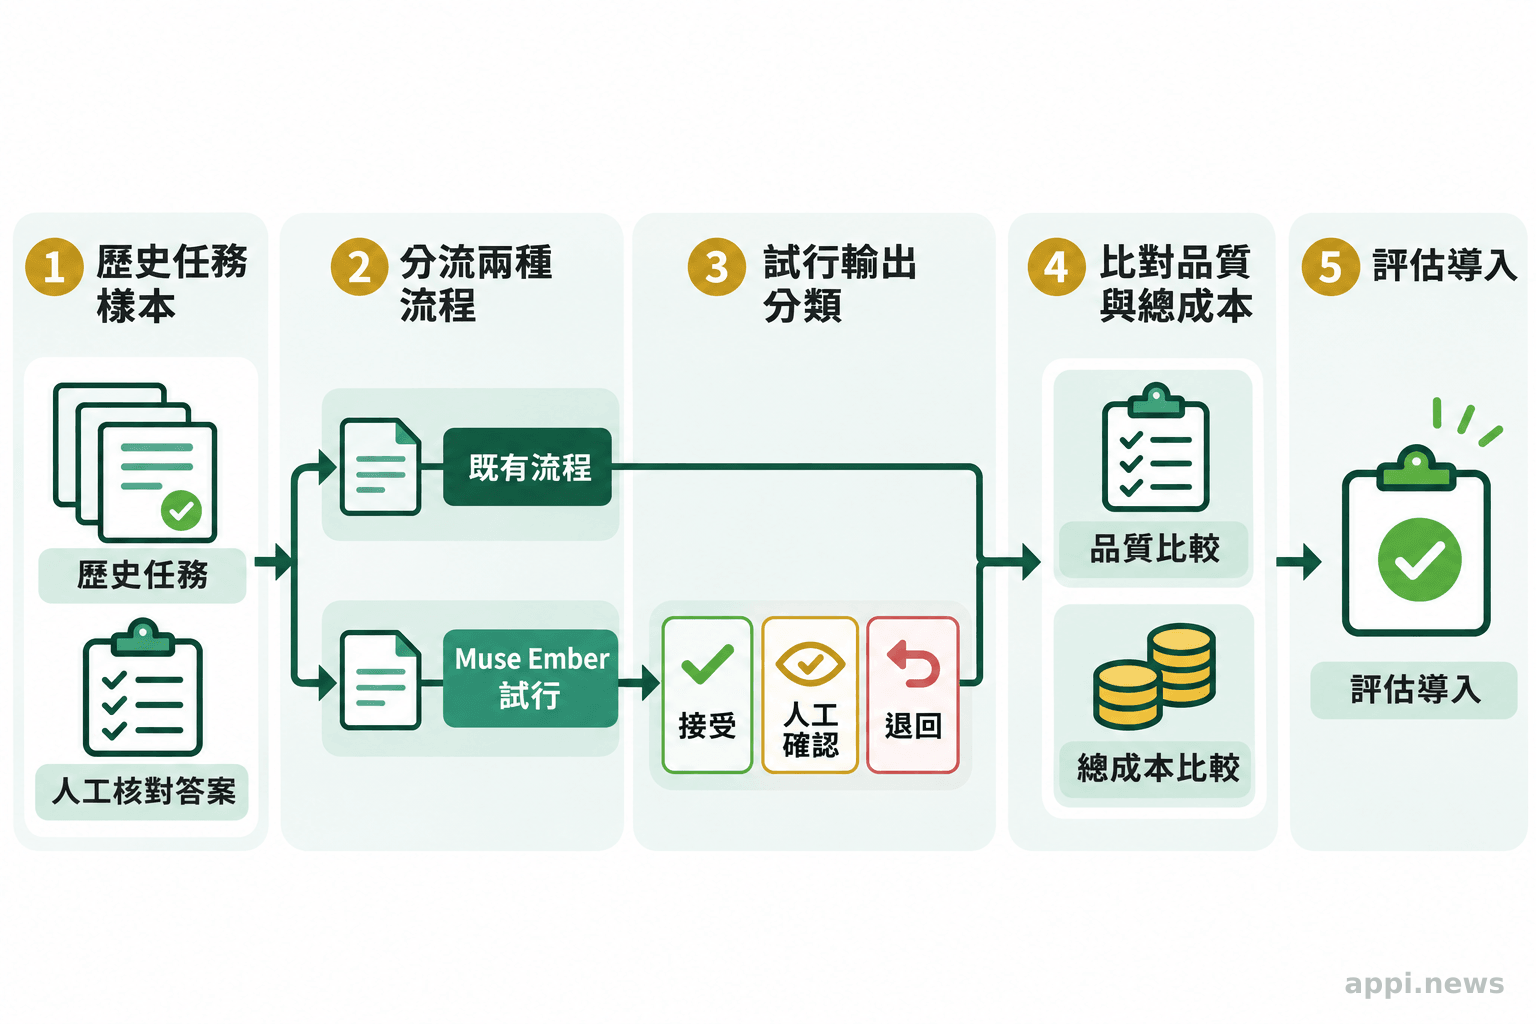
用同一批代表性任務比較原流程與新流程,記錄品質、時間、失敗處理與總成本,再依事先訂好的門檻決定擴大或停止。
先抽出一批過去任務作為基準,確認每筆資料有可供人工核對的正確答案。以相同輸入跑現有流程和小模型流程,記錄完成率、錯誤類別、重試率、平均延遲、人工覆核時間、工具呼叫數與每筆總成本。高風險任務要單獨列出,不要讓大量低風險成功案例稀釋少數嚴重錯誤。
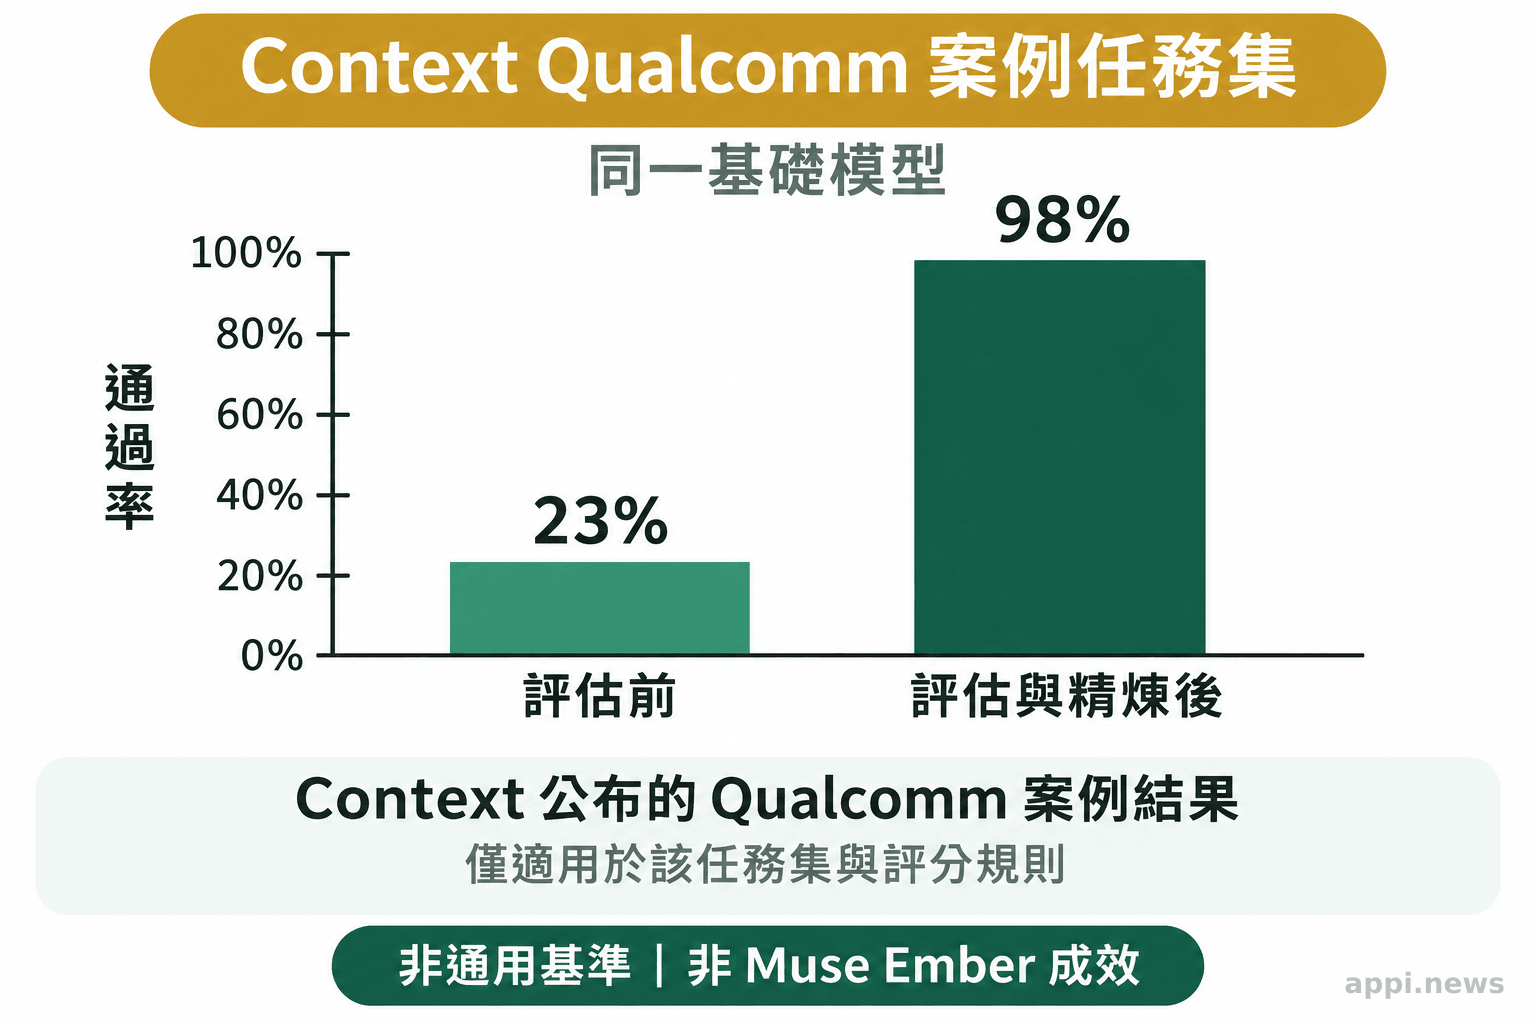
Context 表示,Qualcomm 全球客戶工程團隊以代理處理客戶支援與工程工作流,日常需查閱多種 SDK、產品線及內部文件。Context 以試行團隊建立的實際任務集驗收,稱同一基礎模型的通過率由 23% 升至 98%;案例頁另稱三個月內導入 85 個團隊,四個月內累計達 1,600 個正式工作流,後續再將流程蒸餾成小型模型。這些數字只適用於該任務集與評分規則,不能直接預測其他團隊的成效。
「部分成功不算成功。」Context 在 Qualcomm 案例中說明其嚴格任務驗收標準(原文: “Partial success does not count.”)。
比較試行前後時,除了成功率,也要看錯誤是否集中在特定任務、資料格式或語言。將「可自動接受」「需人工確認」「必須退回」分成不同結果,可以看出模型是否真的減少工作,還是把整理負擔轉移給審核者。若試行期間修改了提示、資料或工具,應標記版本並分開統計,避免把不同設定的結果混成一個數字。
- 選一項輸入穩定、結果可核對、出錯可復原的重複任務。
- 用同一批樣本記錄目前完成率、錯誤、工時與每筆成本。
- 限制試行模型的資料和工具權限,將高影響輸出送人工覆核。
- 另計輸入與輸出 token、快取、搜尋等工具、重試、監控、整合及人工時間。
- 事前寫下品質和成本門檻;未達門檻就調整流程或停止,不因單價低而自動擴大。
若團隊考慮接入 Muse Ember 或其他小型模型,先挑一項符合上述條件的工作做限權試行,再依品質、例外處理和總成本決定是否擴大。
- Muse Ember 是 Meta 定位給高頻重複代理工作的執行模型;官方評測不能代替自己的任務驗收。
- 每百萬輸入 token 0.10 美元不等於單次工作總成本,輸出、長上下文、工具、重試和人力都要納入。
- 優先試行可逆、可檢查、輸入穩定的子任務,並限制權限、保留操作紀錄及設定人工升級流程。
常見問題
Q1:Muse Ember 可以直接取代既有大型模型嗎?
不能只根據價格或 Meta 公布的評測分數決定。若工作包含多步規劃、例外判斷或高影響操作,應先保留較強模型或人工覆核,再以任務測試確認哪些步驟可下放。
Q2:Muse Ember 每百萬 token 只收 0.10 美元嗎?
0.10 美元是一般費率下的輸入 token 價格。輸出 token 一般費率為每百萬 0.50 美元;超過 200K 輸入 token 的請求適用較高長上下文費率,工具使用也可能另計。
Q3:試行時最先要管控什麼?
先管控模型可讀取的資料、可呼叫的工具和可執行的動作。保留操作紀錄,讓高影響或無法自動核對的輸出經人工確認,並預先設好失敗升級與停止方式。
參考來源
- Meta. (2026). Introducing Our Smallest, Most Efficient Model: Muse Ember
- Meta Model API. (2026). Pricing and rate limits
- Meta Model API. (2026). Muse Ember
- IBM. (2025). Transforming HR support with agentic AI (IBM AskHR)
- SnapLogic. (2026). How SnapLogic’s AI Agent Jean-Paul Returned $3M+ in Value in Just 4 Months
- Context. (2026). Scaling 1,600 production agent workflows with Qualcomm


