很多人在談量子運算時,第一個會想到量子位元數與硬體速度。但在擴大量子處理器之前,還有更前面的問題要處理:運算途中出現錯誤時,架構能否偵測並修正,讓量子資訊維持可用?QC Design 發表的 Meridian,正是瞄準這一層設計工作。
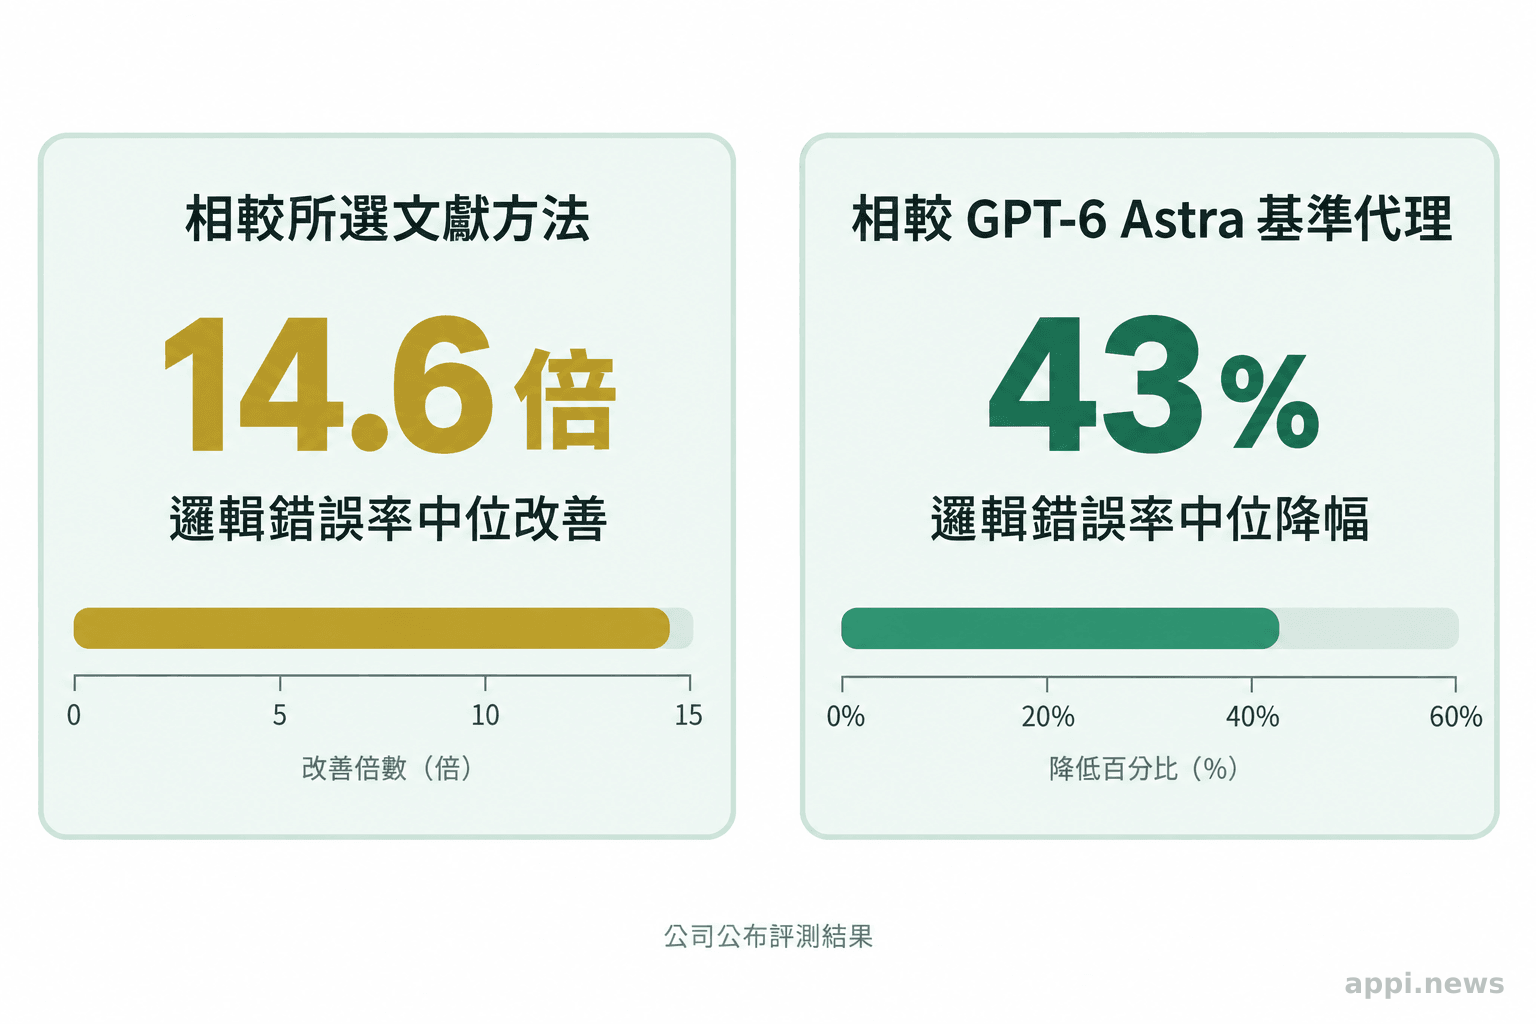
公司在白皮書中報告,Meridian 在特定錯誤更正電路評測中,相較所選文獻方法的邏輯錯誤率中位改善 14.6 倍;這是廠商公布的模擬評測結果,不能直接讀成實際量子電腦的錯誤率已下降相同比例。
一、量子架構設計要先處理錯誤如何形成
實體量子位元會受噪聲、閘操作與量測誤差影響,錯誤更正架構要讓受保護的邏輯量子位元在這些影響下仍能可靠運算。可用性取決於錯誤更正碼、電路、硬體連線與錯誤模型等條件,單看實體量子位元數無法判斷。
實體量子位元、錯誤更正碼與邏輯量子位元
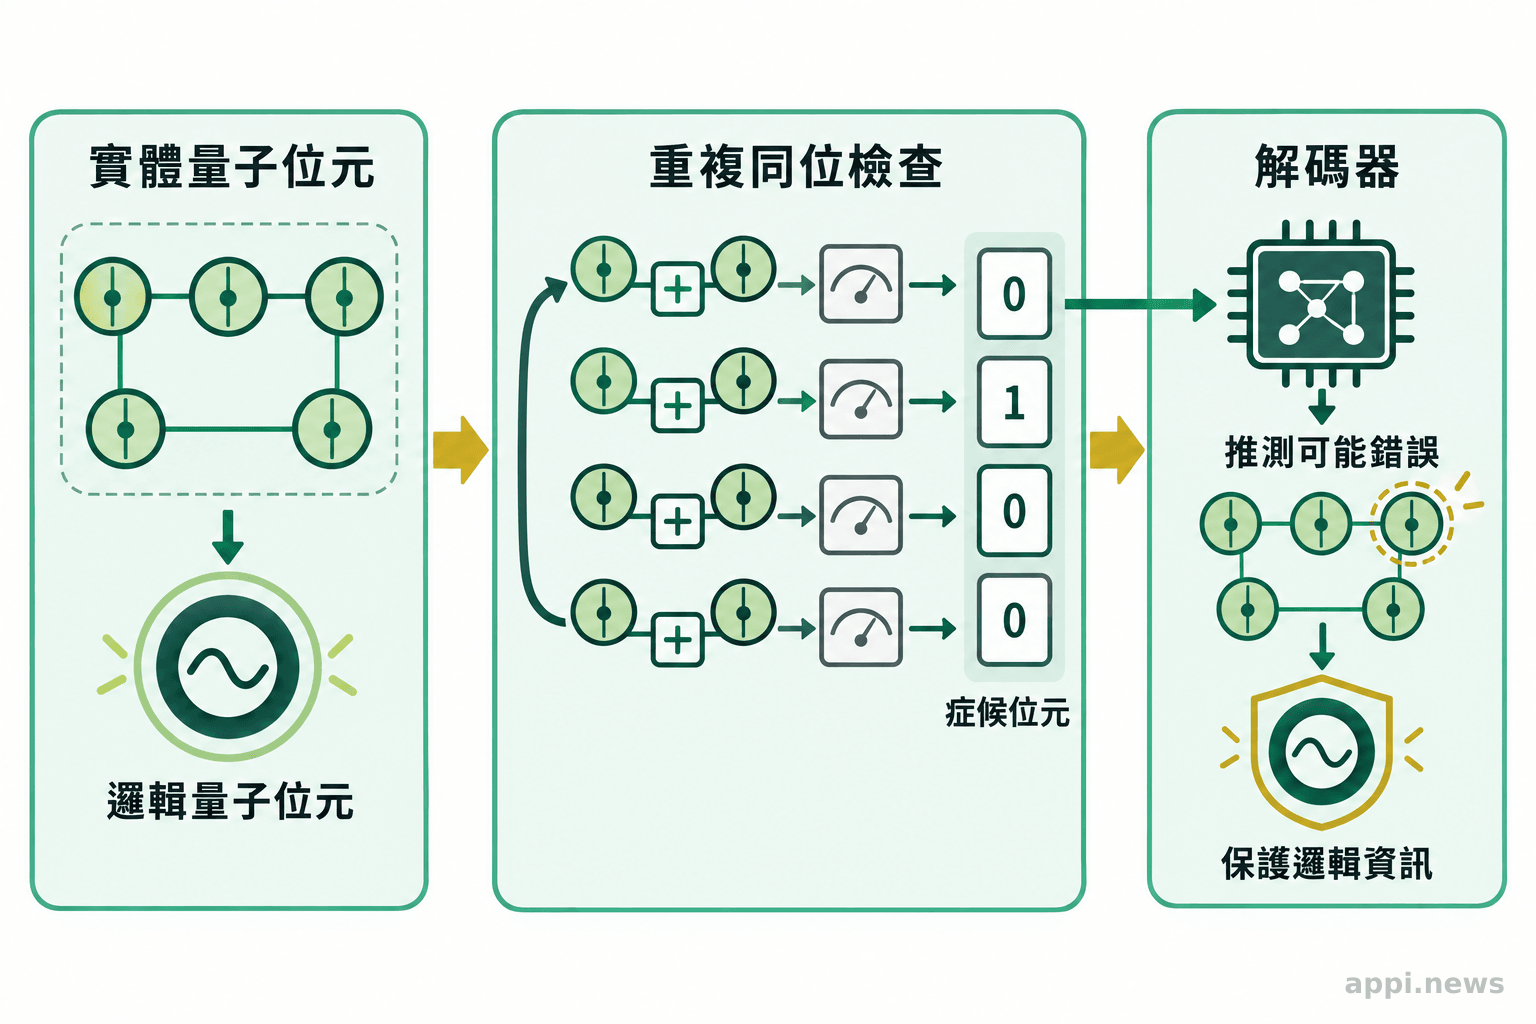
實體量子位元是硬體直接操控的單位。量子狀態容易受環境與操作干擾,錯誤包括位元翻轉、相位變化、能階洩漏與讀取偏差。量子錯誤更正碼(quantum error-correcting code)會把量子資訊分散編碼到多個實體量子位元中,形成邏輯量子位元,再利用額外量測辨認錯誤。它在保護資訊的過程中,不能直接讀出並複製未知量子狀態。
這種保護有前提。量子位元及其閘操作、量測、初始化本身都可能出錯;如果校正流程新添的錯誤擴散得太快,增加編碼規模也未必讓整體結果變好。IBM Quantum Learning 指出,容錯門檻會受到錯誤更正碼與實作方式影響。
syndrome extraction circuit 如何偵測錯誤
錯誤更正碼會定義一組可檢查的關係,量子系統反覆量測這些關係,收集成錯誤症候(syndrome)。症候像一組檢查結果,協助解碼器推測哪些錯誤可能發生,再決定如何修正。症候量測電路(syndrome extraction circuit)就是執行這些檢查的電路。
電路安排會受到硬體連線限制。兩個量子位元若不能直接互動,就可能需要額外的閘、輔助量子位元或更長的操作路徑;每增加一次操作或等待,都可能引入新的錯誤。設計者因此需要同時考量錯誤更正碼、量子位元所在位置、可用連線、閘操作順序與各種噪聲。Meridian 評估的正是指定碼、硬體布局與錯誤模型下,如何設計偵測錯誤的電路。
二、Meridian 把 AI 搜尋接上硬體模型與驗證
QC Design 說明,Meridian 以 AI 探索候選設計,結合人工整理的量子知識,並透過 Plaquette 依指定硬體布局與錯誤模型模擬和評估電路。AI 搜尋候選,物理模型與模擬評估其邏輯錯誤率。
AI 如何提出候選錯誤更正電路
錯誤更正電路設計要整合量子資訊、錯誤更正碼、硬體物理特性與工程限制,候選排列也可能很多。QC Design 將 Meridian 描述為專為容錯量子運算設計的 AI 系統,利用前沿模型、人工整理的知識庫及驗證工具擴大探索範圍。依白皮書頁面,測試任務給定錯誤更正碼、裝置布局與錯誤模型,Meridian 要提出能實作該錯誤更正碼的電路。
AI 搜尋可找出人類設計者沒有優先嘗試的組合,但候選「看起來分數更好」仍不足以證明它可用;模型若漏掉硬體限制或錯誤來源,最佳化器可能利用評分規則的缺口,產生在模型裡漂亮、在設備上不成立的電路。
Plaquette 如何依指定布局與錯誤模型評估候選設計
Plaquette 是 QC Design 的量子設計自動化與容錯模擬軟體。官方產品說明列出從定義錯誤更正碼、建立噪聲模型、產生電路,到模擬、解碼與分析的流程。可納入的硬體不完美包含閘級錯誤、洩漏、相干誤差等;設計團隊也能使用自訂模型,對照實測的閘保真度或其他噪聲特徵。
Meridian 透過 Plaquette 評估 AI 提出的方案,形成「提出候選、模擬測試、依結果再搜尋」的迭代方式。QC Design 稱這個模擬層為世界模型,意義在於候選設計會被放回一組明確的硬體假設中檢查。模型能模擬哪些錯誤、採用何種解碼器、電路成本如何計算,都會影響最後的分數。模型愈貼近目標硬體,模擬愈有參考價值;但模擬與實機量測仍是不同證據。
三、白皮書的逾十倍成果代表什麼
14.6 倍是 QC Design 公布的評測中位數,描述 Meridian 相較所選文獻方法,在特定症候量測電路任務上的邏輯錯誤率表現。公司另報告,與 GPT-6 Astra 基準代理相比,中位錯誤率降低 43%;兩個比較使用不同基準,不能合併成同一個「AI 提升幅度」。
逾百項任務與比較基準的範圍
QC Design 白皮書介紹頁稱,評測包含逾 100 項任務,涵蓋 10 種錯誤更正碼家族與六類硬體連線方式,錯誤模型代表主要量子運算平台。每項任務會指定碼、硬體布局與錯誤模型,衡量候選電路的邏輯錯誤率。公司也表示,與五種已發表演算法比較時,採用各任務中表現最佳的電路作為文獻基準。
不同任務的錯誤模型、碼家族、硬體布局與比較演算法可能各異;中位數反映評測集合裡的典型改善,不代表每項任務都降低相同倍數。判斷結果能否重現,還要知道完整任務清單、基準電路、模擬細節、解碼方式與統計方法。
文獻方法與 GPT-6 Astra 基準代理的結果要分開看
QC Design 報告,相較文獻方法中位改善 14.6 倍,任務間幅度從 1.5 倍到逾 22,000 倍。另一組比較以 GPT-6 Astra 為基礎的通用代理為基準,公司報告中位錯誤率降低 43%,最高改善 98.4%,約為錯誤率低 63 倍。解讀數字須一併看任務定義與比較基準。
兩組數字回答不同問題:前者對照已發表電路方法,後者對照指定的通用 AI 代理。測試提示、工具、算力與基準實作都會影響比較,須先了解對照組設定。
| 評測比較 | QC Design 公布的結果 | 判讀時要確認 |
|---|---|---|
| Meridian 對文獻方法 | 邏輯錯誤率中位改善 14.6 倍 | 各任務採用哪個文獻電路、是否同一噪聲與解碼條件 |
| Meridian 對 GPT-6 Astra 基準代理 | 中位降低 43%,最高降低 98.4% | 代理可用的工具、提示、算力與執行流程 |
| 公布的評測範圍 | 逾 100 項任務、10 種碼家族、六類連線方式 | 原始任務資料、完整白皮書與第三方重跑結果 |
邏輯錯誤率改善不等於整台量子電腦已達容錯
邏輯錯誤率描述受錯誤更正保護的量子資訊失效的頻率。降低這項數值,是朝可靠計算前進的一項指標;它本身沒有交代整台設備能容納多少邏輯量子位元、能執行多長的電路、需要多少實體量子位元或要花多少時間。
更完整的容錯評估還要看閘操作、量測、初始化、解碼延遲與邏輯閘實作等環節如何共同運作。IBM Quantum Learning 的容錯說明指出,錯誤更正程序本身也會受到不完美閘與量測影響,且門檻與錯誤更正碼及容錯實作方式有關。因此,Meridian 這次公開的結果適合描述為一層電路設計評測的成果,不能據此宣稱已證明全機容錯或實際處理器整體錯誤率下降 14.6 倍。
QC Design 共同創辦人 Martin Plenio 表示,Meridian 結合 AI 驅動的探索,以及解決該設計問題所需的建模與驗證;這也提高了硬體團隊可設計並進而建造的方案上限。
四、從評測走到量子硬體仍有幾道門檻
目前公開資料將這項成果定位為錯誤更正電路的模擬評測,沒有顯示逾十倍改善已在實際量子處理器上重現。公司將全堆疊架構選擇、實體量子位元需求與運算時間評估列為下一步,落地成效仍要經目標設備和獨立資料檢驗。
模擬錯誤模型與實際設備差異
模擬必須將硬體行為轉成數學模型。模型可以納入閘錯誤、洩漏、串擾或相干誤差,但實際設備的噪聲會隨硬體平台、操作參數與時間變化。若模型只涵蓋平均錯誤率,忽略錯誤間的相關性、校準漂移或控制系統限制,電路在模擬中的排名未必能預測它在設備上的排名。
Plaquette 官方頁面列出多種模擬器、解碼器與硬體錯誤模型,可測試模型假設變化後結果是否仍穩定。研究團隊仍要拿目標硬體量測資料校準模型,並比較模擬預測與實際執行結果。
全堆疊設計、量子位元需求與運算時間尚待評估
量子架構是多層決策相互牽動的結果。錯誤更正碼和症候量測電路會影響實體量子位元數、操作排程與解碼負荷;上層演算法和目標任務也會決定需要多少邏輯位元與運算深度。即使某一類電路的邏輯錯誤率下降,若要付出更多輔助量子位元、額外閘操作或更長的量測週期,整體資源是否划算仍須計算。
QC Design 在白皮書頁面把跨全堆疊評估列為下一步,將檢視架構選擇對實體量子位元需求和邏輯運算時間的影響。這表示公開 benchmark 聚焦的範圍尚在架構堆疊的一層。硬體團隊若考慮將結果納入設計路線圖,應要求供應商把該電路評測與實際裝置的資源估算、控制限制和目標運算連結起來。
工具可取得性、第三方重現與整合責任
公開頁面提供 Meridian 白皮書索取表單與量子硬體團隊候補名單,未呈現一般使用者可立即下載安裝的完整流程。Plaquette 產品頁則表示可洽詢授權或預約展示。採用前需確認 Meridian 存取資格、授權方式、支援平台、計算成本、資料處理方式與內部部署方式;公開頁面沒有列出價格和完整商用條款。
團隊需要決定由誰提供錯誤模型、審核候選電路、核對模擬與硬體差距,以及硬體或解碼器更新後如何重跑。第三方若能取得任務、基準和執行設定並獨立重現,會增加外部信心;若完整白皮書與原始資料尚未公開,這項限制也應納入證據判斷。
QC Design 在白皮書頁面說明:「下一步是評估全堆疊架構選擇對實體量子位元需求與邏輯運算時間的影響。」
五、量子硬體團隊如何判斷設計工具是否適用
先取得完整方法與任務資料,核對基準電路、錯誤模型、硬體連線假設和邏輯錯誤率算法,再以自家設備條件重跑關鍵案例。評估時也要把第三方重現、運算資源、工具取得方式與後續維護責任一起納入。
比對任務、基準、錯誤模型與獨立驗證
第一步是看評測問題是否和團隊的設計問題相同。若目標硬體是矽自旋量子位元,就應確認任務是否涵蓋相應連線、控制和洩漏條件;若錯誤更正碼不同,也要確認該碼是否包含在評測中。平均改善數字不能取代與目標裝置相符的個別測試。
接著核對文獻基準如何選取、GPT-6 Astra 基準代理使用哪些工具,以及各組是否以同一套模擬條件評分。要求提供可重跑的電路、錯誤模型、解碼器設定與統計方法,讓內部團隊或第三方重現。若改善只在單一模型或少數任務出現,應檢查調整噪聲參數、解碼方式和硬體拓樸後是否仍成立。
評估成本、硬體限制與導入後的追蹤方式
工具導入的價值要和總成本一起看。除了授權費,還有模擬所需算力、專家工時、既有設計工具串接、資料整理、驗證與維護成本。也應釐清供應商能否支援團隊所用的量子位元平台、工具是否可在內部執行、硬體設計與錯誤資料如何保存,以及供應商更新模型後如何追蹤結果差異。
量子硬體團隊可依序檢查:
- 索取完整白皮書、任務清單、基準電路與評測設定。
- 對照自家硬體布局、錯誤模型、錯誤更正碼與解碼器,確認評測條件是否相符。
- 在獨立環境重跑代表性案例,並以目標設備的近期量測資料校準模型。
- 估算額外量子位元、閘操作、解碼延遲、算力與授權成本,再設定採用後的追蹤指標。
- Meridian 結合 AI 候選搜尋與 Plaquette 模擬,評估指定錯誤模型和硬體布局下的錯誤更正電路。
- QC Design 報告相較文獻方法的邏輯錯誤率中位改善 14.6 倍,與 GPT-6 Astra 基準代理的中位降幅則為 43%,兩組比較條件不同。
- 公開結果仍屬公司公布的電路評測,第三方重現、目標硬體驗證與全堆疊資源效益仍需確認。
常見問題
Q1: Meridian 是量子電腦嗎?
不是。Meridian 是 QC Design 開發的 AI 量子架構設計系統,協助探索容錯量子運算設計;Plaquette 則用於硬體建模與模擬評估。它們不等同於實際執行量子運算的量子處理器。
Q2: 邏輯錯誤率降低 14.6 倍代表什麼?
這是 QC Design 公布的評測中位數,表示在其白皮書所涵蓋的任務及文獻基準下,Meridian 產生的受測電路具有較低的評估邏輯錯誤率。它不代表每一項任務都改善 14.6 倍,也不代表實機效能必然相同。
Q3: 白皮書結果是否已在實際量子硬體上驗證?
目前公開的白皮書介紹頁描述的是錯誤更正電路評測與模擬,沒有公布足以證明整體逾十倍改善已在實際量子處理器上重現的資料。採用者仍需檢視實機測試與獨立重現結果。
Q4: 目前哪些團隊可以使用 Meridian?
QC Design 公開頁面以量子硬體團隊為對象,提供候補名單與白皮書索取表單,並說明團隊會在有名額時聯絡申請者。公開資訊沒有表示 Meridian 已開放一般使用者直接下載,因此應先向公司確認資格、存取方式和授權條件。
參考來源
- QC Design. (2026). *Meridian White Paper | QC Design
- QC Design. (2026). *QC Design’s Meridian Outperforms Published Methods and General-Purpose AI in Quantum Computer Design*. QC Design Press Release
- QC Design. (n.d.). *Plaquette: Design automation software for fault tolerant quantum computing*. QC Design
- IBM Quantum Learning. (n.d.). *The stabilizer formalism*. IBM
- IBM Quantum Learning. (n.d.). *Fault-tolerant quantum computation*. IBM