有了開源模型,能不能直接拿自己的地理資料來用?先別急著下載權重,第一個要確認的是模型學到的資料關係,是否和手上的資料、任務相近。NASA 與 IBM 在 2026 年 9 月公開月球基礎模型及相關資料,展示了把多種月球觀測資料整理成可調適模型的做法。它降低研究團隊從零訓練的門檻,並不等於能即插即用地分析地球影像。
NASA、IBM 公開的成果包含模型、資料與微調程式
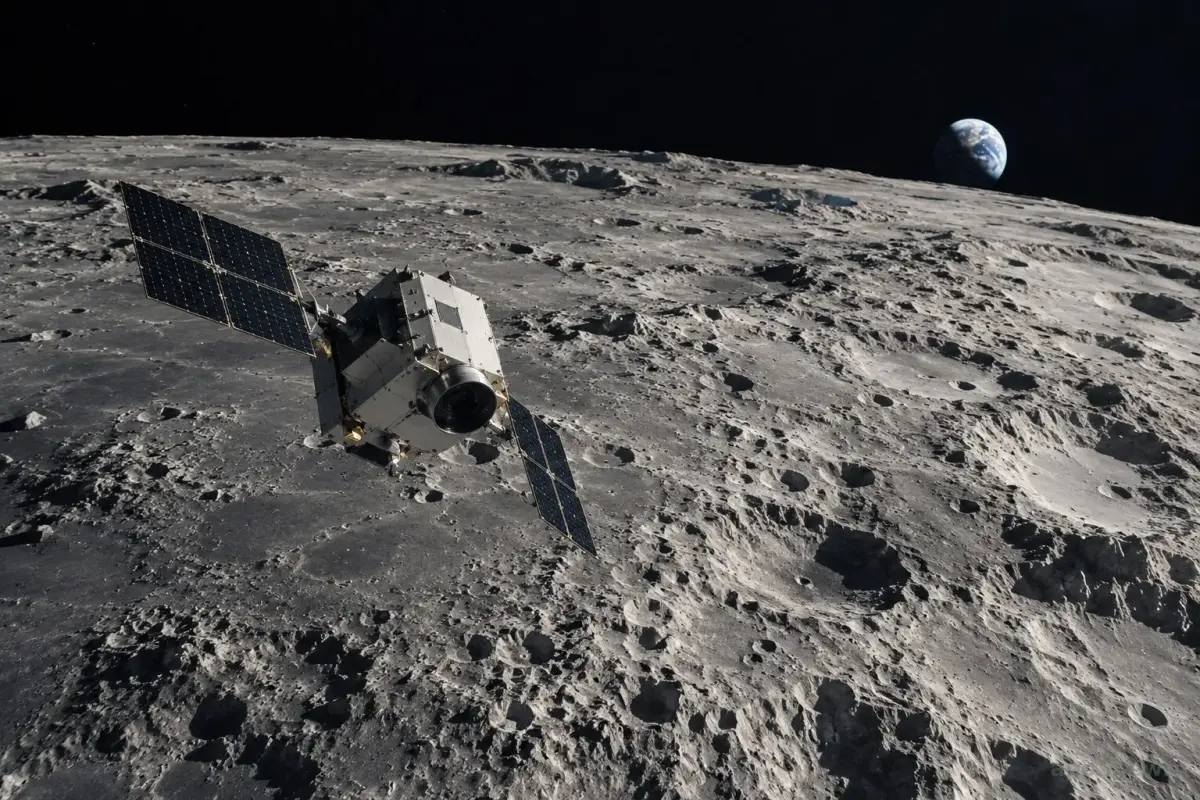
公開內容包括預訓練模型權重、月球資料集、基準任務資料與下游微調程式。模型主要利用月球勘測軌道器(LRO)資料,並整合其他探測任務的地形、熱、雷達、礦物與重力等資訊。
「17 年軌道資料」指 LRO 長期觀測背景,模型訓練也納入其他探測任務。團隊將資料對齊到相同地理範圍,讓模型能比較同一處地表的影像、地形、照明與其他觀測量;座標、範圍和尺度對得上,是多來源資料能共同使用的前提。
技術論文稱 SomBench 約有 196 萬組對齊資料,涵蓋 11 種模態與兩種影像尺度:窄角相機約每像素 1 公尺,廣角相機約每像素 100 公尺。多模態讓影像、地形與光照等資料互補,多尺度則兼顧細部地貌和大範圍特徵。
模型也接收太陽入射角、觀測角度等資訊,協助辨識陰影造成的亮暗變化。研究者將預訓練模型整合進 TerraTorch,這套開源工具可用於地理空間模型微調與評估。
「收集資料只是工作的一部分,還需要讓資料更容易被科學家探索與使用。」— NASA 首席科學資料長 Kevin Murphy(NASA 2026 年 9 月發布資料)
月球模型目前評估的任務,不能直接等同科學結論
目前論文評估的是月球坑偵測、不規則月海斑塊分割與極區冰潛勢估計等特定基準任務。模型輸出可協助研究者排序、標記或估計候選區域,仍須由觀測資料與後續研究確認其地質意義。
月球坑偵測要框出撞擊坑;不規則月海斑塊(IMP)分割則標記可能較年輕的火山地貌。預印本顯示模型在各任務的表現有差異,部分基準較佳,部分與比較模型相近,不能推論所有項目都提升。
極區冰潛勢任務以既有知識建構的潛勢圖為目標,評估模型能否重現其空間模式。輸出是待查證的研究線索,並非地下水冰實測量或已確認的資源分布,仍須搭配其他儀器觀測與地質判讀。
NASA 說明模型在選定的坑洞、火山特徵及冰穩定性基準上達到可比或較佳表現。這是 2026 年 9 月發布的預印本結果,正式研究仍應依自己的資料重測。
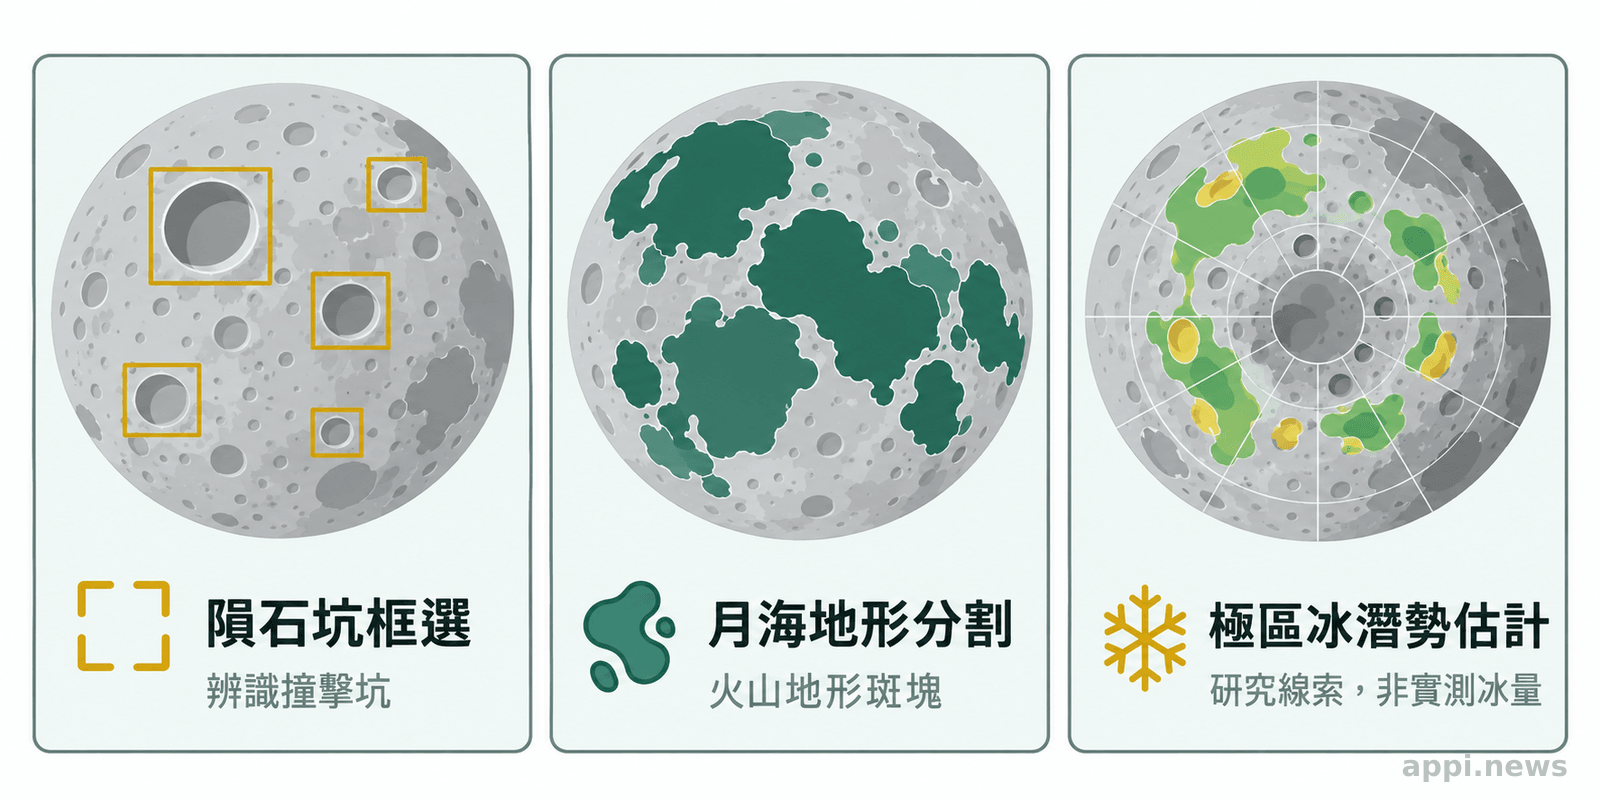
「冰潛勢輸出回歸的是知識導向的模糊疊合潛勢圖,不是實測冰量。」— NASA-IBM Lunar Foundation Model 研究團隊(模型卡)
團隊重用模型前,先檢查資料與任務的相似度
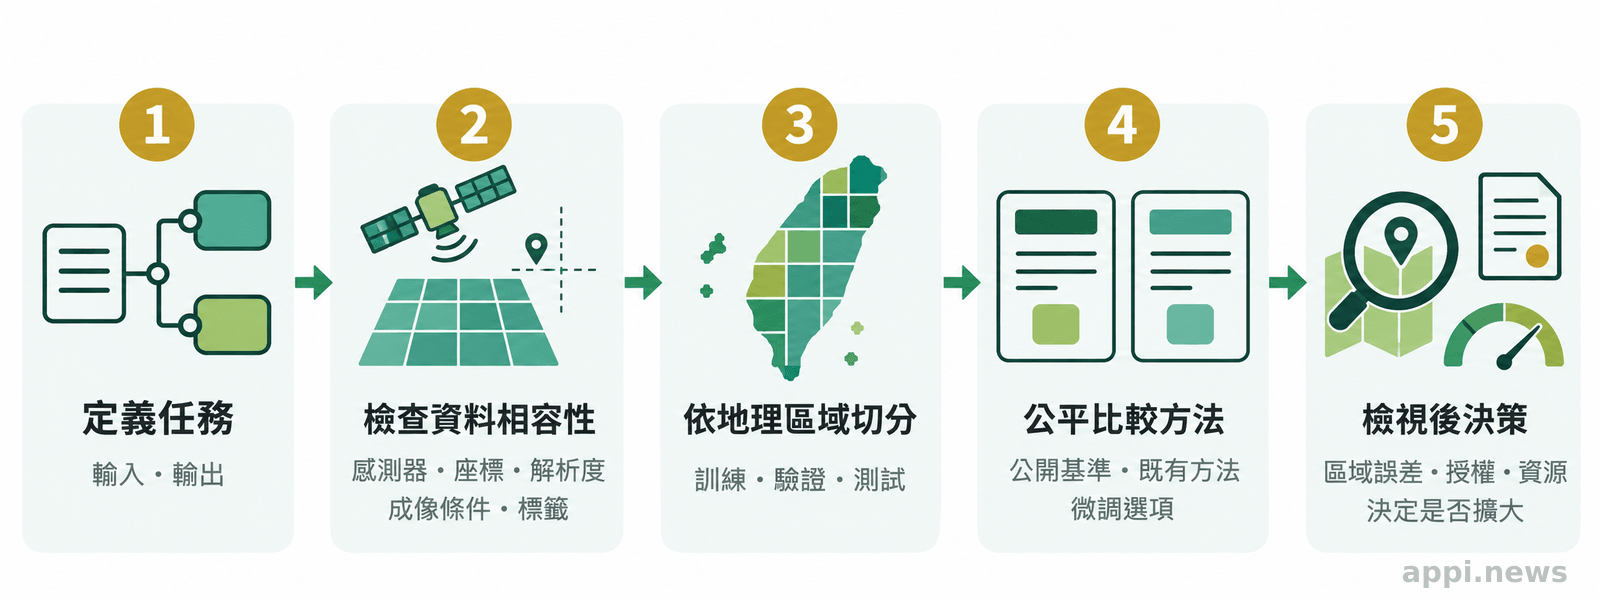
先比對感測器、波段、解析度、座標系、光照條件與任務標註,再用獨立測試資料和現有基準做小規模比較。資料外觀相似不代表分布相同,月球模型是否能遷移到地球或其他行星,仍需實測。
月球與地球遙測資料的成像設備、波段、解析度和地表條件可能不同。輸入模態不足或座標未對齊,都會影響微調結果。
GitHub 專案提供 TerraTorch 資料模組、任務設定與執行範例。團隊可選定分割或地物偵測等明確任務,整理標註後先跑通資料讀取、模型輸出與指標,再用相同資料切分和現行方法比較。
依地理區域切分訓練與測試,避免相鄰影像造成資料洩漏,並檢查誤判是否集中於特定地貌或成像條件。研究論文也採用地理區域切分。
微調方式可依標註量、算力和可接受的維護成本比較:
| 方式 | 怎麼做 | 適合先回答的問題 | 主要考量 |
|---|---|---|---|
| 凍結骨幹 | 保留預訓練模型,只訓練任務頭 | 預訓練特徵是否已能支援任務? | 計算需求較低,適應新資料的幅度有限 |
| LoRA | 凍結大部分權重,加入低秩調適參數 | 少量調整能否改善目標任務? | 需測試不同資料與參數設定,不能假定一定較好 |
| 全量微調 | 更新模型大部分或全部權重 | 充分調適後能否提升測試表現? | 算力和標註需求較高,也需防範過度擬合 |
這不是性能排名。先建立現行方法與凍結模型的基準,再測 LoRA 或全量微調;只有在獨立測試區域穩定改善,才擴大實驗。
- 定義一項可量測的遙測任務,明列輸入資料、輸出格式和評估指標。
- 盤點感測器、座標系、空間解析度、成像條件與標註來源,確認和模型輸入的差異。
- 建立不含相鄰或重複地理區塊的訓練/驗證/測試集,同時保留既有方法作對照。
- 用公開設定跑通資料載入與基準,再逐一比較凍結骨幹、LoRA 和全量微調。
- 檢查跨區域表現、錯誤案例與授權條件;有可重現的改善再評估部署。
開源降低起步門檻,資料與部署成本仍要估算
不能只看「開源」兩字判斷商用權利,也不代表免除資料清理、硬體、標註與維運成本。模型權重、程式碼、預訓練資料和基準資料應分別確認授權及取得條件。
Hugging Face 模型權重頁面標示 Apache-2.0;GitHub 公開微調與推論程式,沒有附上預訓練程式。權重、程式、來源資料與下游資料集是不同發布項目,商用或再發布前要分別確認授權與署名要求。
自有資料格式不同,仍須轉換投影、重採樣、處理缺值、標註和檢查品質。GPU、版本控管、資料更新與效能監測也都要估算,可先用公開任務測試環境需求。
研究預訓練資料集中於月球產品,論文未評估地球或其他行星資料。跨領域使用仍須調適輸入模態並驗證泛化;地球分析也應與地球觀測模型比較。
哪些團隊值得先做小型驗證?
已有遙測影像、明確下游任務與基本標註能力的團隊,最適合先做可重現的小型驗證。若資料與月球遙測差距大,模型可作為比較對象,但不宜預設它會勝過專用模型。
月球研究、行星科學與地理空間 AI 團隊,可先測試論文中的坑洞偵測或地貌分割。地球遙測團隊則應先盤點感測器、光譜、解析度和座標差異。
要讓比較成立,第一步是設定實際問題、固定資料切分與指標,並納入既有方法作對照。NASA-IBM 模型公開領域模型、資料整理成果與下游基準;能否重用,取決於資料相似度、驗證結果與授權條件。
- NASA 與 IBM 公開月球模型權重、資料與下游微調工具,訓練集涵蓋多模態、多尺度月球觀測。
- 目前成效依據是特定月球基準;極區冰潛勢輸出是估計,不代表實測資源。
- 重用前應比對感測器、座標、解析度、標註和任務,並以獨立地理區域和既有方法公平比較。
- 權重、程式、資料授權需分開核對,算力、清理、標註與部署成本仍須估算。
常見問題
Q1:NASA-IBM 月球模型能直接分析地球衛星影像嗎?
目前沒有論文評估證明它能直接泛化到地球影像;需依任務微調並用獨立資料驗證。
Q2:開源是否代表可以任意商用或免除資料授權檢查?
不是。模型權重頁面標示 Apache-2.0,但程式、預訓練資料、基準資料可能各有條款。應檢查實際下載與使用的每個項目。
Q3:沒有大量標註資料,也能測試模型嗎?
可先用公開基準和範例確認環境,再測試凍結骨幹或 LoRA。結果仍取決於任務複雜度與測試資料代表性。
參考來源
- Fraccaro P, et al. (2026). Multimodal-Multiresolution Foundation Model for Lunar Remote Sensing. *arXiv
- NASA (2026). NASA, IBM Launch AI Foundation Model for Lunar Science. *NASA Science
- NASA-IMPACT (2026). GitHub - NASA-IMPACT/NASA-IBM-Lunar-Foundation-Model · GitHub. *GitHub
- NASA-IBM AI4Science (2026). NASA-IBM Lunar Foundation Model. *Hugging Face
- IBM Research (2024). TerraTorch: An Open-source Framework for Fine-tuning Geospatial Foundation Models. *IBM Research