llama.cpp 0.5.0 更新值得不值得升級,取決於它是否改善你實際使用的運算後端、模型和工作負載。官方 release notes 已列出 0.5.0 版本,內容涵蓋 CUDA 與 Metal 的運算最佳化、核心正確性修正、模型支援擴充,以及 server/router 行為調整;版本發布本身不代表每台電腦都會變快,也不表示所有模型檔都能直接載入。升級前先按自己的硬體和模型清單逐項比對,再用一致條件測試,才知道更新是否解決了眼前的問題。
一、llama.cpp 0.5.0 的版本資訊已確認
是,官方 GitHub 已列出 v0.5.0 release,並提供版本重點與變更清單。確認它存在後,仍須依條目判斷哪些更新適用於自己的環境,不能只憑版本號推定升級效益。
先前文章 #785〈本地 AI 對決雲端助理:台灣該怎麼選?〉提過 0.4.1 的模型與 JSON 支援更新;那段資訊只作本地推論背景,0.5.0 的判讀則回到本版新增的官方項目。
截至 2026 年 9 月 23 日,官方 v0.5.0 發布頁列出更新概述、重點項目,以及核心、模型、多模態、server、介面和 ggml 等分類。這讓讀者能把「版本是否發布」與「版本改了什麼」分開查證。先前版本的更新可以當作背景,但 0.5.0 的判斷應以這份 release notes 和其連結的變更項目為準。
官方以一句話概括這次版本方向:
“This release focuses on backend performance and correctness, broader model coverage, and more robust server/router operation.” — llama.cpp v0.5.0 release notes
這句話描述的是專案整理出的版本範圍,不是效能測試結論。要評估更新價值,需繼續追問三件事:改動落在哪個 backend(運算後端)、修正對應什麼輸入或執行路徑、新增的模型項目屬於原生執行、轉檔還是特定功能支援。三者都不能簡化成「整體更快、什麼模型都能跑」。
0.5.0 的更新脈絡也包含底層 ggml 0.25.0。ggml 是 llama.cpp 使用的張量運算元件,官方摘要提及跨 CPU、GPU 和加速器擴展部分算子與融合支援,同時處理穩定性、量化與資料排列。不同層的更新會沿著依賴關係影響上層工具,但實際效果仍由模型計算圖、資料型態和硬體支援共同決定。版本說明能告訴使用者「有哪些可檢查的改動」,無法代替部署環境的驗收。
二、0.5.0 的更新要分後端、正確性與模型支援判讀
主要可分為後端效能調整、核心或執行正確性修正,以及模型與轉換支援擴充。每一項都有對應的硬體、模型或操作條件,需先確認是否與目前使用方式重疊。
後端效能:確認更新是否涵蓋自己的運算平台
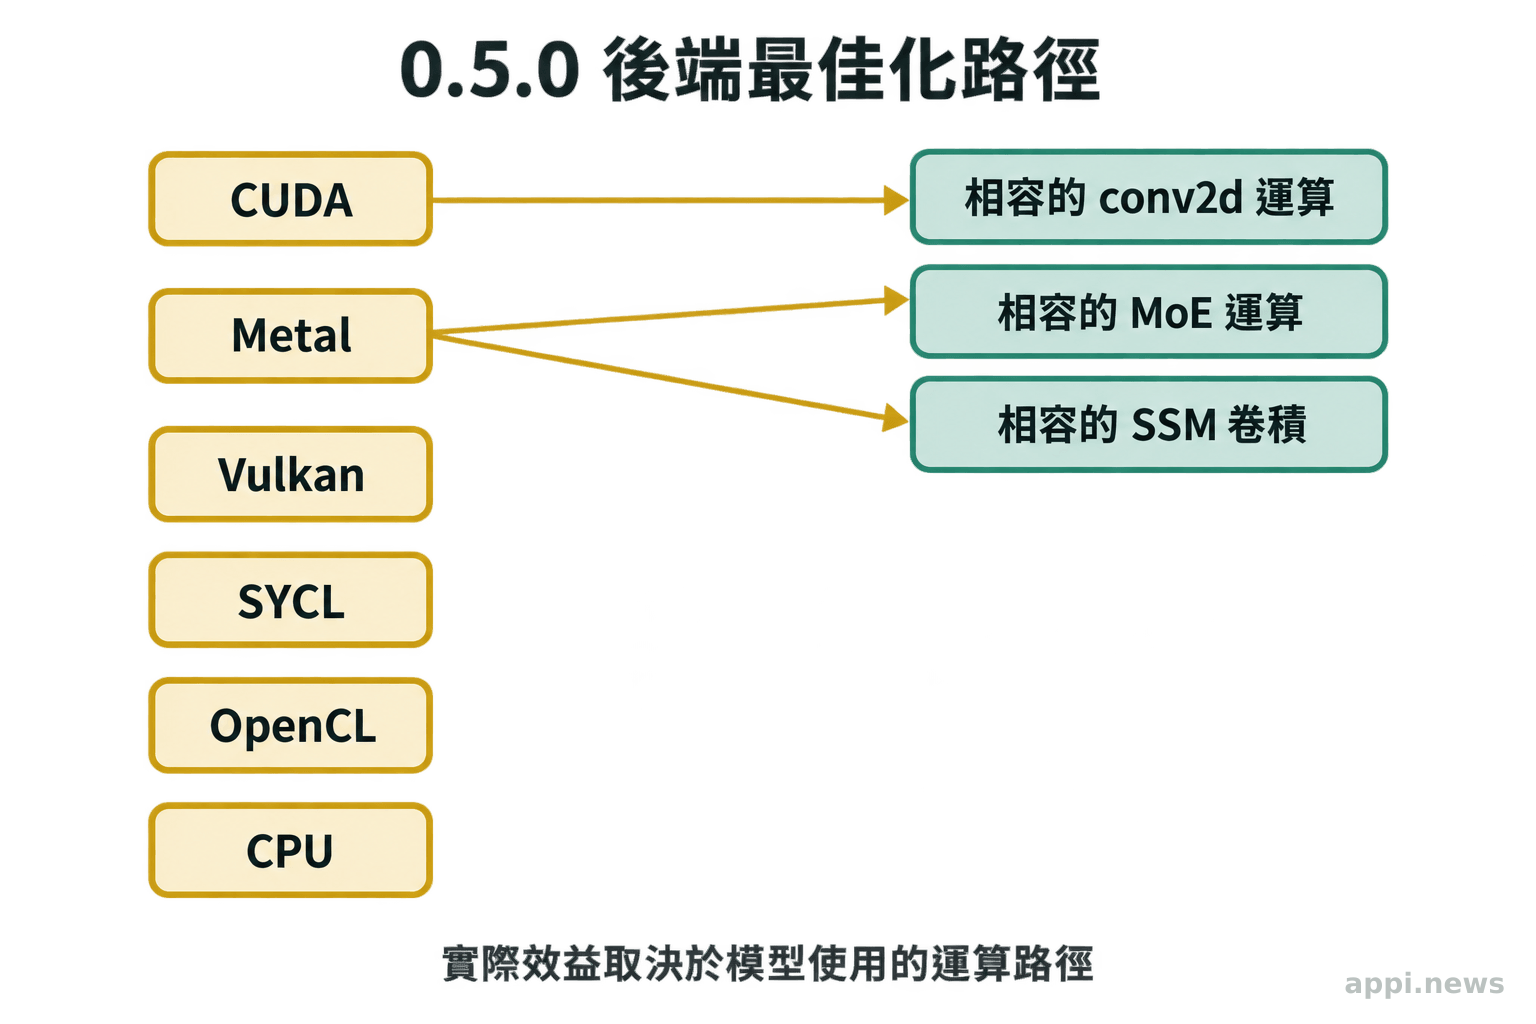
後端是實際執行張量計算的程式路徑,例如 CUDA 對應 NVIDIA GPU、Metal 對應 Apple 裝置。0.5.0 的亮點包含 CUDA 以 implicit GEMM(不另存完整矩陣的矩陣乘法方式)加速 conv2d(二維卷積),以及 Metal 對 MoE(混合專家模型)和 SSM(狀態空間模型)卷積路徑加入融合最佳化。變更清單也列出 Vulkan、SYCL、OpenCL、Hexagon 等多種後端的算子、核心或相容性調整。
這些項目說明了最佳化落點,卻沒有宣告所有任務都會變快。conv2d 主要與包含相應影像或卷積計算的模型工作有關;MoE 和 SSM 融合則只可能影響採用相關架構、且運算能走到該實作的模型。若日常工作是一般文字生成,不能單從上述條目推定每 token 速度都會提升。即使同屬 NVIDIA GPU,不同顯示卡世代、CUDA 編譯方式、GPU offload 層數和量化格式也可能改變測量結果。
因此,比對硬體時要看實際建置啟用了什麼,而非只看電腦型號。記錄作業系統、處理器、顯示卡與驅動版本、llama.cpp 的編譯選項、所選 backend,以及模型有多少層放在 GPU。CPU-only、CUDA、Metal 或 Vulkan 的結果要分開記錄,不要把一個後端的改善移植成另一個後端的結論。
正確性:釐清修正與速度提升是兩件事
版本清單中有些項目改善正確性或降低故障風險,例如修正張量維度與 stride(張量步幅)截斷、Mamba 時間步投影輸入連續性、CUDA 排序資料損壞,以及多模態影像處理的緩衝區邊界問題。另有 server/router 的模型淘汰競態和子程序生命週期修正。這些不是速度排行榜上的數字,但對受影響情境而言,可能關係到輸出可靠度、載入成功與服務穩定。
判讀時要從錯誤現象往回找。若既有版本偶爾在長寬比例特殊的圖片輸入出錯,可先確認更新是否涉及相同影像路徑;若服務採 router 管理多個子程序,則檢查 server/router 修正是否對應既有問題。反之,如果系統一直沒有遇到這些情境,不能將修正描述成所有使用者都會感受到的改善。正確性修正需以相同輸入重跑回歸案例,觀察錯誤是否消失,以及是否引入新的輸出差異。
模型支援:分清楚架構支援、轉檔和特定算子
release notes 把 HRM-Text/DFM Mimir 1B 列為新增模型支援,列出 MiMo-V2.6 的轉換支援、HunyuanOCR 的 DFlash 支援,也包括 Nemotron MTP、Nemotron-H 等處理擴充。Qwen4Exp 的 hyper-connection(超連結)運算和稀疏 flash attention、Muse Glimmer 的 --fuse-qkv,則指向特定架構或執行功能。
這些描述不是同一種「支援」。轉換支援表示模型轉成 llama.cpp 可用格式的工具路徑有所增加,並不等於轉檔後所有推論功能都已完整;一項算子或 parser(提示模板解析器)支援,也不能單獨證明每個權重量化檔都能載入。實際使用前,應確認模型版本、GGUF 格式或轉檔步驟、量化檔、tokenizer 與 chat template(對話模板),以及要用的是 llama-cli 還是 llama-server。模型卡片和第三方量化者提供的檔案,也有各自的版本與使用條件。
對維護開源模型服務的人來說,模型相容性還包含周邊整合:啟動參數是否仍有效、API 輸出格式是否一致、工具呼叫或多模態輸入能否照舊執行。模型可以載入只是第一個門檻,還需把原本的提示詞、結構化輸出、批次請求和長上下文案例放入回歸測試。相容性宣稱應落到明確的模型檔案和操作條件,不宜只寫模型家族名稱。
“This release expands hyper-connection, flash-attention, and fused MoE/SSM support across CPU, GPU, and accelerator backends.” — ggml v0.25.0 release notes
ggml 專案的版本說明進一步列出跨後端擴展的運算類別,也同時提到穩定性、量化、資料排列與 RPC/meta buffer 管理更新。這可作為追查 llama.cpp 更新來源的線索,但「跨後端支援」不代表每項改動在每個裝置上都有相同表現。應點開變更項目確認它涉及哪個算子、後端和架構,再用自己的模型重現。
三、用固定條件比較升級前後的結果
保留舊版本環境,以相同模型檔、量化、提示詞、上下文和硬體設定重跑測試,並同時比較速度、輸出與錯誤狀況。只有版本差異保持為主要變因,前後數據才有解讀價值。
固定模型、參數與提示詞做前後對照
先挑出實際工作負載中最重要的案例:例如短提示詞生成、長文件摘要、圖片問答、工具呼叫或多人同時請求。每個案例保存輸入提示詞、模型檔雜湊或明確版本、量化格式、上下文長度、batch size、GPU 層數、執行參數和輸出。新舊版本使用相同編譯器、驅動與硬體;若因新版要求必須變更建置方式,另開一組比較,避免把編譯條件差異算到版本頭上。
llama.cpp 官方的 llama-bench 可執行 prompt processing(提示詞處理)、text generation(文字生成)及兩者合併的測試,並輸出平均 token/s(每秒 token 數)與標準差。它適合用來觀察核心推論路徑,但官方文件也指出,這些量測不包含 tokenizer(分詞器)和 sampling(採樣)的耗時。因此,bench 數字不是完整服務延遲;使用者還要記錄模型載入時間、首 token 等待、端到端回應時間、記憶體占用和併發下的等待情況。
測試應重複多次,分辨穩定差異和單次波動。若平均速度增加但標準差很大、顯示記憶體用量升高,或長上下文失敗率增加,單看 token/s 不足以決策。比較時將 prompt processing 和生成速度分開,因為前者反映讀入上下文的效率,後者更接近逐字產生的速度;兩者對使用情境的影響不同。
對台灣自行部署模型的個人開發者與小型團隊,這組結果可以回到實際採購和維運選擇:新版若改善常用模型的生成速度或修掉既有故障,便可先在隔離環境驗收;若瓶頸來自記憶體、排隊或應用程式整合,單純更新推論工具未必能解決問題,也不應只因 release notes 列出硬體最佳化就急著更換設備。
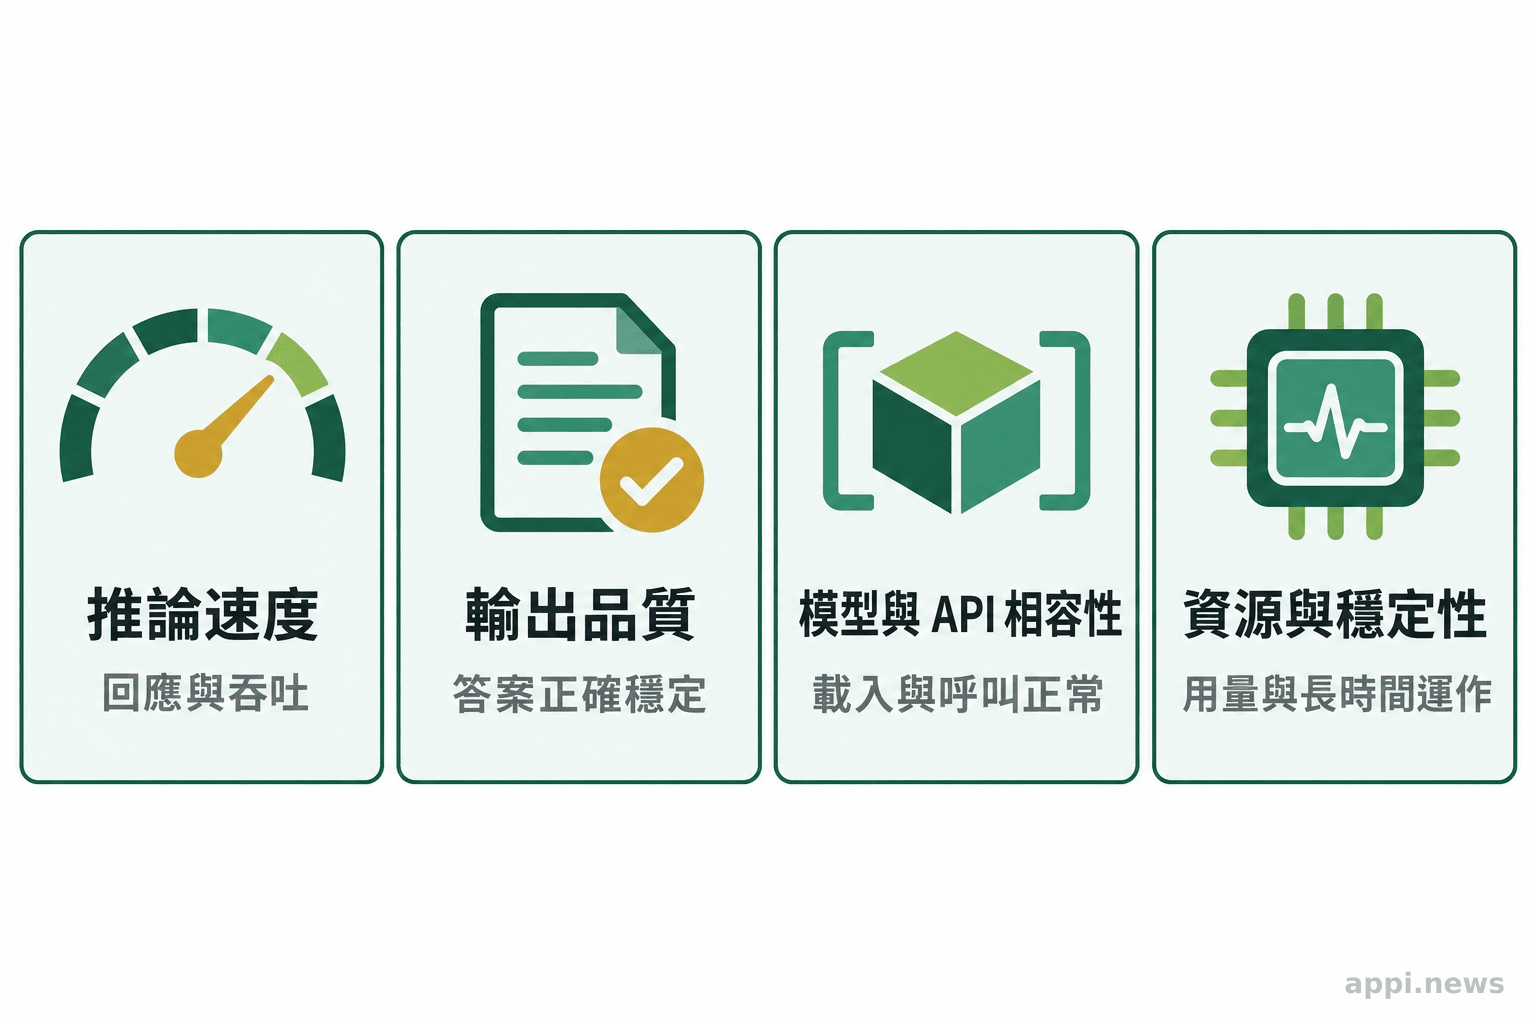
| 比較面向 | 固定或記錄的條件 | 判讀重點 |
|---|---|---|
| 推論速度 | 同一模型、提示長度、輸出 token 數、batch 與 backend | 分開看提示處理速度和生成速度,記錄平均值及波動 |
| 輸出品質 | 相同提示詞、採樣參數、停止條件與格式要求 | 比對答案內容、JSON/schema 合規、工具呼叫及重複輸出 |
| 相容性 | 模型檔、量化、tokenizer、模板、啟動命令與 API | 確認載入、生成、圖片或工具流程均能完成 |
| 資源與穩定性 | 記憶體、VRAM、載入時間、長上下文、併發數 | 檢查是否增加資源需求、崩潰或請求失敗 |
記錄速度、輸出穩定性與相容性
效能測試要包含真實工作負載,不能只跑一次簡短的基準提示。短輸入可能看不出長上下文的差異;單一使用者結果也未必反映 server/router 同時處理請求時的排隊與記憶體壓力。如果使用 llama.cpp 提供的 server,另外保留代表性的請求記錄,檢查新版本的多位址綁定、路由和模型載入變化是否符合現有部署腳本。
輸出品質則需設定可重現的檢查點。溫度等隨機採樣參數可能造成答案文字不同,所以可以固定 seed(若流程支援),但也要評估實際部署中的非固定輸出。若應用要求 JSON、工具呼叫或特定 schema,應檢查格式是否可解析、必填欄位是否保留、工具名稱與參數是否正確。對摘要或問答等任務,可以用人工核對樣本或既有評分程序確認答案是否改變,不要把文字不同直接等同於品質變差或變好。
速度提升是否值得採用,還要看使用者感受到的瓶頸。若等待主要來自載入模型、排隊、網路或應用伺服器,核心推論的 token/s 增加未必能縮短整體等待。相反地,對離線批次處理而言,吞吐量可能比單一請求的首 token 延遲更重要。先定義要改善的指標,再決定測試結果是否達標,避免為了追新版本而改動穩定流程。
升級評估可以依序完成:
- 列出現況:保存目前 llama.cpp 版本、建置選項、運算後端、驅動、模型檔與量化格式。
- 對照官方條目:查看 v0.5.0 release notes 和相關變更連結,標記與現用硬體、模型或服務功能相符的項目。
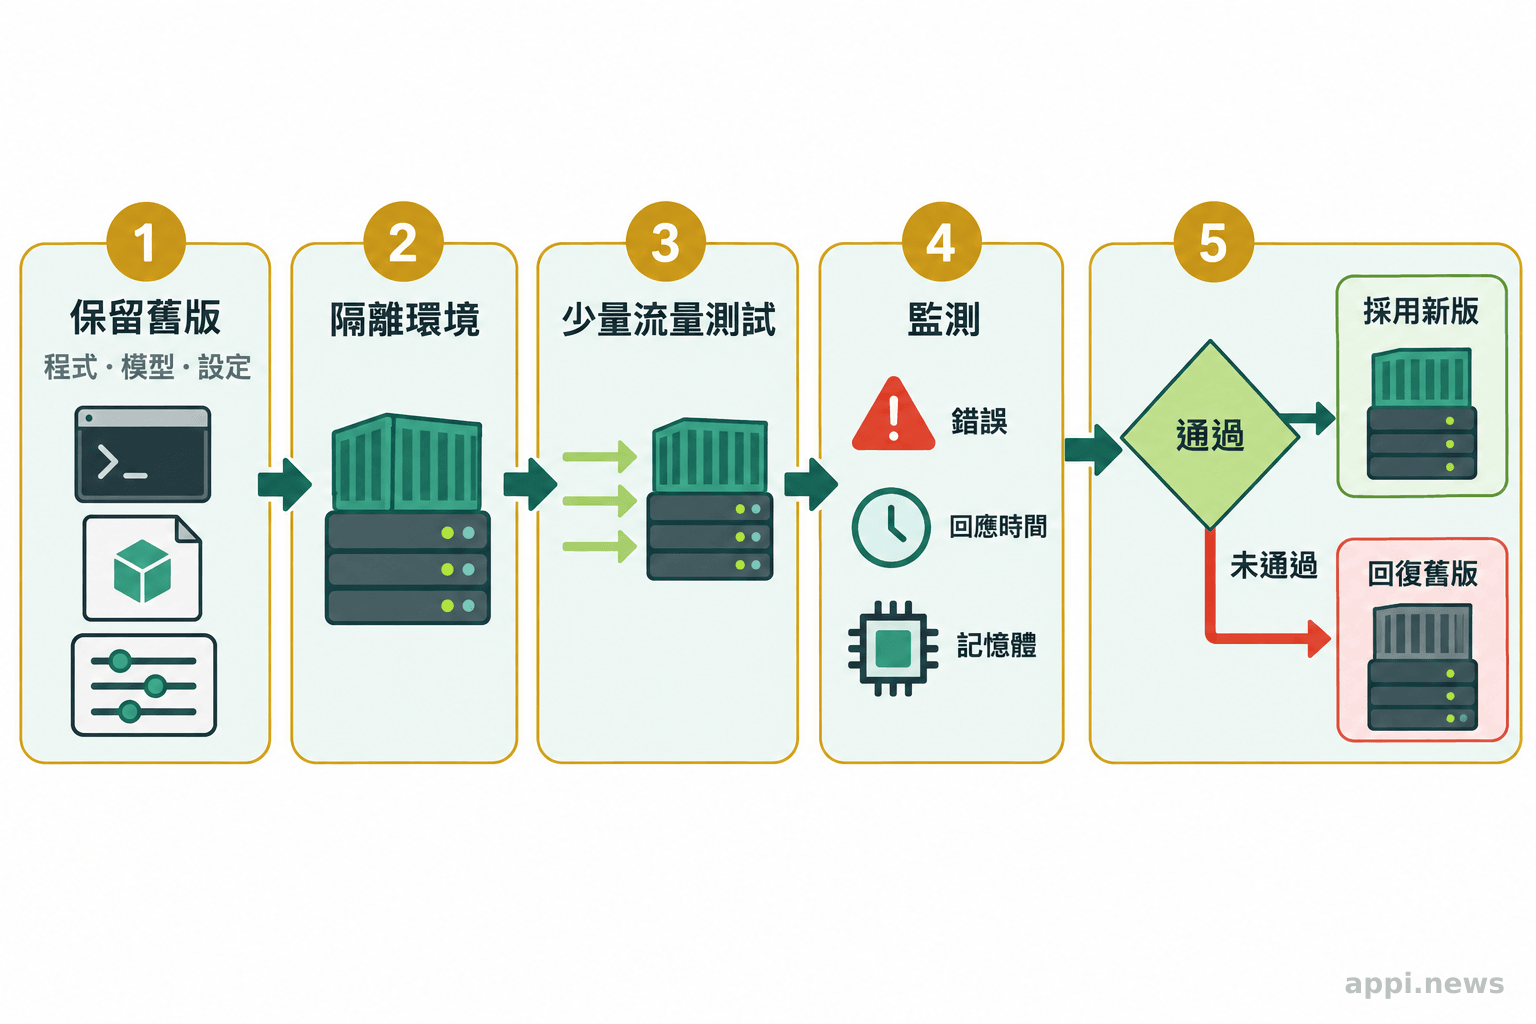
- 準備隔離環境:保留舊執行檔或容器映像,在測試環境建置 0.5.0,避免直接覆寫正式服務。
- 重跑固定案例:以同一組提示詞、上下文、參數與並行度,重複測試速度、輸出格式、錯誤率和資源用量。
- 設定採用門檻:確認相容性無退化,且改善了事先定義的目標,再安排部署與監測;若結果不合格,回復原版本並保留差異紀錄。
四、升級前先備妥回退與檢查清單
先備份舊版執行環境、模型與啟動設定,並安排可回復的測試流程。官方 release notes 能協助定位更新內容,正式採用前仍要確認自己的建置、模型與服務介面都能正常運作。
llama.cpp 版本更新可能牽涉建置依賴、模型解析、後端核心、server/router 和客戶端介面。直接把正式環境替換成新版,會讓問題難以歸因,也會增加服務中斷時的復原成本。可先把新舊版本放在獨立目錄、容器或不同服務埠,讓請求樣本在隔離環境重播。記下編譯器、CMake 選項、CUDA 或其他 backend 套件版本,讓測試具備可追溯性。
回退也不只是換回一個二進位檔。部署腳本若同時改了啟動參數、模型檔案位置、環境變數或 API 代理設定,回復時需一併還原。若模型在升級過程中重新轉檔或覆寫快取,先保留原始權重與設定,確保故障時仍可重現舊版行為。對多使用者服務,先限制測試流量,再逐步觀察請求錯誤、回應時間和記憶體狀況。
準備檢查清單時,應把「符合官方更新項目」與「通過自家驗收」分成兩欄。前者是推論相關性,例如你的模型是否使用 MoE、實際是否啟用 CUDA 或 Metal;後者則看更新版能否載入指定 GGUF、維持對外 API 格式、完成並行請求並符合效能與錯誤率門檻。若官方變更似乎相關,但實測沒有改善,也不必為版本號本身承擔額外維護成本。
- llama.cpp 0.5.0 已有官方 release notes;更新項目包含後端最佳化、正確性修正、模型與轉換支援,以及 server/router 調整。
- 版本清單不等於通用效能保證。先確認更新是否對應自己的 backend、模型架構和工作負載,再以固定條件比較新舊版本。
- 正式部署前保存環境與模型,檢查輸出、相容性、資源與回退方式,依實測結果決定是否採用。
參考文獻
- ggml-org (2026). Release v0.5.0 · ggml-org/llama.cpp. GitHub. https://github.com/ggml-org/llama.cpp/releases/tag/v0.5.0
- ggml-org (2026). Release v0.25.0 · ggml-org/ggml. GitHub. https://github.com/ggml-org/ggml/releases/tag/v0.25.0
- ggml-org (2026). llama.cpp/tools/llama-bench README. GitHub. https://github.com/ggml-org/llama.cpp/blob/master/tools/llama-bench/README.md
常見問題
Q1:llama.cpp 0.5.0 已經發布了嗎?
是。官方 GitHub 的 v0.5.0 發布頁列有版本資訊、更新摘要及 changelog。發布日期與其後狀態應以官方頁面為準;使用者若需要確認目前最新版本,應查看官方 Releases 清單。
Q2:升級到 0.5.0 後,所有模型都會跑得更快嗎?
不能這樣推論。release notes 所列最佳化對應特定後端、算子或模型架構,未提供對所有設備與工作負載的通用效能幅度。需用實際硬體和常用模型測試。
Q3:新增模型支援代表下載 GGUF 就能直接使用嗎?
不一定。條目可能指模型架構支援、轉檔工具更新、特定推測解碼或算子支援,意義不同。載入前還需核對檔案格式、量化、tokenizer、對話模板和執行工具。
Q4:可以用 llama-bench 的結果決定是否部署嗎?
它能比較提示詞處理和文字生成等推論速度,但測量不包含 tokenizer 與 sampling 時間。服務部署還需檢查端到端延遲、資源用量、輸出格式、錯誤率及併發表現。