
2026 年 10 月的 Maintainers Summit(核心維護者峰會)討論了是否保留 AI 輔助程式碼的 Assisted-by 強制標註。共同維護者 Sasha Levin 在 10 月 9 日提交移除相關文件要求的修補程式,並於 10 月 13 日補上討論背景;修補程式 10 月 14 日已由文件維護者套用至 docs-next,docs.kernel.org/next 也已移除 Assisted-by 要求,但 kernel.org 目前發布的穩定版指引仍保留舊條文。判讀狀態時要分清文件分支與發布版本。
很多人看到「取消標註要求」,第一個反應是提交者從此不用為 AI 協助寫出來的程式碼負責。這個理解把兩件不同的事混在一起談。Assisted-by 是揭露工具參與的訊號;Signed-off-by 是人類提交者依 DCO(開發者原創聲明)作出的聲明。官方指引另要求提交者審查 AI 生成程式碼、確認授權合規並承擔貢獻責任。
Linux 核心的 Assisted-by 規則調整到哪一步?
移除 Assisted-by 的修補程式已套用至 docs-next,下一版文件已移除標註要求;kernel.org 穩定版指引仍保留舊條文,兩種狀態分別對應開發中與已發布文件。
峰會討論後,Sasha Levin(Linux LTS 核心共同維護者)於 10 月 9 日送出移除 Assisted-by 文件要求的修補程式。有人要求補充理由後,Levin 於 10 月 13 日提交 v2;文件維護者 Jonathan Corbet 在 10 月 14 日回覆已套用至 docs-next。docs.kernel.org/next 已反映這項變更,發布中的穩定版指引則尚未更新。
這裡要先把問題定義清楚:峰會討論、修補程式送出、文件合併、正式生效,是四個不同的階段,不能互相取代。
提案、文件合併與正式生效要分開確認
| 項目 | 查核時官方文件(kernel.org)的內容 | 10 月修補程式的內容 |
|---|---|---|
| Assisted-by 標註 | 文件仍要求貢獻加入 Assisted-by 標籤 | Sasha Levin 提案刪除文件中的標註要求 |
| Signed-off-by | AI 代理一律不得簽署,須由人類提交者簽署 | 這項規定未被討論異動 |
| 揭露方式 | 穩定版文件以 commit 標籤呈現 | v2 提案建議在 patch 系列說明信(cover letter)描述工具如何參與 |
| 判定生效的依據 | 穩定版 Documentation/process/coding-assistants.rst 仍有標籤要求 | 已套用至 docs-next,docs.kernel.org/next 已移除要求 |
Levin 的 v2 說明稱,峰會中支持移除標籤的共識強烈但並非全體一致。文件維護者已將 patch 套用至 docs-next,docs.kernel.org/next 隨之移除要求;穩定版 kernel.org 文件仍保留原規定。使用者要判斷手邊依循的是哪一版規則,應先確認所查文件分支。
郵件討論中仍有不同看法:有人認為標籤已失去辨識作用,也有人質疑取消後是否會讓工具使用情況更不透明。提案反映的是提交者對峰會討論的整理,不能推成所有維護者立場一致。
AI 使用標註原本想補上什麼訊號?
Assisted-by 用來記錄工具參與;Signed-off-by 是人類提交者依 DCO 作出的聲明。官方指引另要求提交者審查 AI 生成程式碼、確認授權合規並承擔貢獻責任,兩者功能不同。
Assisted-by 記錄工具參與,Signed-off-by 確認提交責任
這套標註規則的起點,是 2025 年的 Maintainers Summit 共識。Sasha Levin 當年 7 月先提出一份 RFC(Request for Comments,徵求社群意見的草案提案,用於尚未定案、需要先收集回饋的規則變更),原本打算用 Co-developed-by 這個既有標籤標示 AI 參與。David Hildenbrand 與 Konstantin Ryabitsev 指出一個結構性問題:Co-developed-by 依照慣例必須搭配 Signed-off-by 一起出現,而 AI 代理不能、也不該簽署 Signed-off-by,因為這個標籤對應的是 Developer Certificate of Origin(DCO,開發者原創聲明,提交者藉此聲明自己有權提交這段程式碼、且其授權相容),應由人類提交者作出。
這個結構性問題促成了 Assisted-by 這個新標籤:用它標示工具參與開發,跟「誰對這段程式碼負責」的聲明分開處理。格式是 Assisted-by: 工具名稱 [輔助用的靜態分析工具],像 git、編譯器這類基礎工具不列入,列的是 coccinelle、sparse 這類專門用來抓問題的分析工具。2025 年 12 月,這套規則連同標籤格式一起寫進 Documentation/process/coding-assistants.rst,由文件維護者 Jonathan Corbet 核准合併。
kernel.org 的 AI 輔助開發指引把提交責任列在人類提交者身上:提交者須審查 AI 生成的程式碼、確認授權要求、簽署 DCO,並對貢獻負責。這些要求與是否使用 Assisted-by 標籤分屬不同環節。
標註能否反映實際使用情況
標註規則訂出來後,真正要追問的是:它有沒有做到原本想做到的事。Sasha Levin 在 10 月 13 日提交的 v2 說明中指出,Linux 7.3 到候選發布版第七版(-rc7)共 18,533 筆非合併提交,約一成帶有 Assisted-by 標籤。這是提交紀錄中的標籤比例,不代表實際 AI 使用率;未標註可能是沒有使用,也可能是使用後未標。
Sasha Levin 在 v2 說明中表示,維護者仍希望了解 patch 的製作方式,但峰會討論認為應放在說明信中,交代工具如何參與,而非放在 commit changelog 的標籤。Levin 也指出有人不知道規則、有人刻意不標,且維護者很少追問;這是提案說明中的判斷,標籤資料本身無法換算成實際使用率。
遵循率低背後有幾個原因在疊加:有人不清楚規則存在,有人清楚規則但覺得標註沒有實質好處,也有人認為幫特定廠商的商業模型打名字,等於替對方做免費的技術背書。這幾個原因不是互斥的,標註制度同時撞上了「規則知不知道」「值不值得做」「願不願意幫廠商曝光」三層問題,單靠重申規則很難解決。
- Assisted-by 標示工具參與;Signed-off-by 是人類提交者依 DCO 作出的聲明,提交者另須審查程式碼並承擔貢獻責任
- Levin 的提案說明稱,Linux 7.3 到 -rc7 約一成非合併提交帶有 Assisted-by 標籤,不能據此推算實際 AI 使用率
- 取消的是「強制標註」這項要求,提交者審查與簽署責任的規定沒有被異動
取消標註要求後,程式碼審查如何承接?
靠原本就存在、且沒有被這次調整碰到的審查機制:程式碼本身的測試與風格檢查、授權合規性查核,以及提交者的 Signed-off-by 聲明。
從程式碼、測試、授權與變更脈絡驗收
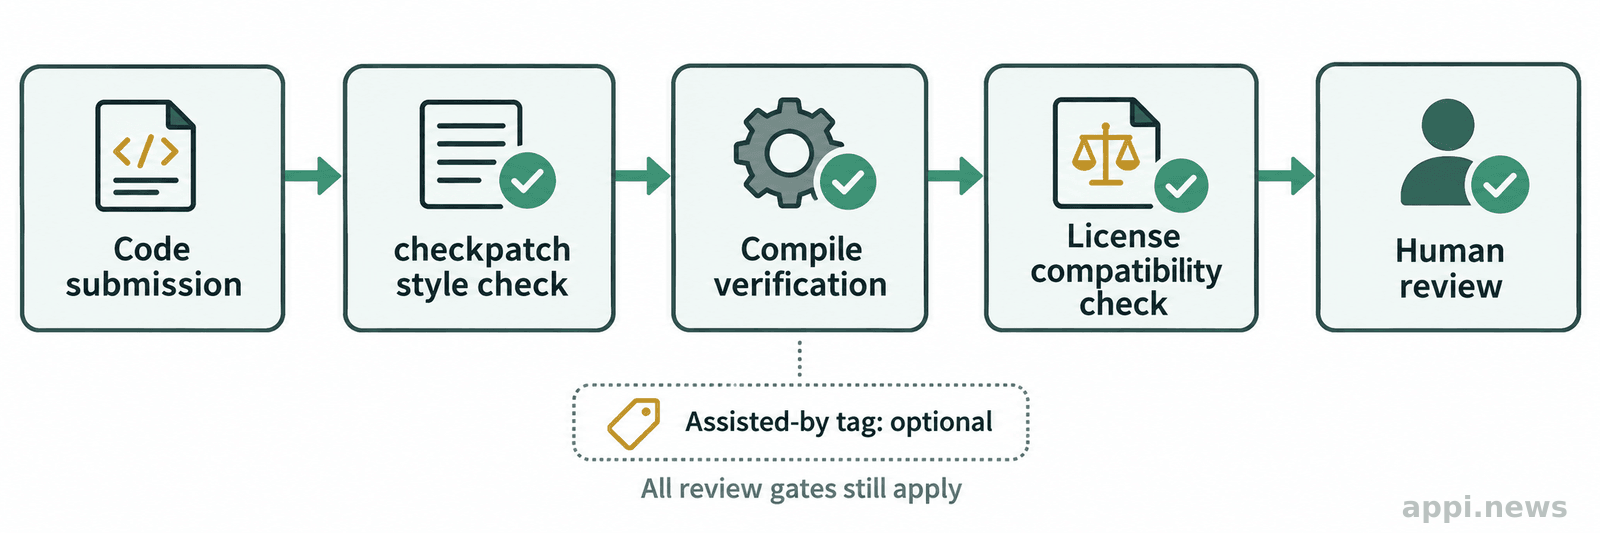
不論標註要不要強制,Linux 核心原本的驗收機制從未單獨依賴「這段程式碼是不是 AI 寫的」這個訊息。送審的程式碼一樣要通過 checkpatch.pl(核心的程式碼風格與常見問題檢查工具)、一樣要編譯無新增警告、一樣要符合 GPL-2.0-only 的授權相容性並附上正確的 SPDX 授權識別碼。這些檢查點看的是程式碼本身的狀態,不是它的生產過程,取消標註要求不會讓這幾層把關消失。
真正受影響的,是審查者原本可以用來判斷「這段 diff 要多花多少心力去讀」的一個輔助線索。少了這條線索,審查者仍然可以從變更的脈絡(修改幅度、涉及的子系統、是否處理過往已知的邊界情況)去判斷風險,只是少了一個現成的提示。
提交者、審查者與維護者的責任界線
要先把角色分清楚,責任界線才會清楚。文件裡對人類提交者的要求本來就很具體:審查所有 AI 生成的程式碼、確認授權與合規要求、自行加上 Signed-off-by、對這份貢獻負完全責任。這四項要求跟 Assisted-by 標籤是否強制,是兩條不相干的規則線。
AI 代理這一側的責任同樣寫在文件裡:修 bug 前要完整讀過流程文件,不能只靠關鍵字搜尋片段;非顯而易見的問題要先嘗試建立可重現的步驟,驗證不成立就該停下來;修改後要能編譯、不能新增警告、要通過風格檢查;做不到的部分要明確說出來;最重要的一條是,AI 助手本身不得自行送出任何內容,送出的動作一定要經過人類這一關。
換成責任鏈的角度看:AI 產出 → 人類審查與測試 → 人類簽署 Signed-off-by → 維護者決定是否合併。Assisted-by 標籤原本是插在第一步後面的一個標記,拿掉它,責任鏈的其他三個環節原封不動。
團隊怎麼把 AI 使用揭露和驗收流程分開設計?
先問稽核目的再決定要不要留紀錄,驗收流程則一律照程式碼本身的品質把關,不依賴揭露標籤是否存在。
依稽核目的決定內部留存哪些使用紀錄
Linux 核心這次調整給團隊一個可以直接參考的判準:標註要不要做、做到什麼細節,取決於有沒有人真正要用這份紀錄做事。核心社群原本收集標籤資料的目的一直不夠明確,這是遵循率低的原因之一,也是這次討論裡被提出來檢討的一點。
團隊內部決定是否要求標註 AI 使用,可以先問三個問題:這份紀錄要給誰看、要解決什麼具體的稽核或安全需求、不留這份紀錄會不會讓某個既有的責任追溯環節斷掉。授權合規性查核、資安事件回溯、內部模型使用情況盤點,是三種常見但各自需要不同粒度資料的目的,不是同一份標籤就能滿足。
建立提交、測試、審查與例外處理檢查點
不論是否要求揭露 AI 使用,程式碼驗收流程本身應該具備幾個固定的檢查點:
- 提交前自檢:風格檢查、編譯驗證、既有測試套件跑過一輪,這一關跟程式碼來源無關,一律要做。
- 授權與合規查核:確認引入的程式碼與專案授權相容,必要時標示授權識別碼。
- 人類審查與責任簽署:指定實際審查者,審查者的簽署對應明確的責任歸屬,不因協作工具不同而省略。
- 例外與回退機制:定義審查者發現問題時的退回路徑與再提交條件,避免「審查沒通過但沒人知道該怎麼處理」的空白。
- 定期回顧稽核目的:內部若有留存 AI 使用紀錄,定期檢視這份紀錄是否還對應到原本設定的稽核用途,用不到就該停止蒐集。
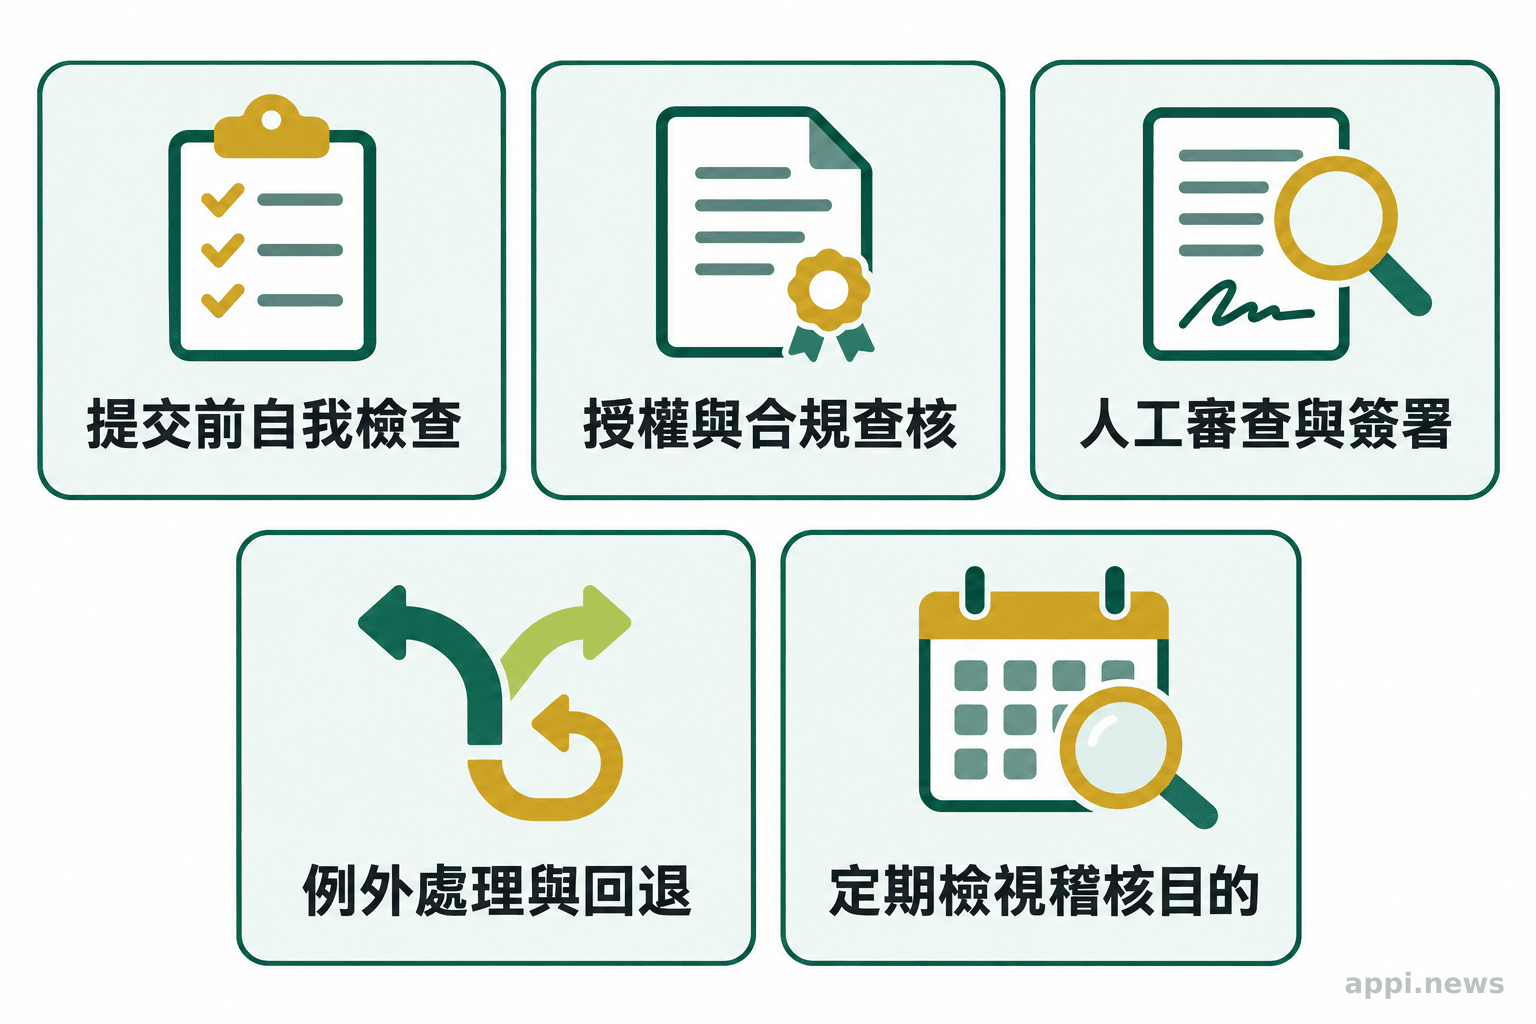
這五個檢查點不是為了取代標註制度而新發明的東西,它們原本就該是任何審查流程的基本配置。Linux 核心這次調整提醒的是:揭露工具用了什麼,跟驗收程式碼本身的品質與責任歸屬,是兩套可以分開設計、也應該分開設計的機制。混在一起做,遇到遵循率低的狀況時,連基本的審查把關都會被一起拖著懷疑。
常見問題
先確認自己的審查與簽署流程是否本來就不依賴標註標籤,再決定要不要保留內部版的 AI 使用揭露機制。
Q1: 不要求 Assisted-by 是否代表不用揭露 AI 使用?
不是同一件事。標註要求是否改變,不會自動改變提交者對貢獻內容的責任;取消的是「必須用這個特定標籤」的強制性,團隊或專案仍可自行決定要不要用其他方式(例如修補程式系列的說明文字)揭露 AI 參與的事實。
Q2: AI 產生的程式碼由誰負責?
由人類提交者負責。AI 代理不得自行送出內容或簽署 Signed-off-by;官方指引要求人類提交者審查 AI 生成程式碼、確認授權合規、自行簽署 DCO,並對貢獻負責。這些要求與 Assisted-by 標籤是否強制無關。
Q3: 團隊是否仍可保留內部 AI 使用紀錄?
可以。團隊可以依內部稽核、授權追蹤或安全需求,自行設計要保留哪些使用紀錄、保留到什麼細節,不必比照 Linux 核心社群公開標籤的做法,也不必因為核心社群調整了標註要求就跟著調整自己的內部規則。
參考來源
- Sasha Levin (2025). Documentation/process/coding-assistants.rst. kernel.org
- Sasha Levin (2025). README: add AI Coding Assistants section. *Patchew
- Phoronix (2025). Linux Kernel Proposal Documents Rules For Using AI Coding Assistants
- lilting.ch (2026). Linux Kernel Source Tree Gets Official AI Coding Assistant Policy
- LWN.net (2026). Leading items. *LWN.net
- Michael Larabel (2026). Linux Kernel Developers Plan To Remove "Assisted-By" Tag Requirement For AI/LLM Usage. *Phoronix
- Sasha Levin (2026). [PATCH v2] docs: remove Assisted-by references. *Linux Kernel Mailing List archive
- Linux Kernel Documentation. AI Coding Assistants (next)


