
目錄(4 節)
Kimi 分析完資料,研究就完成了嗎?據 The Decoder 2026 年 11 月 16 日報導,DP Technology 將 Kimi K3.1 Pro 整合進研究助理 BioMaster,在一次測試中分析 3,696 個小鼠胰臟細胞的基因資料,約 90 分鐘提出 100 個候選基因;人工參考工時估為四小時。報導來源
這是單次示範與估算工時,尚不足以證明已由獨立團隊重現,也不能代表其他資料集或研究任務的效能;候選基因仍待研究者篩選、驗證。對正在替實驗室或研發部門選模型的台灣技術團隊,問題隨之出現:程式排行榜上的高分,能回答它是否適合科學研究嗎?
為什麼 Moonshot AI 把 Kimi 研發重心轉向科學任務?
Moonshot AI 將程式基準進步趨緩列為轉向理由,並把生物、化學與藥物研究視為下一階段方向;這是公司的策略判斷。
據 The Decoder 轉述,Moonshot AI 國際業務主管 Giacomo Ficari 在里斯本 Web Summit 表示,科學研究對模型智慧的要求高於法律、金融或程式工作。
先追問一層:分數為什麼變得難進步?可能是既有題目接近飽和,也可能是評分方式難以辨識新的能力,或模型在長流程任務仍有瓶頸。這些是評測設計需要排查的解釋,不能只憑公司發言就認定整個產業遇到同一個上限。
程式能力仍是研究工具的一部分。資料清理、統計分析、模擬與繪圖都可能需要寫程式;科學任務另外要求選對分析方法、辨識資料偏差,以及判斷結果能支持什麼結論。程式成功執行,只完成其中一關。
選型時可把需求寫得更具體:團隊缺的是產生分析腳本的人手,還是缺少判斷研究方向的能力?前者可測程式正確性與修正工時,後者還要安排領域專家評分。兩種需求若混在同一個總分,採購就容易獎勵錯誤的能力。
這也關係到模型更新後如何重新驗證既有評測:研究路線改變時,應先檢查成功條件是否跟著改變,再決定沿用哪些測試。
BioMaster 的候選基因與 TCSExam 的通過結果差在哪?
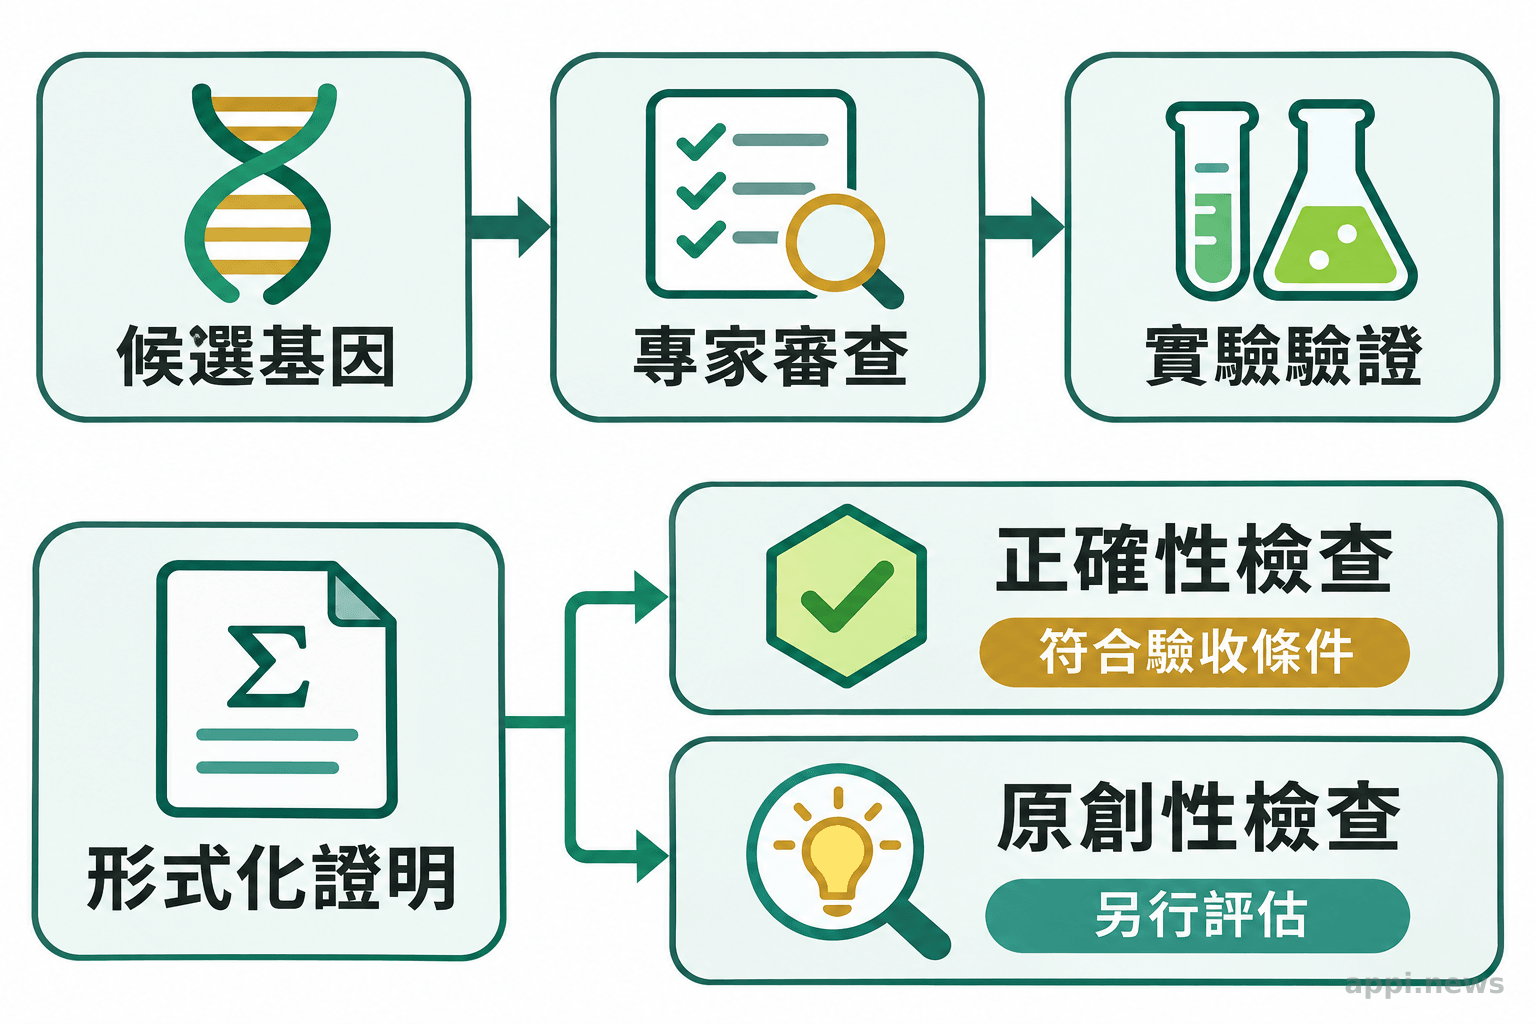
候選基因提供下一步調查的對象;基準通過代表符合指定題目的驗收規則,還須另查答案是否具有原創性。
BioMaster 案例給選型者的啟示,是把「產生清單」和「清單值得投入實驗」分開評估。候選數量越多,人工審查與後續實驗也可能增加。若只計算模型完成分析的時間,容易漏掉研究者排除錯誤線索的成本。
要檢驗可重現性,可先讓另一位分析者依相同資料與流程重跑,核對候選清單、篩選依據及分析腳本;要檢驗代表性,則需另換資料來源、樣本條件或研究問題。兩者回答的問題不同,重跑成功仍不足以推論跨任務表現。
另一種驗證方式可見於 TCSExam 官方評測。這套理論計算機科學測試的完整題組有 100 題,涵蓋定理證明、求解程式、構造與開放猜想;部分成果交由 Lean(形式化證明檢查系統)或可執行檢查器驗收。
讀分數時還要核對題目組成、提示方式與推理預算。提示有沒有附解題範例、是否要求自我檢查,都屬於測試條件;推理預算則是容許模型思考與嘗試的資源,例如運算時間、產生文字量及重試次數。這些條件連同工具權限、評分規則,都可能影響基準結果。
TCSExam 官方也區分測試流程:完整題組允許取得中途評測回饋,精簡題組則在公開樣本上開發,再對隱藏樣本做一次最終評測。比較結果時,應先核對使用哪一種流程,避免把額外回饋帶來的修正機會全歸因於模型能力。
但通過驗收與獨立發現仍有距離。官方特別註明,Kimi K3.1 Pro 等模型在部分猜想題中,透過網路取得已公開成果,改編反例與證明後通過檢查。這顯示可驗證性與原創性必須分別記錄。
因此,台灣團隊若測試文獻重現,允許模型查找既有解法可能符合需求;若測試新假設生成,就要另設資料截止點,保留搜尋紀錄,並請專家排查是否重複已知成果。相同答案,在不同研究目標下有不同價值。
Anthropic ART 案例如何呈現研究證據的下一層?
ART 案例把模型搜尋出的線索接到人工審查與實驗室測試,提供了超過文字提案的證據,但系統功能仍在研究。
Anthropic 於 2026 年 9 月發布的說明指出,Claude 搜尋基因序列後找到 ART,即陣列相關逆轉錄酶系統。公司報告搜尋歷時 21 小時,後續由研究者分析並進行實驗;早期實驗觀察到相關陣列會表現為短 RNA。
Anthropic 的研究說明強調,所有實驗室工作均由人類科學家執行,ART 的主要功能仍在釐清。
這是探索階段的基礎生物研究,不能解讀成藥品療效或臨床建議。這些案例未提供用藥或保健品建議,也不涉及藥物交互作用的判斷。三個案例的任務、工具與投入不同,也不適合直接比較哪個模型較會做研究。
若要審查自己的專案,可以要求每項成果附上「下一位接手者需要什麼」:分析人員需要腳本和資料版本,領域專家需要假設與反證,實驗人員需要可測試的條件。只交一份流暢報告,會讓流程停在交接處。
台灣團隊如何設計科學 AI 的模型評測?
先用通用與領域基準篩選候選,再以組織自己的任務做對照測試,記錄人工覆核後的品質、時間與總成本。
以下是依任務拆解提出的評估方式。不同層次的測試各有用途,選擇取決於團隊現在要排除哪一種不確定性。
| 評測層次 | 適合回答 | 導入前仍要補測 |
|---|---|---|
| 通用基準 | 基礎推理、程式能力是否值得試用 | 自有資料與長流程表現 |
| 領域基準 | 是否符合特定科學任務的驗收規則 | 工具權限、資料截止點與評分差異 |
| 組織內工作流 | 能否減少實際修正與交接成本 | 換資料、換版本後是否仍成立 |
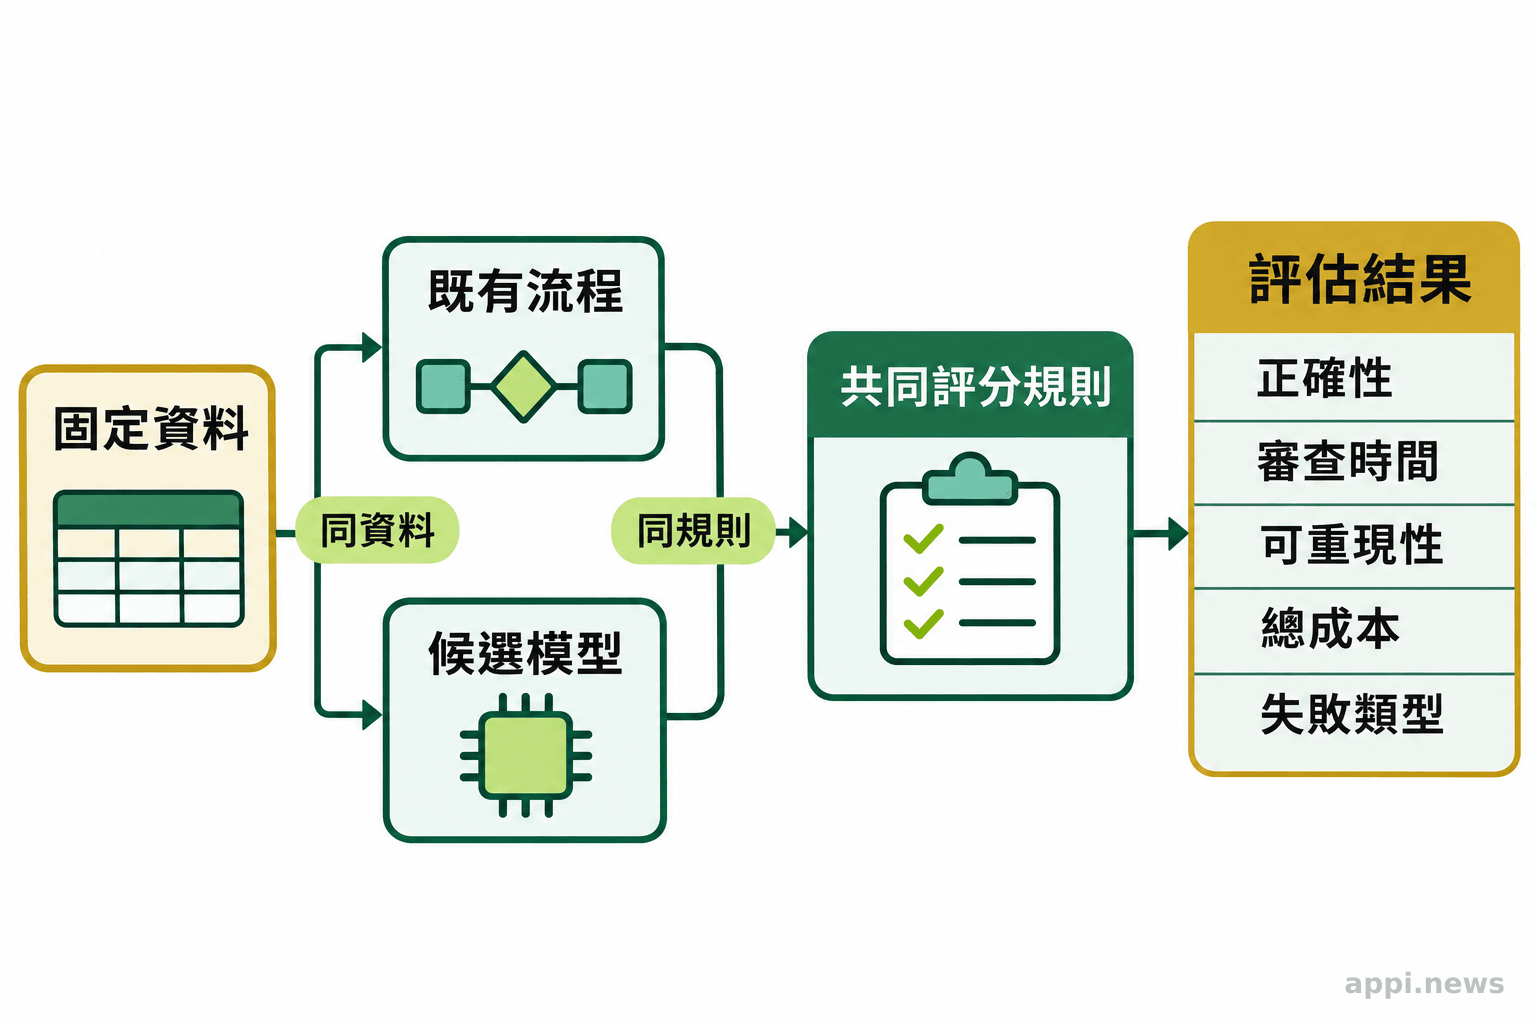
實作時可先固定共同提示與時間上限,測量相同條件下的差異;若另替各模型調整提示或增加推理預算,應將結果分開列示,連同調整工時與額外費用一起比較。如此才能判斷改善來自模型更換、流程調整,或投入更多資源。
對台灣導入者,第一關可以先設為資料能否使用:確認機構政策、資料權限、保存與刪除條件,再選可上傳的資料。測試帳號是否能在台灣註冊、付款、調用服務,以及研究者常用的中文術語能否正確對應,也應列入驗收。
-
固定任務與責任人:寫出觸發點、輸入、預期輸出、覆核者與後續行動,例如重現一項公開資料分析。
-
建立對照:讓候選模型與既有流程使用相同資料、工具權限和評分規則;保留一部分未用來調整提示的測試資料。
-
保存重現材料:記錄模型版本、提示、參數、程式環境、資料版本及工具呼叫,檢查他人能否依紀錄重跑。
-
計入完整代價:比較正確性、人工修正時間、延遲、重試、運算及實驗成本,另列會導致錯誤決策的失敗類型。
-
預先訂擴大條件:由團隊設定品質門檻與停止規則;只有達標才增加任務或資料範圍,換版本後重新驗收。
總成本可用「模型與工具費+資料整理費+人工覆核費+失敗重做費」估算。成功條件則要先寫好:漏掉關鍵結果與多列無效候選,哪個代價較高?若沒先回答,平均正確率很難支援決策。
最後檢查供應商依賴。資料、腳本與結果能否匯出?更換模型是否得重做工具串接?服務變動時誰維護?這些問題可接著用AI 模型選型的成本、資料與部署檢查逐項盤點。
常見問題
Q1:程式基準高分,適合拿來做科學分析嗎?
可作為初選依據。仍需測試方法選擇、資料處理與結論是否正確,並把領域專家的修正時間算進去。
Q2:科學 AI 可以獨立完成研究嗎?
要逐步確認它能完成哪些環節。產生候選、通過解題檢查及完成實驗,各自需要不同證據與責任人。
Q3:小規模測試有效,就能擴大採用嗎?
應先換一批資料重測,並保留失敗案例;模型、工具或資料條件改變時,也要重新確認品質門檻。
- 先寫出研究者拿到輸出後要做的下一步,再定義模型成功條件。
- 把答案正確、結果原創與實驗成立分開驗收。
- 挑一項公開資料任務開始對照測試,按覆核後品質與總成本決定是否擴大。


