
很多人看到 Jev 能從圖片回傳物件座標與信心分數,第一個問題是:結果能不能直接接進應用程式?更前面的問題是:目標不存在時如何辨識,判錯又會觸發什麼?TypeSafe AI 在 2026 年 10 月發布 Jev 1.14.0,新增 Box 物件定位,並以實驗旗標開放影像與長上下文。
一、Jev 1.14 新增什麼,哪些能力原本就有?
Jev 1.14 新增 Box(外框定位)問題型別,可回傳指定目標的單一外框;圖片輸入與長上下文是需另行啟用的實驗功能,Jev 1.13 也能使用。
TypeSafe AI 的發布說明指出,圖片可放進 API(應用程式介面)請求的資產欄位,Jev 1.13 也能使用。官方 Box 文件寫明,Box 需指定 jev-1.14.0 或 jev-preview。官方模型文件則說明,長上下文以另外的請求標頭開啟,1.14 與 1.13 都適用。
影像、Box 與長上下文都放在名為 danger zone 的標頭旗標後,需主動啟用;原廠表示尚未達正式環境可靠度,目前也缺少獨立的影像實測。
「all models (Jev included) perform worse on multimodality over pure text」(包括 Jev 在內的所有模型,處理多模態輸入都比純文字差)。出處:TypeSafe AI,Jev 1.14 發布說明。
二、結構化輸出為什麼比較容易接進程式?
決策模型依預先指定的型別回傳選項、分數、機率或座標,程式較容易按欄位分支;生成式模型多回傳自由文字,仍要解析。兩者都可能判錯。
| 比較項目 | Jev 決策模型 | 生成式文字模型 |
|---|---|---|
| 常見輸出 | 固定型別的選項、分數、機率或座標 | 自然語言文字,可依提示要求格式 |
| 程式整合 | 可按型別與欄位撰寫分支邏輯 | 通常還要解析文字或驗證結構 |
| 主要限制 | 欄位符合規格仍可能判錯;任務須先定義清楚 | 格式與措辭可能變動,解析需防錯 |
| 適合的工作 | 明確分類、評分、存在判斷、物件定位 | 解釋、摘要、生成內容、開放式問答 |
結構化輸出讓「如何讀取答案」變簡單,「答案是否可信」仍要另外處理。模型把相似物件分錯時,JSON(結構化資料格式)照樣合法;若後端把座標當成機器手臂的動作目標,錯誤欄位也可能觸發實際操作。輸入檢查、答案驗證、執行權限與回復方式要一起設計。
OWASP 生成式 AI 安全專案也把模型輸出未經驗證就交給下游系統,列為「輸出處理不當」風險。
三、Box 座標和信心分數要怎麼解讀?
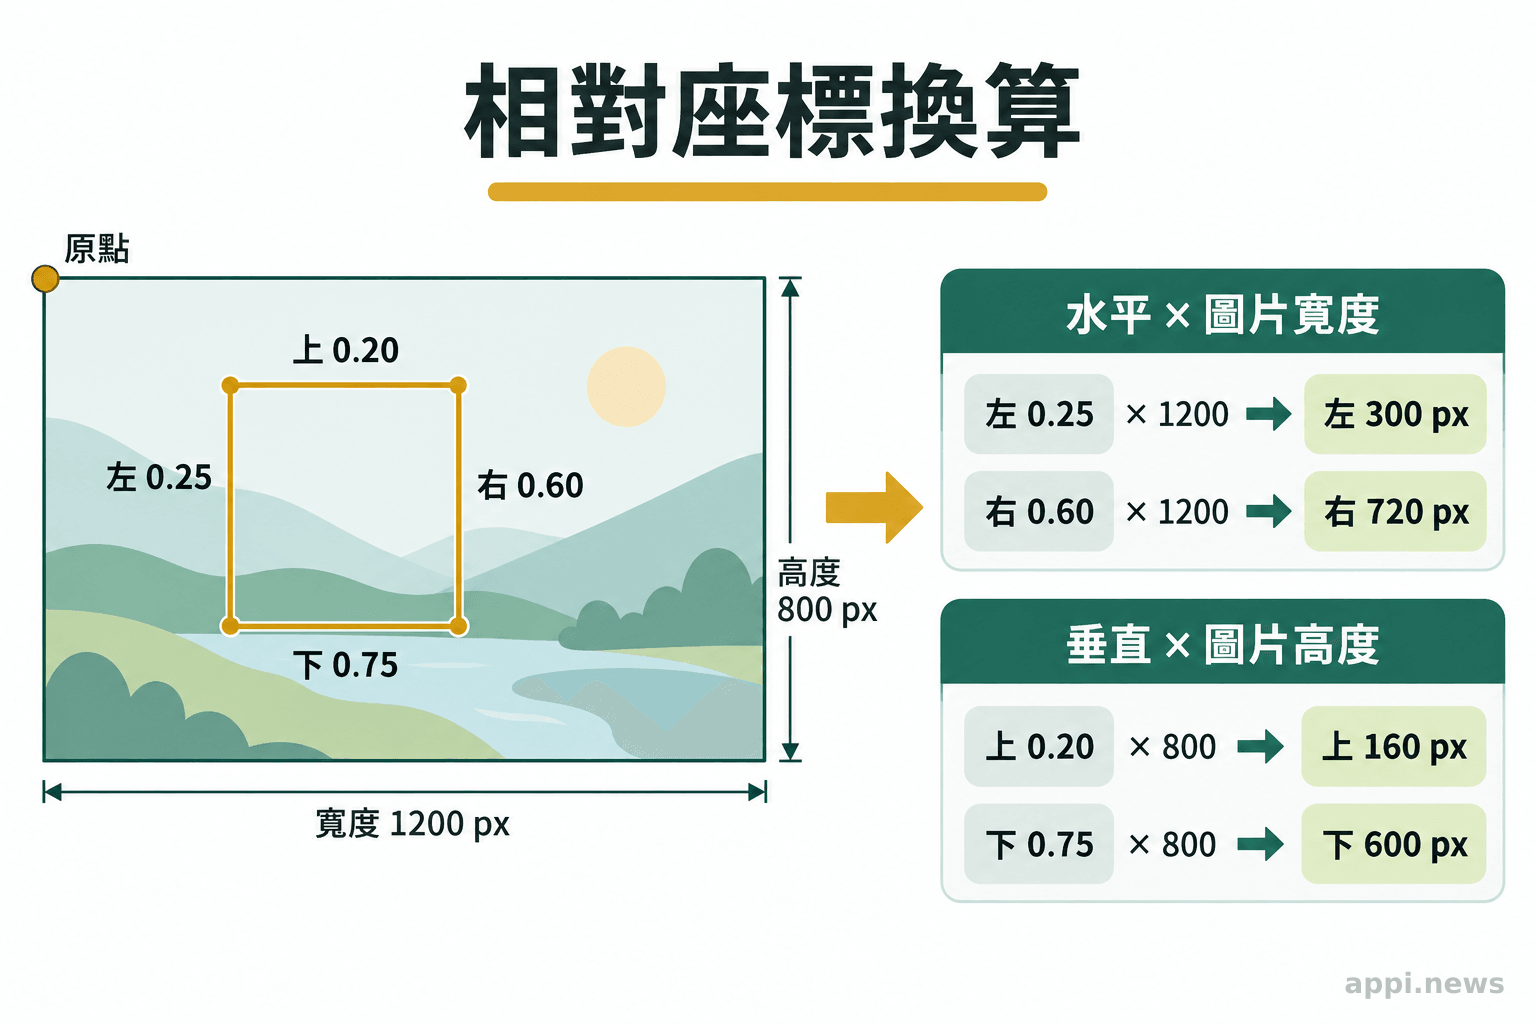
Box 以圖片左上角為原點,回傳 0 到 1 之間的四邊相對座標與信心分數。官方文件說明分數越高代表模型越有把握;實務上不應直接解讀為正確機率。
假設圖片寬 1,200 像素、高 800 像素,回傳 left 0.25、right 0.60、top 0.20、bottom 0.75,乘上寬、高後約為左 300、右 720、上 160、下 600 像素。前處理若有縮放或裁切,座標要依相同轉換還原,否則畫回原圖會偏位。
Box 每題只給一個框,多個相同物件或需要精細輪廓時未必適用。官方 Box 文件說明,Box 沒有「未找到」的答案,建議同一請求搭配 noul(是非問題型別)確認目標是否存在;兩者矛盾時應交人工覆核或重新拍攝。
官方文件也表示目前沒有建議的信心門檻,要用自己的圖片調整。可用標註資料比較分數、框的誤差與任務成敗,再依錯誤成本設定門檻。Guo 等人的研究也發現,現代神經網路常有校準不佳的問題,信心分數與實際正確率並不一致。
四、哪些條件會讓圖片判斷失準?
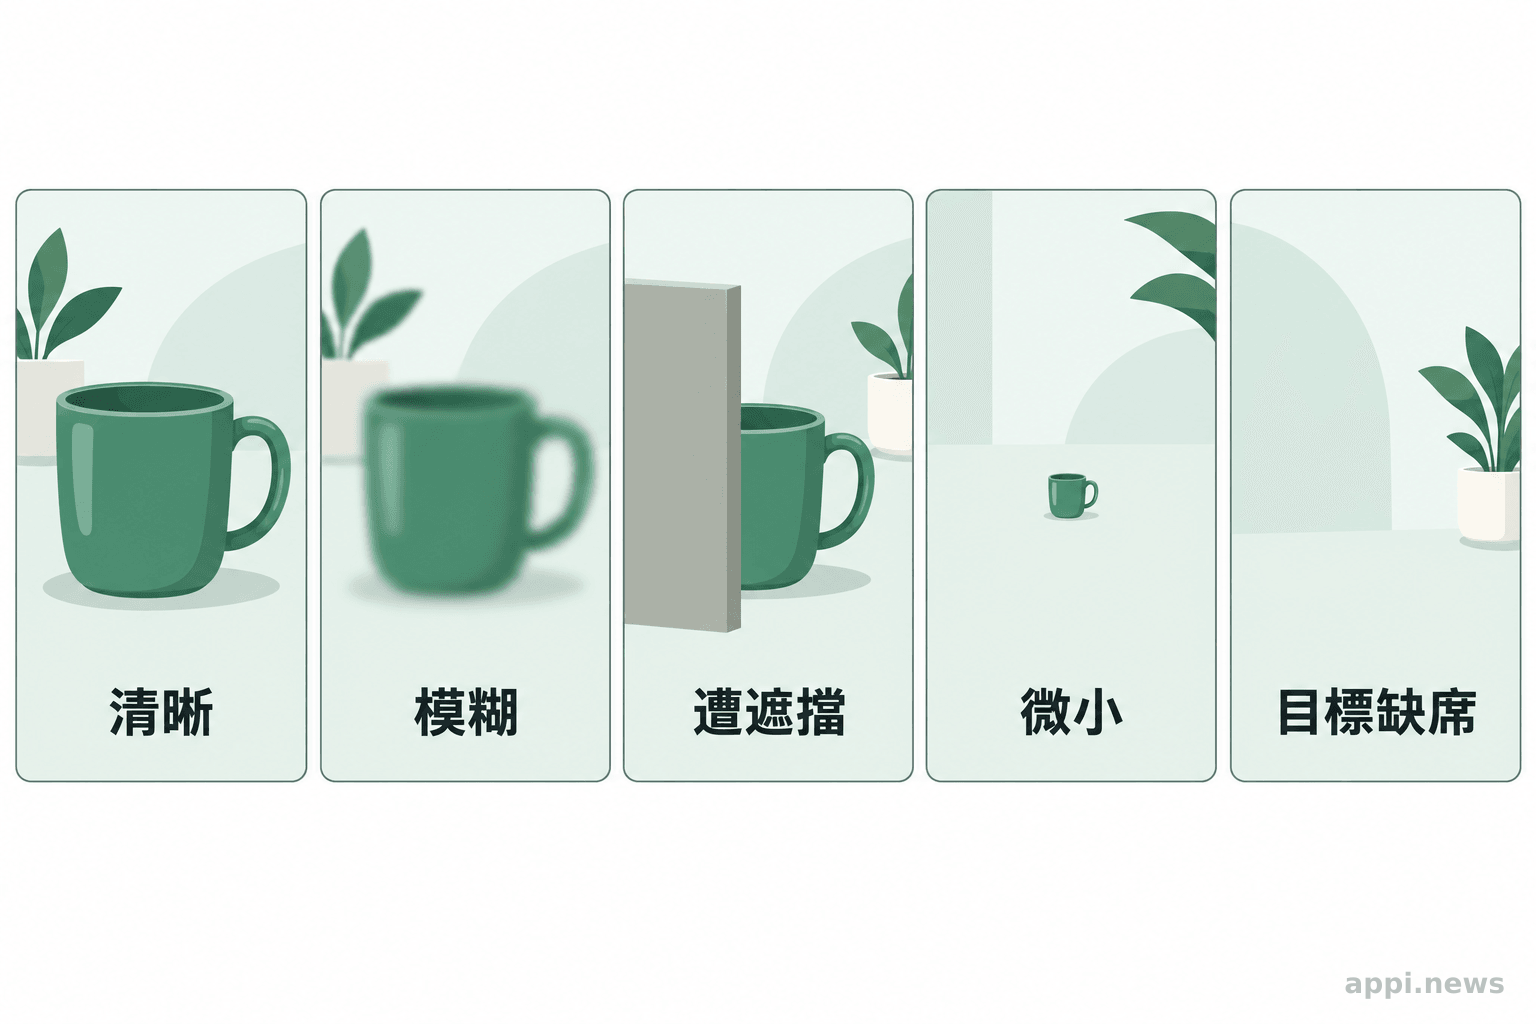
圖片模糊、目標太小、遮擋、相似物件、拍攝角度與描述不清的指令都可能影響結果,長上下文也可能降低可靠度。
低解析度、壓縮雜訊、反光與遮擋會讓目標特徵不完整,目標只佔畫面一角時,座標偏差影響更大。任務描述也會出錯:「找出杯子」沒說多個杯子時選哪個;「判斷文件是否有簽名」也要先定義哪些筆跡算簽名。
上下文變長能提供更多背景,卻不保證判斷更可靠。TypeSafe AI 在發布說明中表示,Jev 與其他模型一樣在較長上下文中可靠度較低;官方模型文件也說明,開啟長上下文會更慢、準確度更低。
「there is still way too much jaggedness for us to vouch for these for production use cases」(表現仍太不穩定,原廠無法為正式環境用途背書)。出處:TypeSafe AI,Jev 1.14 發布說明。
五、接入應用程式前要如何設計實測?
先用代表正式情境的圖片建立正例、反例與邊界案例,再設計低信心、答案矛盾與 API 失敗時的人工覆核或替代流程。
挑一項錯誤後果說得清楚的工作,把實際會遇到的圖片整理成測試集,加入目標不存在、遮擋、近似物件、不同光線與多個候選目標。每張圖預先標記目標是否存在與正確外框,並保留一批未用來調門檻的圖片做最後評估。
- 固定輸入與版本:記錄模型版本、圖片來源、前處理、問題文字與功能標頭。官方模型文件建議,依某版本調好門檻後改送該版本 ID,不用會自動更新的別名。
- 分開量測錯誤:分別統計存在判斷的誤判與漏判、座標偏差、低信心比例與答案矛盾。
- 設計分流門檻:低信心、答案衝突、逾時或服務錯誤時送人工確認,不執行不可逆操作。
- 保留可回復紀錄:保存模型版本、回傳欄位與覆核結果;原始影像可能含個資,只在除錯或稽核需要時留存。
- 升版前重測:換版本、開啟長上下文或改動前處理時,用同一批保留測試集重跑,並預先寫好回退方式。
六、哪些任務適合先試,哪些結果仍要人確認?
適合先試的是目標定義明確、錯誤可逆且能快速覆核的任務;涉及安全、金錢、權利或不可逆操作時,應保留人工確認。
標示待檢查區域這類工作,可先在有人確認下試用。若座標會直接控制設備、判定重要文件有效性,或觸發財務與個資相關動作,就需要獨立的安全檢查、人工覆核與停止機制。
為降低供應商依賴,可在內部定義中介格式,保存目標是否存在、座標、信心分數、模型版本與錯誤狀態,再由轉接層轉換原始回應,換模型時變動集中在轉接與驗證範圍。覆核佇列也要有負責人與處理期限,否則低信心分流只會把錯誤轉成等待。
- Jev 1.14 新增 Box 定位;圖片輸入與長上下文屬實驗功能,Jev 1.13 也能啟用。
- Box 每題只回傳一個外框,目標缺席仍有座標,需搭配存在判斷。
- 信心分數與座標要用代表性資料驗證,先從低風險、可覆核的任務小規模測試。
常見問題
Q1: Box 回傳信心分數 0.9,就代表外框有九成機率正確嗎?
不能這樣判斷。官方文件只說明分數越高代表模型越有把握,也未提供建議門檻;應以標註過的圖片檢查分數與實際誤差的關係。
Q2: 找不到物件時,Box 會回傳空值嗎?
不會。官方 Box 文件說明,Box 仍會回傳四邊座標,可在同一請求加入是非存在判斷,矛盾時交由人工處理。
Q3: 長上下文開啟後,判斷會更準嗎?
不一定。官方模型文件說明,開啟長上下文會更慢、準確度也較低,應只提供任務所需內容。
參考來源
- TypeSafe AI (2026). *Jev: For the builders AND dreamers
- 李建興 (2026). TypeSafe擴充Jev決策模型,支援圖片判斷與物件定位. *iThome
- TypeSafe AI (2026). *Box
- TypeSafe AI (2026). *Models
- Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). *On Calibration of Modern Neural Networks
- OWASP Gen AI Security Project (2025). *LLM05:2025 Improper Output Handling


