一場跨科會議結束,紀錄還要整理成待辦;衛教文字寫完,還得改成不同讀者看得懂的版本。醫療工作裡有不少重複的整理、分類與起草任務,讓人想找 AI 分擔。真正要先問的,是工作流程哪一段能交給工具協助、哪些內容必須由人確認,以及錯誤如何被攔下。
模型更新很快。截至 2026 年 9 月,OpenAI 已推出 GPT-6 Astra,Anthropic 也已公布 Claude Opus 5.5。新模型帶來更多研究、文件處理與多步驟工作的可能性,但醫療單位能否受益,仍取決於具體任務、授權環境、資料規範和後續覆核方式。[1][2] 導入時可先照五個檢查點,把「想用 AI」轉成可交接、可評估的工作流程。
一、從重複且容易核對的工作開始
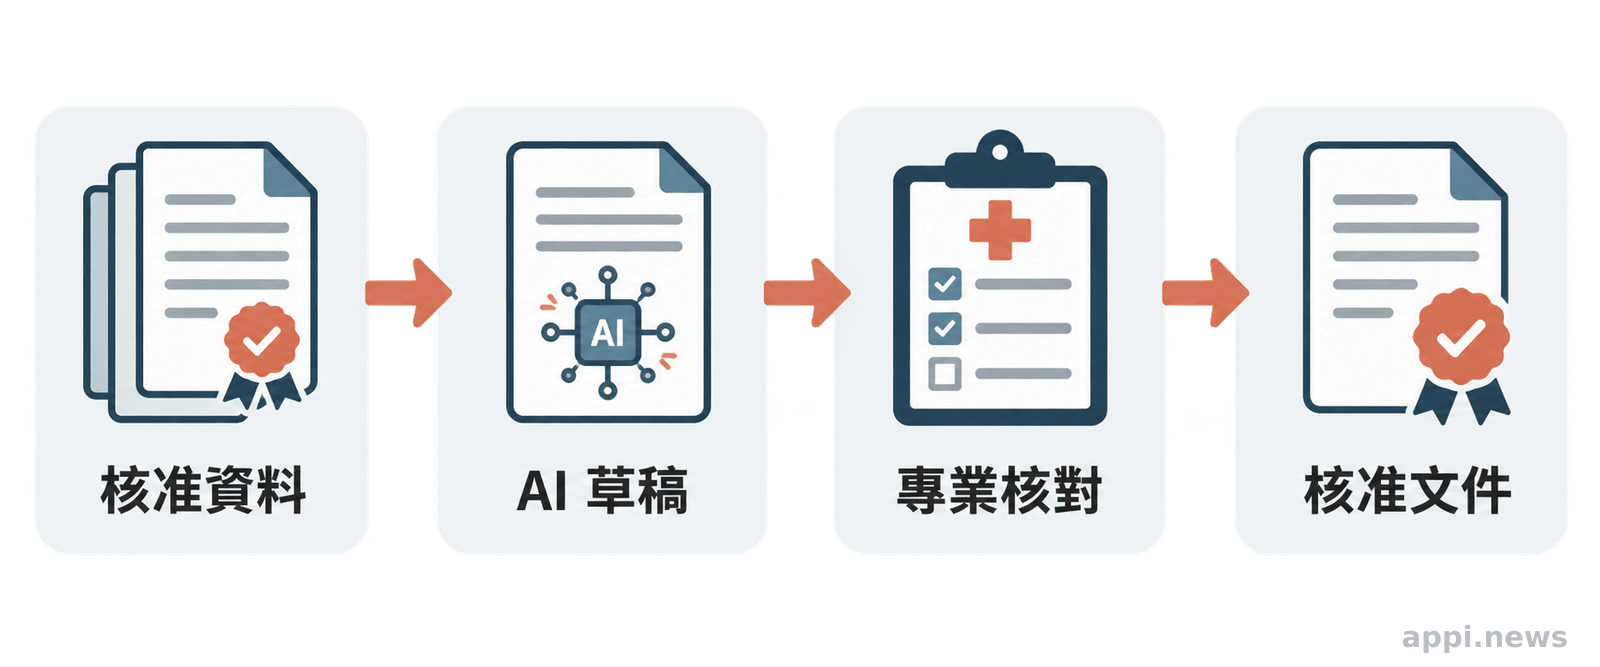
先挑重複率高、輸入資料可控、輸出容易核對的任務,例如依已核准資料起草衛教問答,或把不含病人識別資訊的會議紀錄整理成待辦草稿。
盤點一週內反覆進行的文字與行政工作,記下每次耗時、常見重做原因,以及誰負責確認成品。好的起點通常有固定格式、明確完成條件,而且錯誤能在交付前被發現。彙整公開指引、整理已核准的衛教內容、為內部教育資料產生初稿,都可以列入候選;涉及病人資料的工作,則先確認機構核准及資料處理條件。
接著把工作拆成幾步:資料從哪裡來、AI 要產出什麼、誰檢查、成品交給誰。若任務的完成標準說不清楚,或連熟悉業務的人都難以判斷草稿正不正確,就先補好標準再測工具。AI 能把文字整理得很順,卻可能在來源沒有交代時補上貌似合理的內容,流暢度不能當成正確性的替代指標。
世界衛生組織的健康 AI 指引談到大型多模態模型在醫療、研究與公共衛生的應用,同時提醒這類技術的能力、限制與影響需要審慎評估。[3] 因此,第一個試行任務宜從起草或整理開始,讓熟悉內容的人保有核定權;不要因為某個模型在展示中完成複雜工作,就直接把相同任務放進臨床流程。
二、把 AI 的工作範圍寫成可交接的規則
事先寫明 AI 可以處理的步驟、禁止事項、人工確認者,以及必須轉交人員的情況。
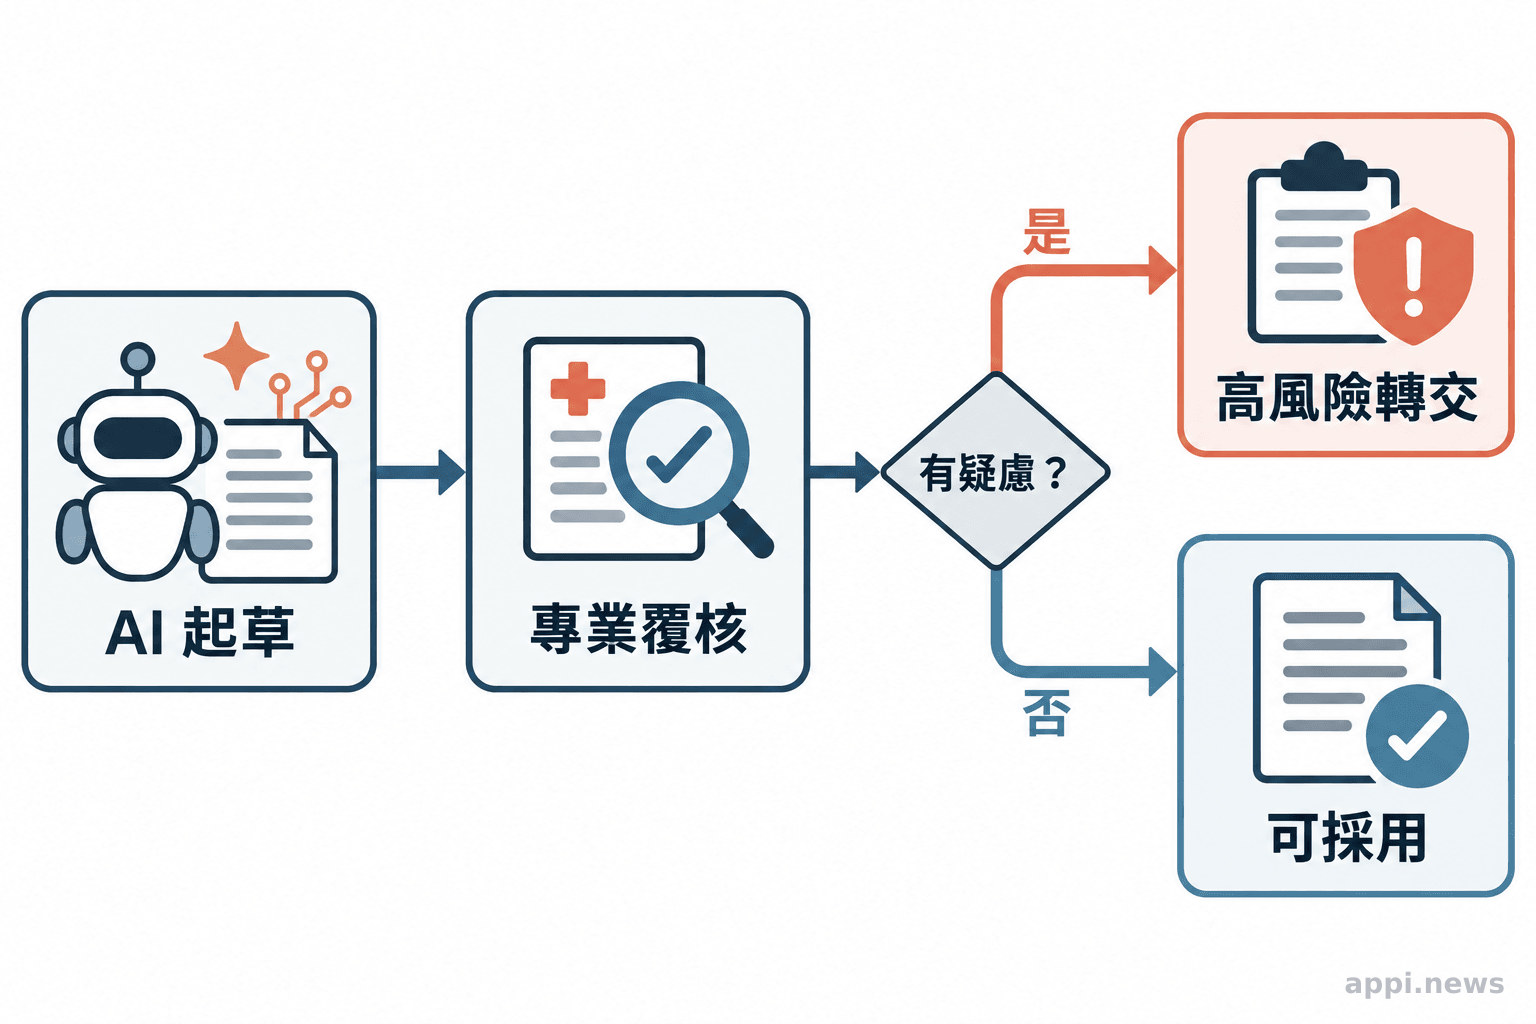
以衛教草稿為例,工作說明可以寫:「只依下列已核准資料整理文字,保留警訊與就醫時機;資料未提及的內容標註『待確認』,不可自行補充。」接著指定醫療專業人員核對來源、用詞、適用族群與重要警訊。若資料彼此矛盾、找不到依據,或問題超出原先任務範圍,流程就要明確要求停止產出並轉交負責人。
工作說明也應交代輸入格式、輸出格式、可用來源與版本。使用者可以要求模型逐點列出來源對應,方便檢查草稿是否把研究結果、院內核准資料與一般背景混在一起。模型無法提供可核對的來源時,該段就回到原始資料查驗,不能只因語氣肯定便保留。
美國醫學會(AMA)的 AI 政策建議依風險決定驗證與監督程度,並要求影響臨床決策時設置合格人員介入點;相關 AI 應與臨床工作流程協調,避免增加醫療人員負擔。[4] 套用到日常工作,就是先依任務後果配置核對力度:整理公開會議資料與產生病人照護建議,不能使用相同的放行標準。
三、先確認資料能否交給這項服務
先依任職機構的資料治理程序確認工具、帳號、用途與資料類別都獲核准,再決定輸入內容。
病歷、檢查結果、用藥紀錄與聯絡資訊可能直接識別個人;即使拿掉姓名,日期、罕見病況、科別或多項細節組合起來,也可能讓人猜出身分。先以公開資料或合成案例測流程。若工作確實需要使用實際資料,須由機構依程序判定處理方式與可用環境,不能自行把資料貼進個人帳號或公開服務。
開始前可向資訊、資安、個資或法遵窗口確認:這項服務是否獲准處理該任務、哪些資料類別可以輸入、輸入內容如何保存及使用、哪些人能存取、產出要如何保存,以及發生誤傳時怎麼通報。付費方案、刪除姓名或開啟隱私選項,都不能單獨代表資料已獲機構授權外傳。
實際提示語也要遵守最小必要原則,只提供完成任務必需的內容。若要測試病況摘要,可設計不對應真實個案的合成情境;測試紀錄中同樣不應留下可回推個人的細節。當服務條款、帳號權限或資料保存設定改變,應重新確認原本的核准是否仍適用。
「在醫療照護情境中,人類應持續掌握醫療系統與醫療決策;隱私和保密也應受到保護。」世界衛生組織《健康人工智慧倫理與治理指引》如此說明。[5]
四、用小規模試行檢查品質與實際負擔
用同一批任務比較導入前後的完成時間、修改情形、錯誤與覆核負擔,並在試行前訂出暫停條件。
先選一個工作和一批合成或已核准的樣本,記錄原流程完成時間、重做次數、重要資訊遺漏與人員感受到的負擔。試行後使用同樣的指標檢查草稿:是否錯引來源、漏掉警訊、改變數字或多寫了原始資料沒有的內容?若產稿時間縮短,核對與修正卻多花更多時間,流程總負擔就未必下降。
紀錄錯誤類型,比只記一個「正確率」更能找到改善方向。把問題標成來源錯誤、資訊遺漏、無根據補充、格式不合或不適用對象,再看它們發生在哪一步。若同一種錯誤反覆出現,先調整任務邊界、資料來源或覆核表單;不要單靠增加提示語,期待模型永遠不再犯錯。
試行開始前也要決定何時停止:輸出含有無法追溯的醫療資訊、遺漏重要風險提示、資料處理條件有變,或人工覆核無法有效攔截錯誤時,都應暫停並重新評估。對影響病人權益或照護決策的任務,應配置更嚴謹的驗證與合格人員介入;單一團隊的小規模試行不能取代正式的機構治理或產品驗證。
五、指定負責人並定期複核
指定一位流程負責人,定期檢視任務目的、工具設定、輸出品質與錯誤紀錄,並在條件改變時重新評估。
負責人不必親自核對每一份草稿,但要確保核對角色、升級窗口和停止方式都有人承接。每次模型、提示語、輸入資料或工作對象改變,都可能影響輸出;原先的測試結果不能自動代表新版本同樣適用。把工具版本、使用日期、任務設定與修正紀錄留下來,才能追查問題從哪裡開始。
醫療人員可以在下一次例行會議挑一項重複工作,先記下目前的步驟和耗時,再依序確認可用資料、負責覆核的人、成品標準與暫停條件。從一項任務開始,取得具體結果後再決定是否擴大。導入目標是改善一段實際流程,成效要由工作品質與負擔紀錄回答。
- 先挑重複、低風險且容易核對的工作試行。
- 寫明 AI 的任務邊界、人工覆核者和轉交條件。
- 依機構核准用途及資料類別使用工具,遵守最小必要原則。
- 用相同任務指標比較時間、品質與覆核負擔,預先訂好停止條件。
- 指定流程負責人,工具、資料或用途改變時重新評估。
常見問題
Q1:醫療人員可以先用 AI 整理衛教資料嗎?
可以從公開或已核准資料起草開始,並由熟悉內容的人核對來源、警訊、適用對象與機構規範。若要輸入病人資料,先依任職機構程序確認服務與資料類別是否獲准。
Q2:AI 生成的內容看起來很專業,還要查證嗎?
要回到指定來源核對事實、數值、警訊與更新日期。文字流暢或附有看似完整的引文,都不能證明內容正確。
Q3:醫療單位要先買最新模型才能開始嗎?
不用先從採購模型開始。先選定工作、資料規範和驗收方式,再確認機構可用的工具是否適合;截至 2026 年 9 月,GPT-6 Astra 與 Claude Opus 5.5 是近期公布的模型,實際可用服務與版本仍應以官方資訊及機構核准為準。[1][2]
Q4:刪掉病人姓名後,就能把資料貼給 AI 嗎?
不能只靠刪姓名判斷。其他欄位組合也可能識別個人,應先依機構資料治理程序確認可用的工具、資料類別、處理方式與用途。
Q5:什麼情況下應暫停 AI 試行?
若產出出現無法追溯的醫療資訊、遺漏重要風險提示、覆核者無法攔截錯誤,或工具與資料條件改變,先停止並交由流程負責人重新評估。
參考來源
- OpenAI. (2026). *GPT-6 Astra Model*. OpenAI API documentation
- Anthropic. (2026). *Claude Opus
- World Health Organization. (2024). *Ethics and governance of artificial intelligence for health: Guidance on large multi-modal models
- American Medical Association. (2024, November). *Augmented Intelligence Development, Deployment, and Use in Health Care* [AMA House of Delegates policy adopted November 12, 2024]
- World Health Organization. (2021). *WHO issues first global report on Artificial Intelligence (AI) in health and six guiding principles for its design and use