
很多人第一個會先想到,Granite Switch 4.1 30B Preview 能否讓系統少接幾個模型、少維護幾個服務。IBM Granite 的模型卡將它列為預覽版模組化語言模型:基礎 checkpoint 可透過 chat template 中的控制 token 啟用專用 adapter,涵蓋 RAG、安全與可解釋等能力。這和服務端點(接收 API 請求並回傳結果的入口)是不同層次;模型卡沒有證明 Switch checkpoint 內含語音辨識。以下聚焦 Hugging Face 模型權重的自行部署與系統整合,不涵蓋託管推論服務在台灣的區域或付款可用性。
一、Granite Switch 4.1 30B Preview 的模型結構是什麼?
Granite Switch 4.1 30B Preview 的模型卡描述的是單一 checkpoint 搭配多個專用 adapter,透過控制 token 切換 RAG、安全與可解釋等語言模型能力;它沒有列出語音辨識 adapter。Checkpoint 是模型權重版本,adapter 是附加的任務模組,兩者都不等同於部署後提供請求的 HTTP/API 服務端點。
checkpoint、adapter 與服務端點各自代表什麼
IBM Granite 官方模型卡將 Granite Switch 4.1 30B Preview 標示為預覽版,發布日期為 2026 年 5 月 5 日。其模組化設計以 Granite 4.1 30B 為基礎,透過 chat template 的控制 token 動態啟用專用 adapter,例如 RAG、安全與可解釋能力。這些是模型層的組件與切換方式;是否把模型部署成一個或多個 API 服務端點,則是系統架構的選擇,不能由 checkpoint 或 adapter 數量直接推出。
可依模型卡所列的 RAG、安全與可解釋等文字能力評估;語音辨識需另看 Granite Speech 等獨立模型及其部署方式。模型權重可從 Hugging Face 取得並自行部署;託管推論服務的台灣區域支援、計價與付款方式,需依供應商當下條件另外確認。
服務端點與模型能力的差別
服務端點共用,指應用程式透過同一個 API 入口呼叫服務;checkpoint 與 adapter 則屬模型組件,任務切換依模型卡所述控制 token 運作。整合者須分別確認模型支援的能力、部署服務如何指定任務、回應格式、串流支援與錯誤狀態,不能把模型卡中的 adapter 切換直接當成已提供的託管端點。
即使自行部署的模型只透過一個網址提供服務,若請求契約、權限和重試規則仍各自不同,應用程式仍會保留多套分支邏輯。評估時應分開記錄模型能力、部署端點數量,以及程式實際維護的任務流程,才能判斷簡化發生在哪一層。
二、Switch 文字能力與獨立語音模型的輸入輸出要分開看
Granite Switch 的語言模型 adapter 與獨立語音模型有不同資料型態和錯誤條件。應分別驗證訊息脈絡、結構化欄位及音訊轉錄結果;即使部署在同一個 API 入口,也要各自檢查格式與品質。
聊天任務:訊息格式與上下文
Granite Switch 模型卡所述的 chat template 可搭配控制 token 啟用相應 adapter;實際聊天請求仍須依部署框架的介面實作。整合時要確認上下文如何傳入、長對話如何裁切、模型回應是否可能被截斷,並測試空白訊息、特殊字元和超長輸入等情況。
輸出端則要檢查串流與非串流回應是否都能被應用程式處理,並定義逾時或不完整回應時,使用者介面要顯示什麼、系統是否重試。這些規則最好寫進 API 契約與錯誤碼對照表,而不是分散在各服務的程式碼裡。
決策任務:結構化輸出與下游驗證
若應用情境要用 Granite Switch 輸出分類、欄位值或下一步建議,須先驗證模型與 adapter 是否支援所需任務。即使結果看起來像 JSON,也要檢查能否解析、欄位是否齊全、型別是否正確,以及值是否符合業務規則。可解析不等於內容正確;涉及付款、派工或變更資料時,不應只因格式完整就直接執行。
可在模型與執行動作之間設置驗證層:先以 schema 檢查欄位和型別,再對照允許值、範圍、使用者權限及必要的人工覆核條件。測試資料也要涵蓋缺欄位、未知類別、互相矛盾的欄位和模型拒答,確認系統會安全地停下或交由人員處理。
語音任務:音訊輸入、轉錄結果與例外處理
Granite Speech 4.1 2B 是獨立於 Switch checkpoint 的語音模型。其模型卡列出的 ASR(自動語音辨識)語言為英文、法文、德文、西班牙文、葡萄牙文和日文,未列繁體中文 ASR 支援;AST(自動語音翻譯)列出英語與上述語言互譯,另支援英語至義大利文及普通話的翻譯方向。翻譯目標語言不代表該語言也支援語音辨識,台灣團隊若需要繁中轉錄,應另找有明確繁中 ASR 支援的模型並用現場音檔驗證。
自建語音流程還要檢查音檔編碼、取樣率、聲道、檔案大小與分段方式。轉錄結果若含時間戳、說話者或信心資訊,也要確認實際採用版本是否提供;低信心、空白轉錄、音檔損壞和超時都應有處理規則。若轉錄文字會進入搜尋、客服紀錄或其他決策流程,應設計人工更正或重新確認機制。
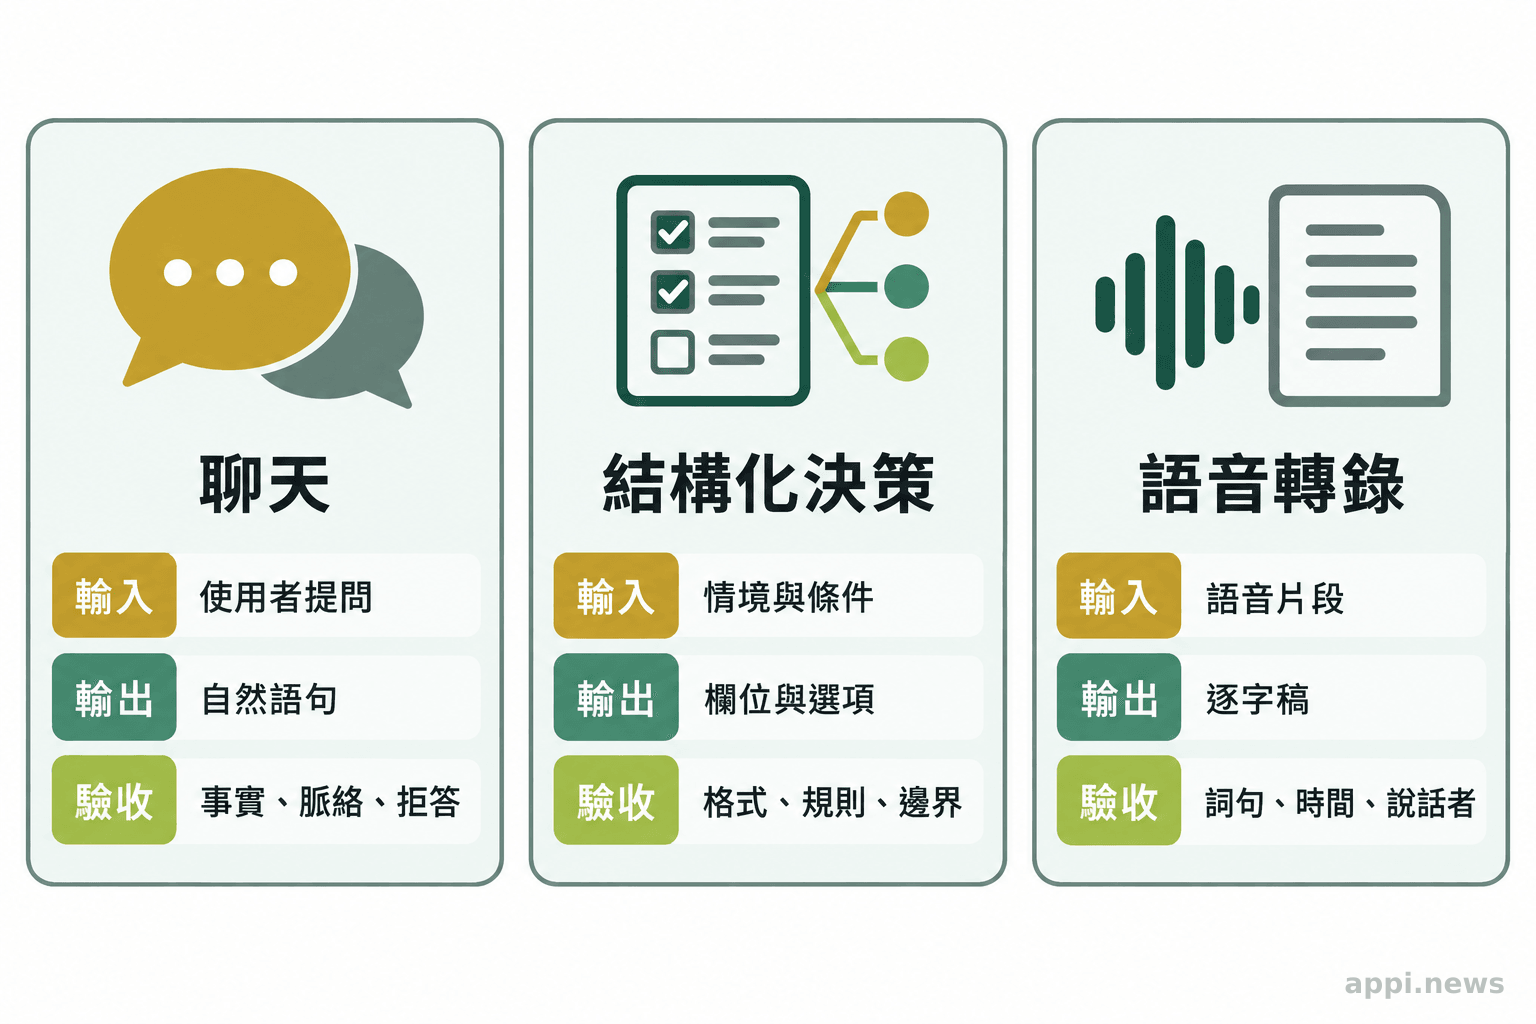
IBM Granite 將 Granite Switch 4.1 30B Preview 的模型卡定位為可用 adapter 切換多種語言模型能力的模組化 checkpoint;實際部署端點、任務支援與效能需依採用的框架及設定驗證。
IBM Granite Speech 4.1 2B 的模型卡將其列為獨立語音模型,說明支援的 ASR 語言及 AST 翻譯方向;繁體中文 ASR 未列在支援語言中。
三、為什麼端點變少,整合工作仍可能存在?
應用程式仍要負責任務路由、資料轉換、權限控制與失敗回復。服務入口集中,並不會自動消除既有系統的資料格式差異或責任分工。
既有流程、資料轉換與任務路由
現有系統可能從資料庫、客服平台或行動裝置接收資料,各來源的欄位名稱、編碼與權限設計未必一致。規劃模型服務前,仍須判定何時呼叫 Switch 的文字能力、何時送音訊給獨立語音模型,並將輸入整理成各服務可接受的格式。輸出也可能需要轉成舊系統欄位、記錄來源與版本,供後續稽核。
因此,流程圖應標出觸發條件、呼叫任務、資料轉換位置、輸出接收者和人工處理節點。若部署架構讓同一入口透過不同參數切換模型或功能,路由邏輯仍存在,只是從服務選擇改為任務選擇。要估算節省多少工作,應比較端點整合前後的程式分支、監控項目與部署依賴。
失敗處理、延遲與責任分工
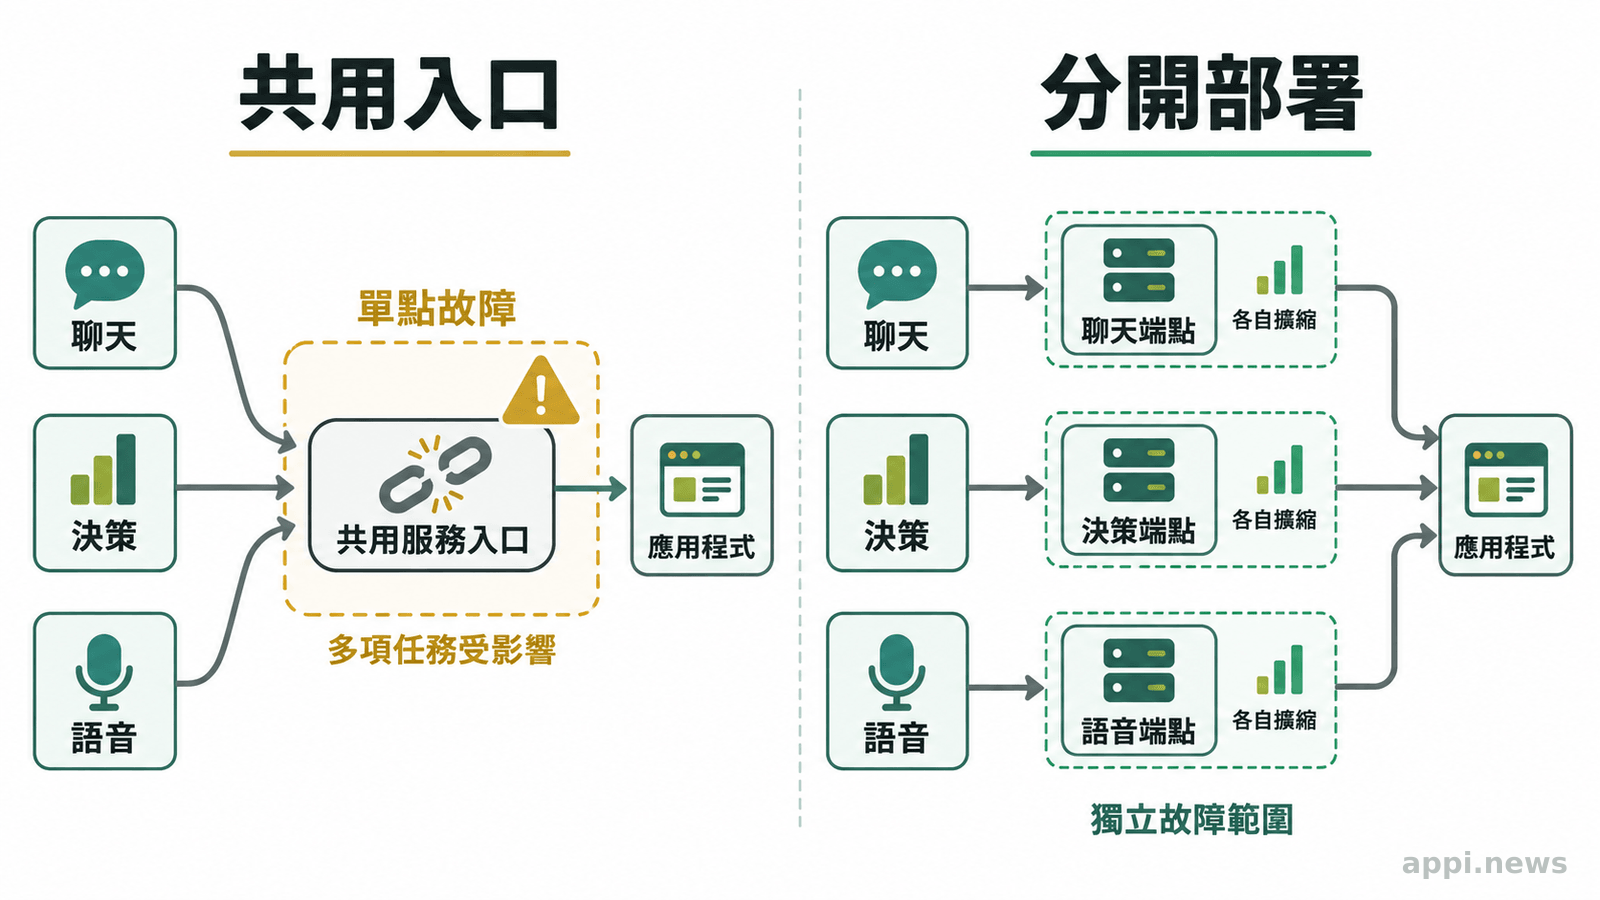
不同任務可能有不同逾時門檻。獨立語音模型的音檔上傳與轉錄需要處理較大的資料量,文字任務則可能期待較快回應。若將兩種模型部署在共用資源或服務入口,尖峰語音請求可能影響文字任務;若共享基礎設施故障,多條業務流程也可能同時受影響。
整合前應明確指定誰監測錯誤率、誰決定重試、誰處理無法恢復的請求,以及資料在錯誤紀錄中可以保存多久。音訊和轉錄文字可能含個人資料;在台灣導入時,應由負責單位依《個人資料保護法》檢核蒐集處理目的與告知事項、委外處理責任、存取權限、保存期限及刪除流程,並確認契約與內部責任分工。科技產品與系統整合需納入評估的,是資料處理、權限及服務中斷風險。
四、單一端點與分開部署如何取捨?
以下以部署後的 API 服務入口為比較單位,不以 checkpoint 或 adapter 數量代表端點數。共用端點可能集中監控與版本管理;分開部署則可讓文字模型與語音模型獨立擴充或隔離故障。適合的設計要看工作負載、故障影響範圍、維運能力與替換需求。
維運簡化、故障隔離與擴充彈性
| 評估面向 | 單一端點 | 分開部署 |
|---|---|---|
| 部署與監控 | 入口與版本管理可能較集中 | 需維護多個服務與監控設定 |
| 故障範圍 | 共用服務異常可能影響多種任務 | 可將故障限制在個別服務,但仍需管理服務間依賴 |
| 擴充方式 | 資源配置可能需兼顧多種負載 | 可依任務流量分別擴充 |
| 更新與替換 | 需確認一次更新對各任務的影響 | 可分別更新,但介面與相容性管理較多 |
表格呈現的是架構上的常見取捨,不代表特定部署必然有相同結果。若任務流量差異大、語音尖峰明顯,分開擴充的價值可能較高;若目前主要成本來自多套端點的認證、監控與版本管理,集中服務則值得進行小規模驗證。
供應商依賴與服務替換成本
若在台灣自行部署 Hugging Face 上的模型權重,仍須準備相符的推論框架、運算資源與維運環境;託管推論服務的區域支援與付款方式仍應向供應商確認。模型卡列出 Granite Switch 4.1 30B Preview 採 Apache 2.0 授權,但不能據此推論所有 adapter、程式依賴、資料集或部署元件都採相同授權。導入前應逐項確認模型及 adapter 的授權、相依套件條款和部署方式的使用限制,並保留核對紀錄。日後若要換供應商或改變部署環境,也要確認替代服務的輸入輸出、延遲、權限和資料保存條件。
替換成本可透過介面抽象降低:在自有應用程式內定義任務名稱、輸入輸出 schema(資料結構規格)和錯誤類型,再由各供應商轉接層處理差異。這仍需實際維護轉接程式,不會讓替換變成零成本,但可以避免業務邏輯直接綁定單一產品的特殊參數。
五、導入前如何設計驗收?
先為聊天、決策與語音分別定義輸入輸出契約,再用代表性資料測試正常、錯誤和高負載情境。最後演練權限調整、服務停用與替代端點切換,確認流程仍可控。
先定義各任務的輸入輸出契約
為每項任務記錄資料來源、必填欄位、格式限制、預期回應、錯誤碼、逾時門檻與後續處理人員。語音要列出檔案格式、ASR 語言與無法辨識時的處理方式;決策任務要列出 schema、允許值、拒答條件和執行前檢查;聊天則要規範上下文長度、串流行為及不完整回覆處理。
契約也要標明資料是否含個人資訊、哪些角色可以呼叫、日誌可記錄哪些欄位,以及保存多久。針對台灣個資法要求,驗收時確認處理目的、告知事項、委外廠商責任與保存刪除流程;另將模型及 adapter 授權、API 或模型版本變更、資料傳輸與存取權限、服務中斷時的替代流程列入檢核。
用代表性情境驗證格式、品質與錯誤回復
測試集不只放容易成功的例子。應納入常見請求、邊界值、缺漏欄位、噪音音訊、不同說話速度、超長輸入、錯誤參數及網路中斷。記錄格式合規率、任務完成情形、延遲分布、錯誤率與人工介入比例,並依實際業務需求設定門檻。
驗收資料要避免使用未授權的個人資料;若使用合成資料,需確認仍能代表現場的語言、欄位與噪音條件。產品宣稱或供應商基準只能提供測試起點,不能取代在目標硬體、流量和資料條件下的實測。
演練停用或替換端點後的流程
安排端點無法連線、延遲升高、版本回退及供應商切換演練。檢查佇列是否累積、重試是否造成重複操作、未完成的決策是否會被誤當成功,以及使用者能否知道服務暫停。替代方案可以是另一個模型服務、延後處理或轉人工,依任務風險設計,不必假設每種能力都能即時無縫切換。
規劃導入時,可先列出 Switch 30B Preview 的 adapter 任務、獨立語音模型的需求、輸入輸出契約、授權與資料責任,再用代表性資料測試自行部署的組合是否符合現場需求。模型卡提供權重與使用範例;不同環境的效能、可靠性與總成本,仍須依實際部署條件驗證。
開始概念驗證前,可先完成以下檢查:
- 將聊天、決策和語音請求各自整理成輸入輸出契約,確認呼叫時如何選擇任務。
- 以正常、缺漏、超長和錯誤資料測試回應格式、延遲及失敗狀態,並以繁體中文音檔驗證另選語音模型的辨識品質。
- 確認個資法適用事項、委外責任、呼叫權限、日誌內容和資料保存期限。
- 逐項確認 checkpoint、adapter、程式依賴與部署方式的授權,並演練端點不可用、版本回退及切換替代服務時的人工或延後處理流程。
- Granite Switch 4.1 30B Preview 以 adapter 切換語言模型能力,服務端點是另一層部署選擇。
- 語音辨識需採獨立語音模型;Granite Speech 4.1 2B 未列繁體中文 ASR 支援。
- 導入評估要涵蓋版本變更、權限、服務中斷和替換演練。
常見問題
Q1:Granite Switch 4.1 30B Preview 是否在同一個模型中整合語音辨識?
模型卡列出的是可由控制 token 切換的語言模型 adapter,例如 RAG、安全與可解釋能力,未列語音辨識。語音需求須另選 Granite Speech 等模型,再依實際部署方式整合服務端點。
Q2:結構化輸出還需要哪些驗證?
至少檢查可否解析、必要欄位、型別、允許值及業務規則。若輸出會觸發實際操作,還要檢查權限和人工覆核條件,不能只依賴格式正確。
Q3:Granite Speech 4.1 2B 能辨識繁體中文嗎?
模型卡列出的 ASR 語言為英文、法文、德文、西班牙文、葡萄牙文和日文,未列繁體中文。普通話出現在 AST 翻譯目標方向,不能據此推定支援普通話或繁體中文語音辨識。
參考來源
- IBM Granite. (2026). Granite Switch 4.1: Chat, Decisions, and Speech from One Endpoint. *Hugging Face Blog
- IBM Granite. (2026). ibm-granite/granite-switch-4.1-30b · Hugging Face. *Hugging Face Model Card
- IBM Granite Speech Team. (2026). ibm-granite/granite-speech-4.1-2b · Hugging Face. *Hugging Face Model Card


