
目錄(4 節)
OpenAI 發表 GPT-6.2 Astra 與 Sol,並展示 Astra 替虛構農業科技公司製作財務預測工作簿:預測到 2031 年、核對三大報表,並呈現估值假設。這是廠商設計的展示,公司的營運數據並非真實企業實績。公告
對已經付費使用 AI 的台灣團隊,問題是:新模型交出的檔案,能少改幾次?價格下降後,連同審查、重試與工具費,每份合格成果是否更便宜?
Astra 與 Sol 有哪些新能力,該先測哪一款?
Astra 偏向困難的專業與程式任務,Sol 著重成本較低的日常工作與多步驟流程;兩者的工作範圍重疊,應依交付要求選測。
OpenAI 將這次改進放在專業輸出、程式設計與電腦操作。模型選擇仍可沿用依工作流程評估模型與成本的方法,但比較時要換成本次版本。
文件與試算表:驗收能否追溯資料
工作簿做得漂亮,只完成一部分。財務人員還要核對公式、來源、單位與假設;台灣團隊可把自己的繁體中文範本、新台幣欄位和日期格式納入驗收。這些是導入時的測試項目,不能由英文展示直接推定通過。
以這類財務工作簿為測試起點,可要求模型分開列出原始數據、計算公式與自行採用的假設。缺少營收成長率時,應標記待確認,避免填入看似合理的數字後繼續計算。負責覆核的人才能分辨錯誤來自輸入資料、公式,還是模型補出的條件。
接著只改一項假設,檢查三大報表與估值是否同步更新,並保留修改前後的版本供比對。這能檢查成果是否可持續編修,也讓團隊看見每次修正需要多少人工介入;不能只以首次生成的畫面判定完成。
| 工作需求 | 優先試測 | 應核對的成果 |
|---|---|---|
| 多份資料整合成專業文件 | Astra | 來源、公式、範本一致性 |
| 日常改碼、文件草稿 | Sol | 正確率與人工修改量 |
| 跨應用程式的多步驟工作 | 兩者並測 | 寫入結果、耗時與權限 |
程式與電腦操作:看修改後的結果
程式方面可觀察 OpenAI 的 Paris Atlas 展示。Thomas Ricouard 透過 Codex(協助撰寫、修改與執行程式的工具)與 Astra 製作可步行、開車探索的巴黎場景;官方建置紀錄列出修正 13,631 處被裁切的門窗開口。建置紀錄
這個案例呈現從建模到批次修正的流程。套到企業網站,驗收應包括操作是否有效、手機畫面是否正常,以及改版有沒有破壞既有功能。成品截圖無法回答這些問題。
選測時可拆成「新增功能」與「修正既有功能」兩種任務。前者檢查需求是否實現,後者還要確認原有行為被保留。若 Sol 已能通過日常改碼的驗收,可再讓 Astra 處理需要跨檔案追查的錯誤;這是待測的分工假設,仍要用結果決定。
兩款模型文件均列有電腦操作工具支援,但工具必須接入執行環境。既有流程可先參考電腦操作任務的成本與驗證重點,再比較新模型實際表現。Astra 文件、Sol 文件
基準測試與企業回饋,能回答哪些問題?
基準測試提供指定任務的比較;企業回饋呈現特定流程的結果,兩者都需要對照任務、模型設定與驗收方式。
OpenAI 公告引述 Cognition 的 FrontierCode 2.0:在兩者皆使用 max(最高推理強度)設定時,Sol 距 Astra 不到 0.5 分,成本約五分之一。該測試關注程式修改能否達到維護者合併標準,不能直接套成公司專案的節省比例。
另一個案例來自 ClickUp。其 AI 主管 Jay Hack 在公告中回饋,Astra 在工作區應用、儀表板與簡報盲測中,較其正式環境模型略勝。
ClickUp 回饋:該輪測試約少用 40% token,審查輪次少約 30%。這是企業內部測試結果,由 OpenAI 公告刊載。來源
要把 ClickUp 的測試方式用在自己的團隊,可先隱去模型名稱,再由熟悉業務的人評閱同一批成果。除了偏好哪份輸出,也要記錄錯誤類型:資料引用錯誤、欄位遺漏、版面不符,或需要重新製作。如此才能把「比較喜歡」轉成可追蹤的修改負擔。
為什麼分數接近,工作時間仍可能不同?任務若卡在缺資料、登入權限或格式整理,推理能力增加也未必縮短這些環節。公告選出的展示與客戶回饋具有選擇性;比較時要固定資料、工具、推理設定與成功標準,才能判讀差異。
GPT-6.2 API 單價降多少,怎麼算任務成本?
Astra 的一般輸入與輸出單價較 GPT-6 Astra 降低 20%,快取讀取降低 60%;Sol 沿用 GPT-6.1 Sol 單價。
API 是供程式串接模型的應用程式介面。以下是 2026 年 11 月 17 日官方定價,單位為每百萬 token、美元,採 Standard 短上下文。token 是模型處理文字的計量單位,不能直接當成中文字數。定價頁
| 模型 | 一般輸入 | 快取讀取 | 30 分鐘快取寫入 | 輸出 |
|---|---|---|---|---|
| GPT-6.2 Astra | 8 | 0.40 | 10 | 40 |
| GPT-6 Astra | 10 | 1 | 12.50 | 50 |
| GPT-6.2 Sol | 2 | 0.10 | 2.50 | 10 |
| GPT-6.1 Sol | 2 | 0.10 | 2.50 | 10 |
快取是重用已處理的輸入,讀取與首次寫入的費率不同。以純文字、沒有快取與工具的假設算例,每次輸入 1 萬、計費輸出 2 千 token,Astra 費用為 0.01×8+0.002×40=0.16 美元;Sol 為 0.04 美元。
這只是計費示範。比較相同成果時,還要納入推理 token、重試、工具與人工修正。可用「整批支出÷通過驗收件數」計算每份合格成果成本,失敗件的花費也保留在分子。
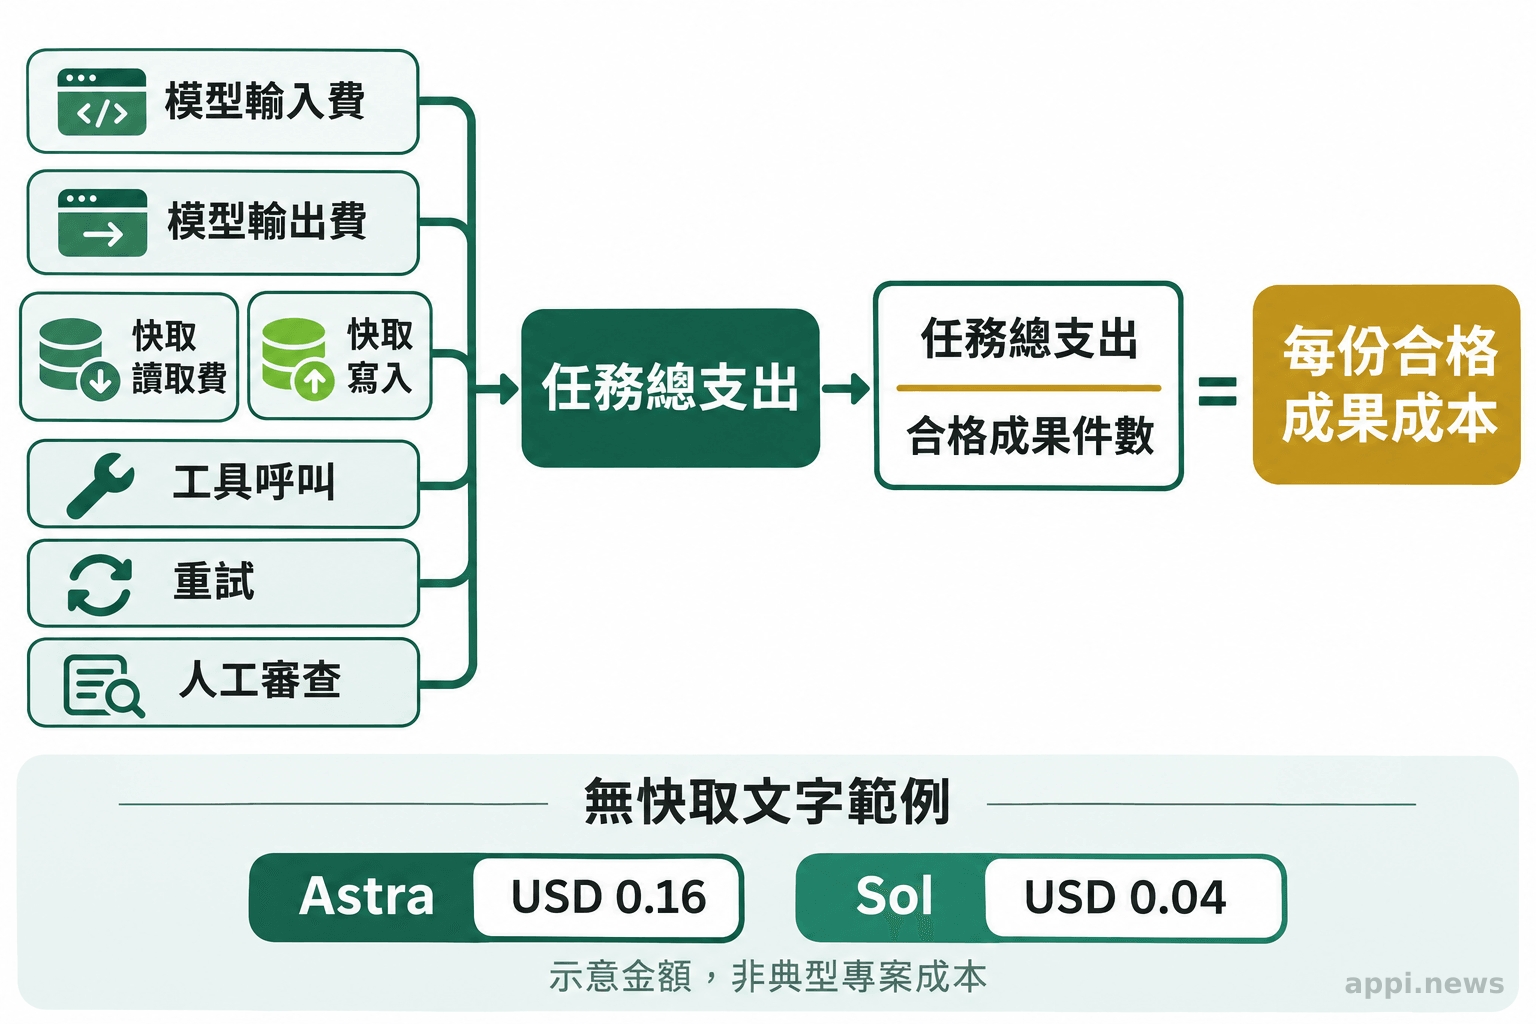
另有兩個容易漏算的條件:輸入超過 272,000 token 時,兩款模型整筆請求的輸入與快取費率加倍、輸出為短上下文的 1.5 倍;Fast、Ultrafast 等速度方案也有不同費率。長文件和大量往返工作要核對模型頁與帳單明細。
台灣團隊導入前,怎麼做一輪可比較的測試?
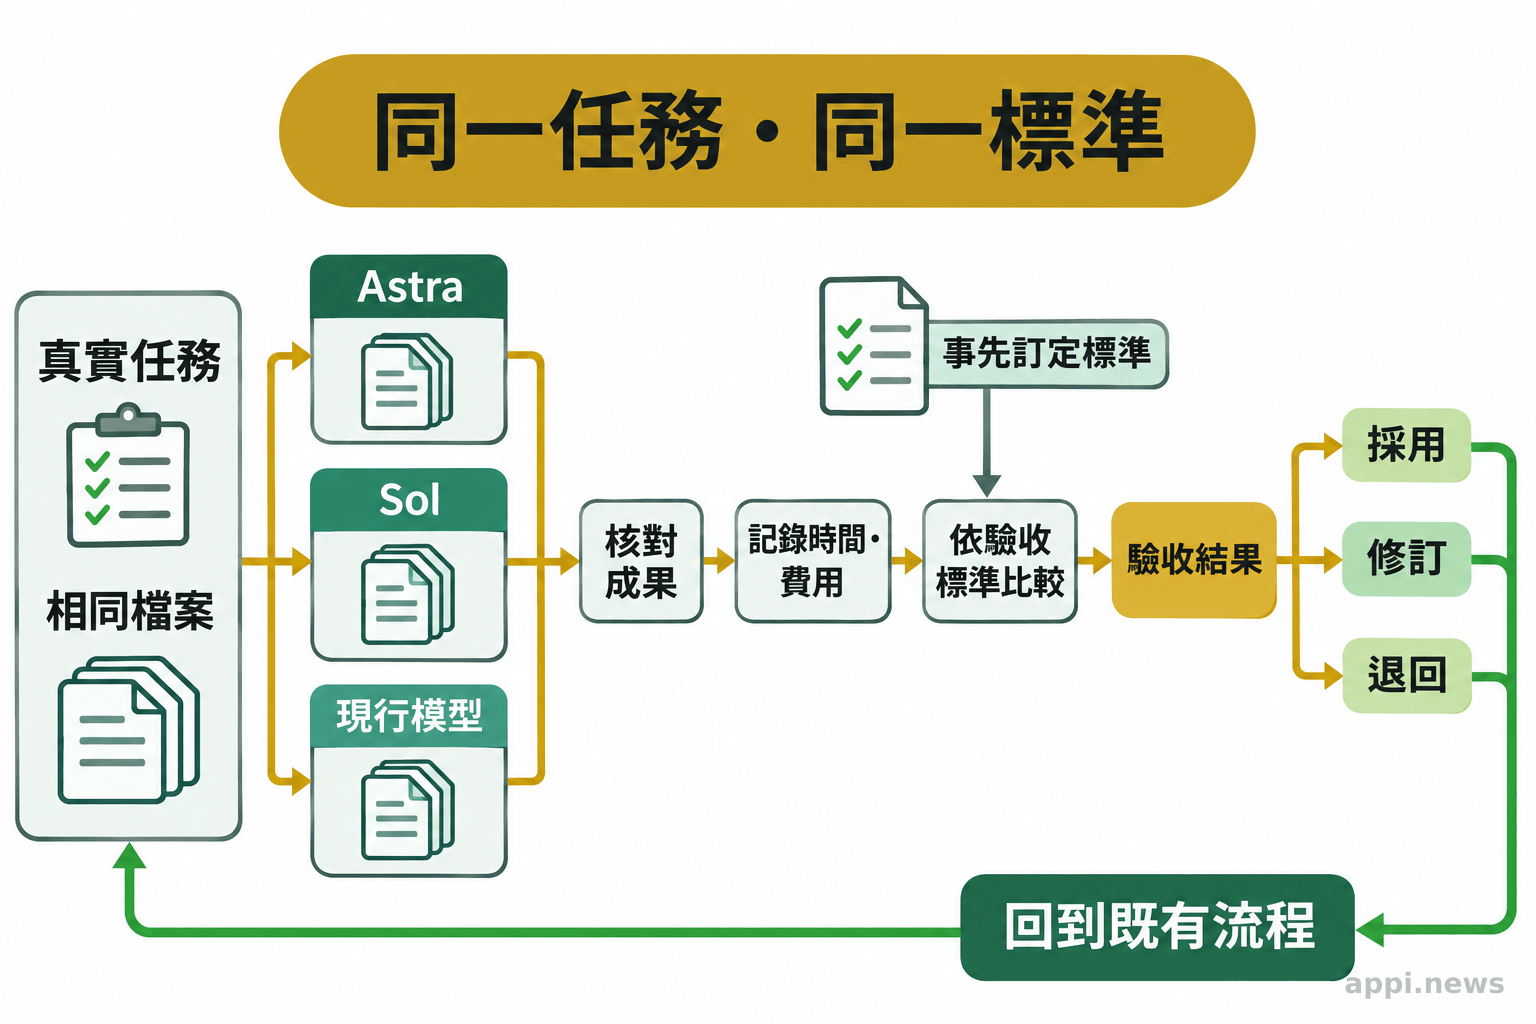
挑三至五項可重複的真實任務,固定輸入與驗收標準,同時記錄品質、完成時間、人工修正和費用。
台灣列在 OpenAI API 支援地區清單中;個別模型權限、付款與用量限制仍須登入自己的帳戶確認。地區支援也不代表資料儲存在台灣。支援地區
資料處理可先列一張流向清單:原始檔由誰提供、哪些欄位送到模型、工具會讀取哪些系統,以及產出的檔案存在哪裡。測試資料先移除不必要的姓名、聯絡方式與商業機密,再確認剩餘內容是否仍足以完成任務。
權限也要依任務分開。只需整理資料的測試,可先使用唯讀帳號;需要寫入時,限定測試資料夾或測試環境,並留下操作紀錄。模型完成任務後,由指定人員確認寫入範圍及結果,避免把「能操作」直接當成「已獲授權」。
OpenAI 模型選擇文件建議:以相同輸入比較成果,保留能達到品質門檻的較低推理設定。官方指引
- 定義通過條件:例如公式正確、測試通過、指定欄位成功存檔,先寫再測。
- 固定比較條件:三款模型使用相同檔案、工具與推理設定,每項任務重複測試。
- 記錄完整代價:保存 token、工具費、失敗次數,以及等待和人工修改時間。
- 檢查實際成果:重新開啟檔案或資料頁,確認修改寫入且未影響其他資料。
- 保留回退方式:先用去識別測試資料小量試行,指定覆核者,通過後再擴大。
驗收表可把「未完成」「完成但需修正」「直接通過」分開記錄,並為每件成果附上實際檔案或測試結果。耗時從收到任務算到覆核完成,包含等待工具回應與人工補資料的時間,才能對照使用者真正需要投入的工時。
擴大導入前,先約定停止條件,例如反覆改錯指定欄位、超出預算,或無法留下修改紀錄。觸發時回到原流程,保留失敗樣本,下一輪再針對原因調整輸入或工具權限。
整合也要驗收。GPT-6.2 使用文件指出,工具呼叫須走 Responses API(回應介面),兩款模型均不接受 none 推理設定。若舊程式依賴這些設定,換模型名稱之前要先修正相容性。
官方文件另提醒,系統偵測到多輪對話的前段歷史遭修改、模型降級、終端使用者或組織變更時,會移除推理項目,可能增加重做與 token 用量。這裡的前段歷史包括先前指令或工具呼叫;追加新訊息與改寫既有歷史應分開處理。
狀態保存方式也要記錄。官方對啟用零資料保留(ZDR)的合資格組織說明,Responses API 會將 store 視為 false,多輪工作須依原順序傳回先前輸出項目,包括加密推理項目。測試時應固定歷史處理方式,避免把狀態遺失誤判為模型能力差異。
正式導入前,重新核對官方定價、支援地區與帳戶實際可用性,並記下查核日期。後續若費率或模型權限調整,也要更新比較表及預算,避免沿用舊條件決定是否擴大使用。
常見問題
Q1:有 ChatGPT 付費方案,就能直接使用兩款模型嗎?
應以帳戶模型選單、方案與工作區管理設定確認。API 權限及費用另依平台帳戶核對。
Q2:Sol 比較便宜,適合直接取代 Astra 嗎?
先比較合格成果成本。複雜工作若多次重做,較低單價也可能失去優勢。
Q3:這次能力更新代表可以直接用於醫療決策嗎?
一般工作與程式能力不等於臨床驗證;涉及診斷或治療仍需專業判斷。這次比較不涉及人體使用或藥物交互作用。
- Astra 部分單價下降,Sol 沿用前代價格;快取寫入與工具費須另計。
- 先用三至五項真實任務比較,再依品質、時間與合格成果成本決定是否導入。
參考來源
- OpenAI(2026)。Introducing GPT-6.2 Astra and Sol。OpenAI
- OpenAI(2026)。Paris Atlas。OpenAI Developers
- OpenAI(2026)。GPT-6.2 Astra Model。OpenAI API
- OpenAI(2026)。GPT-6.2 Sol Model。OpenAI API
- OpenAI(2026)。Pricing。OpenAI API
- OpenAI(2026)。Supported countries and territories。OpenAI API
- OpenAI(2026)。Model selection。OpenAI API
- OpenAI(2026)。Using GPT-6.2。OpenAI API


