
Block 公開的 Dessa 對話示範裡,模型會在交談時笑、停頓,也會隨語氣變化回應。這讓一段語音呈現出文字轉錄不會留下的聲音細節。對正在規劃語音產品的團隊來說,問題很快就來了:這些表現代表模型掌握了情緒,還是只展示了更自然的聲音互動?Block 將 Dessa 描述為以人類對話音訊訓練的全雙工語音模型,並表示它能在 MacBook Pro M4 Max 或更高規格設備本機運行。這些目前仍是廠商公開說法與示範,尚不能當成獨立效能測試。
但這裡要先問一個更前面的問題:產品真正需要模型辨識的是什麼?如果需求只是知道使用者是否插話、何時說完,情緒辨識可能不是必要能力;如果要依聲音推測壓力、疼痛或心理狀態,錯判的代價就高得多。以下從語音訊號、現有案例與產品整合條件,整理導入前值得確認的五件事。
一、Dessa 示範了語音互動的什麼變化?
Block 的示範呈現笑聲、停頓、語調和即時插話等對話表現;它說明模型設計方向,不能證明模型能準確辨識人的真實情緒。
Block 將 Dessa 稱為全雙工(full-duplex,能同時接收與輸出語音)的語音模型,並表示模型從人類對話音訊學習。一般語音助理常先把聲音轉成文字,再由語言模型產生文字答案,最後轉成語音播放;這種分段流程容易讓插話、重疊說話和聲音表情在轉換時消失。Dessa 的公開示範則把焦點放在直接以語音進行即時互動,模型能否因此更懂對話節奏,仍需公開測試驗證。
示範裡出現的笑聲或疲倦語氣,是輸出聲音的表現,不等於模型辨認了對方的感受。若沒有可重現的測試方法、代表性測試資料和錯誤分析,聽起來自然不能推導出情緒判讀準確。產品團隊應把「說話聽起來像人」和「對使用者狀態判斷可靠」拆成不同驗收項目。
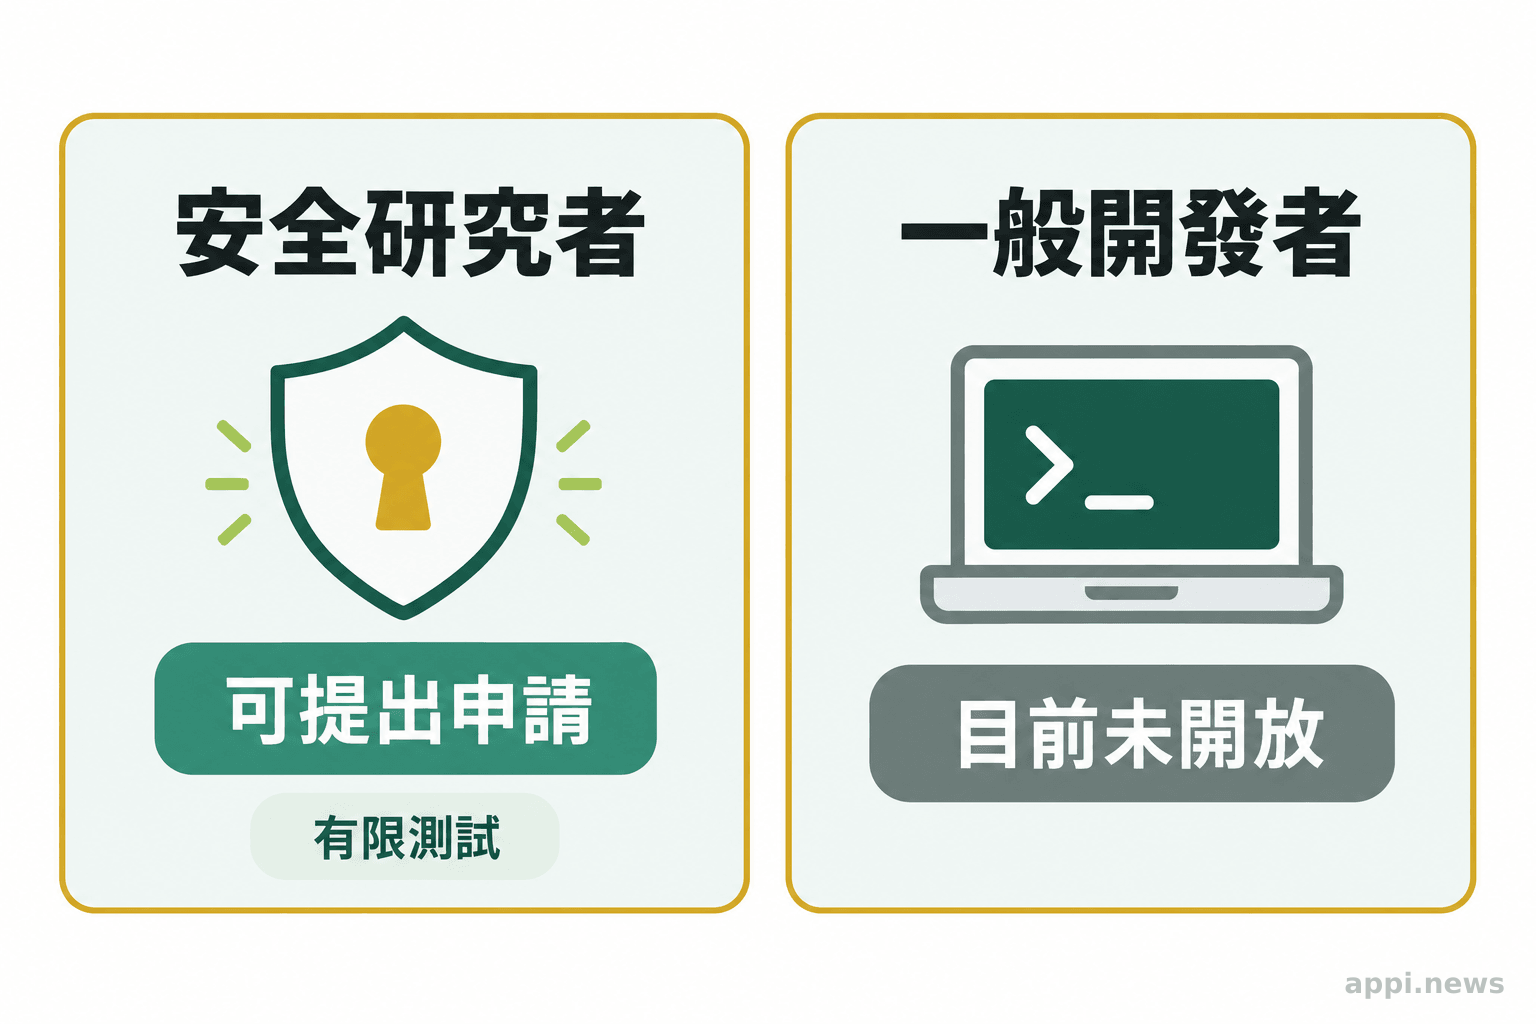
Block 的頁面目前以產品說明和錄製示範為主,尚未提供獨立基準測試、完整技術細節、公開權重或明確授權條款。TechCrunch 報導指出,Dessa 目前仍屬研究預覽,未向一般開發者公開,僅有限安全研究者可申請測試。Block 表示模型可在 MacBook Pro M4 Max 或更高規格設備運行,團隊仍需確認硬體需求和使用條件。
二、語音轉文字會漏掉哪些線索?
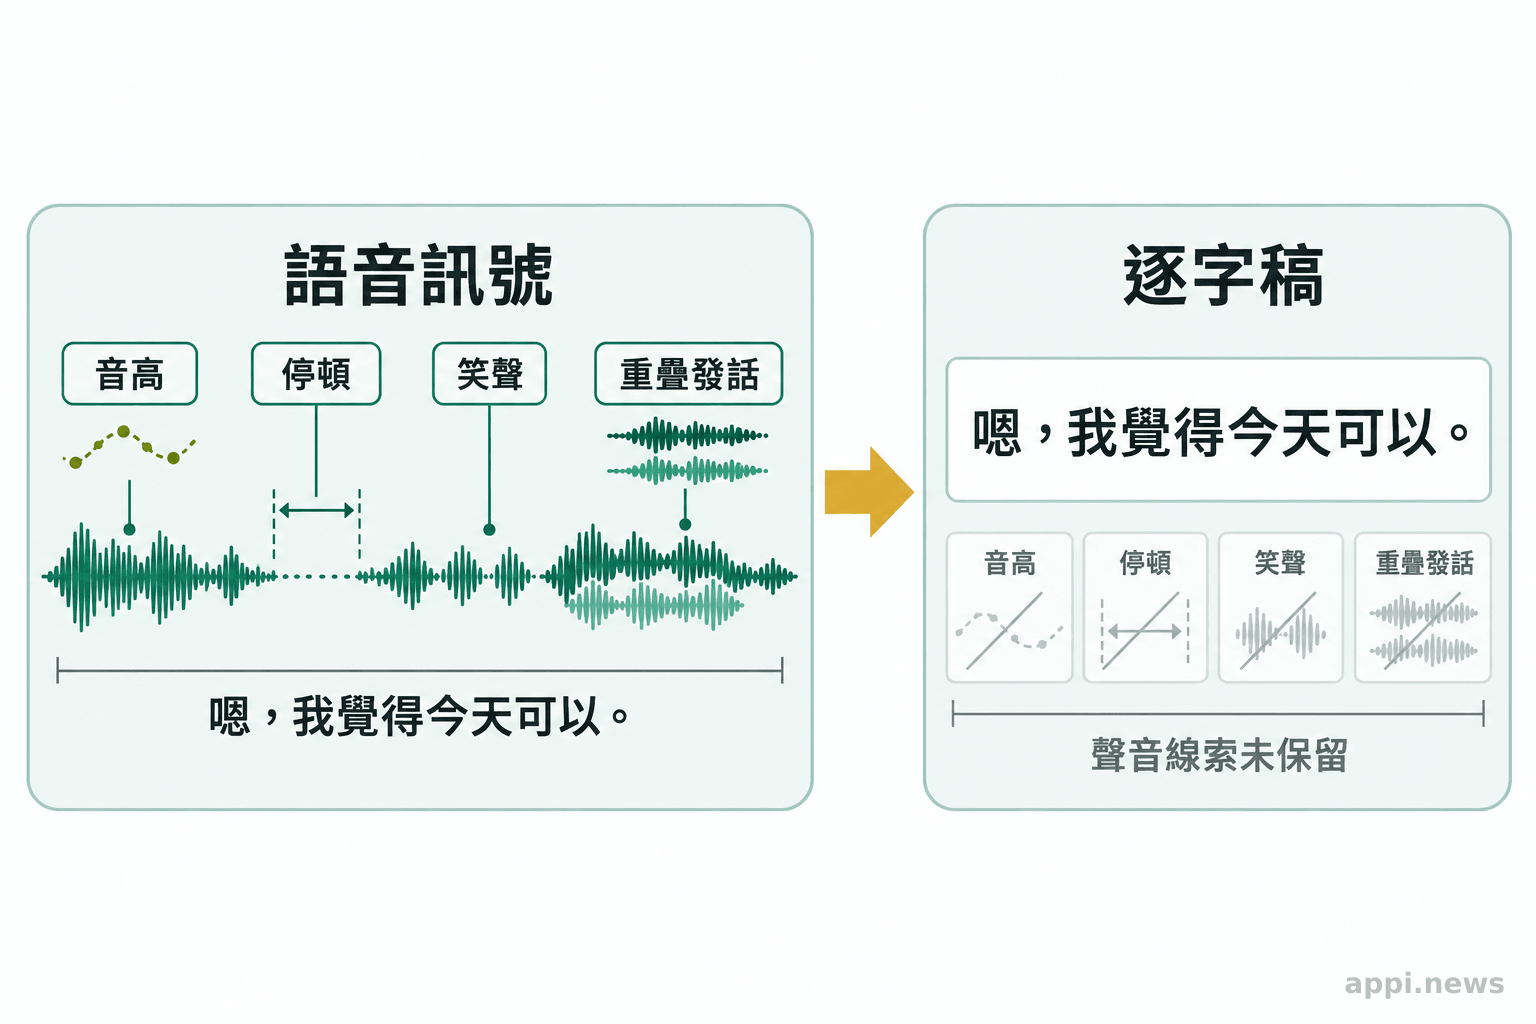
語音保留音高、節奏、停頓、笑聲和重疊發話等線索;這些線索提供語境,但不能單獨證明說話者的內在情緒或意圖。
同一句「我沒事」,可以說得平穩、猶豫、帶笑或提高音量。逐字稿通常只保存字詞,韻律(音高、重音、速度和停頓等聲音模式)及非語言聲音不一定會一併留下。若產品只依文字回答,確實可能少掉部分互動線索;直接處理音訊則保留較多聲學資訊,卻沒有因此自動解決如何解讀它的問題。
語氣會受語言、口音、文化、個人說話習慣、環境噪音和當下情境影響。笑可能是緊張,也可能是愉快;停頓可能表示猶豫,也可能只是網路或設備延遲。模型即使能分類聲音特徵,也不代表能讀懂說話者的真實感受。若系統把推測出的情緒當成確定事實,後續服務就可能對人做出不合適的回應。
Moshi 研究指出,文字中介流程可能遺失語音中的非語言資訊。這描述的是訊號可能流失,未宣稱語音模型因此能正確推斷情緒。引自 Défossez 等人,Moshi 研究(中文摘譯)
三、Dessa、Hume EVI 與 Moshi 解決的是同一題嗎?
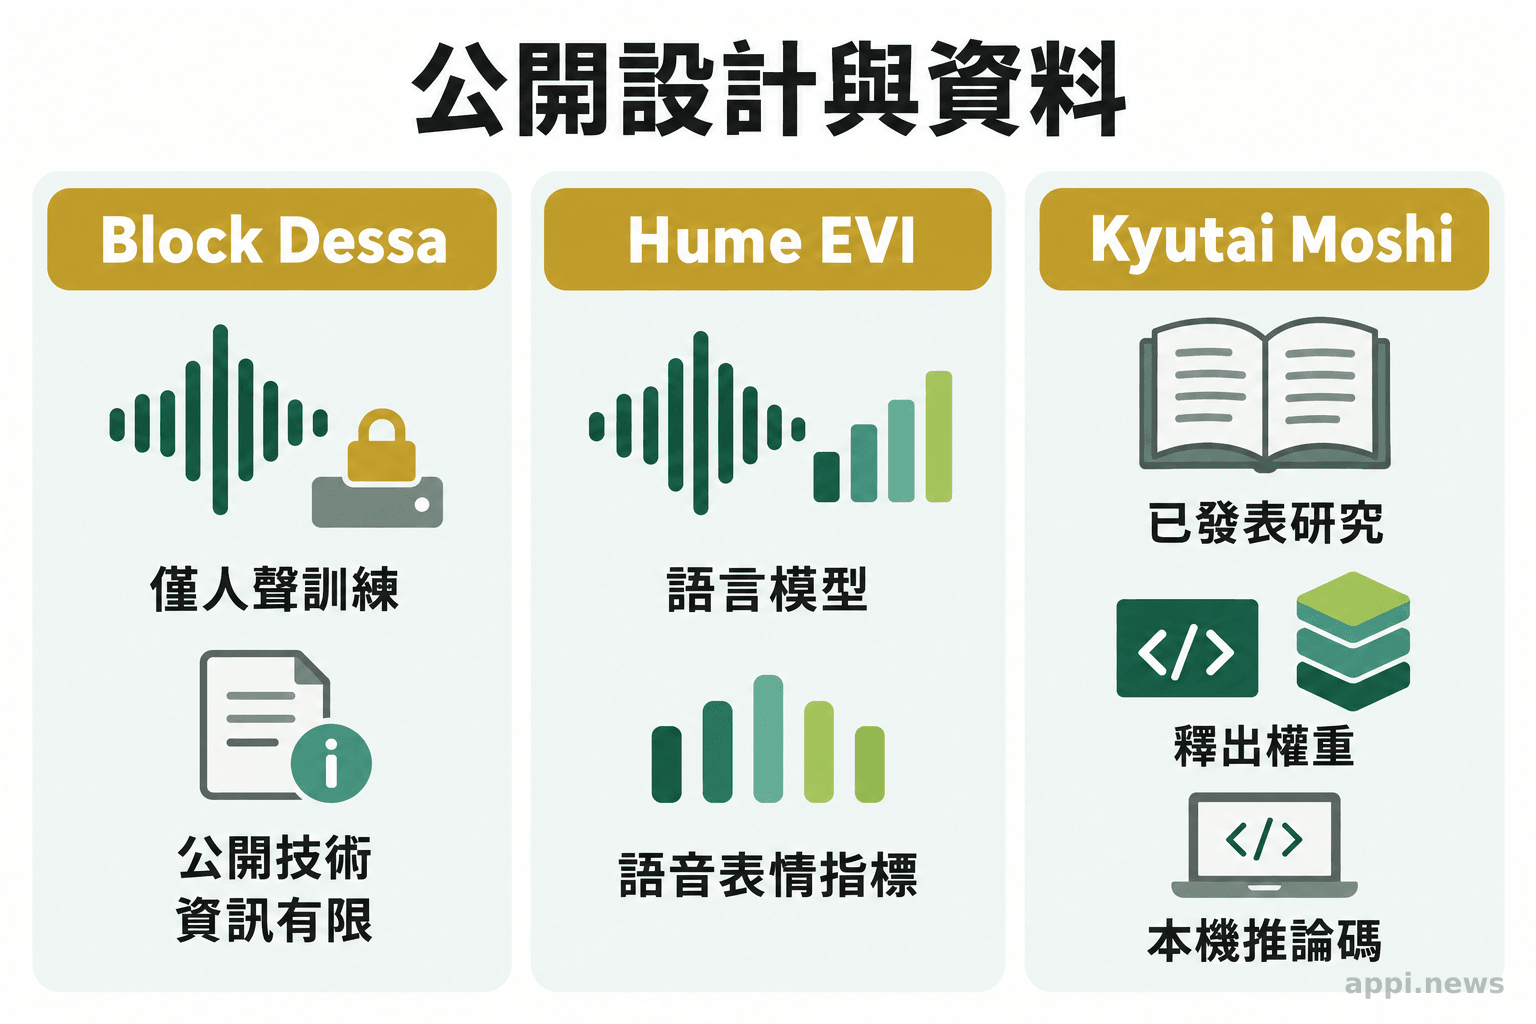
三者都涉及即時語音互動,但公開資料指向不同設計:Dessa 強調純語音訓練與全雙工對話;Hume EVI 結合語言模型與表情訊號;Moshi 公開了模型研究、權重和本機執行程式。
Hume 在 2024 年介紹 Empathic Voice Interface(EVI,同理語音介面)時,描述它會利用使用者的聲音表情調整文字與語氣,也能辨識何時說完及在被打斷時停止。公告也記載 Hume 完成 5,000 萬美元 B 輪融資,這是公司募資資訊,不是語音功能的效能證據。其產品說明不能證明情緒推論正確,架構也不同於 Block 所稱以人類對話音訊訓練的 Dessa。
Kyutai 的 Moshi 則是 2024 年發表的語音文字基礎模型研究。論文描述它從文字語言模型骨幹出發,以平行串流處理使用者與模型聲音,報告理論延遲 160 毫秒、實際約 200 毫秒;這是 Moshi 論文結果,不能套用到 Dessa。Kyutai 隨後公開權重及串流推論程式,並說明可在本機執行。
| 案例 | 公開資料描述的設計 | 目前可確認的範圍 |
|---|---|---|
| Block Dessa | 廠商稱以人類對話音訊訓練,主打全雙工及本機執行 | 有產品說明與示範;未見公開權重、完整技術細節或獨立效能基準 |
| Hume EVI | 廠商描述結合語言模型與聲音表情訊號的語音對語音介面 | 官方介紹說明產品設計與功能方向 |
| Kyutai Moshi | 研究模型以語音文字骨幹及平行音訊串流進行即時對話 | 有論文、權重及推論程式,條件仍須按專案與授權核對 |
Voxtral 3 可作為即時語音代理的背景:產品還要處理辨識、對話生成、語音輸出和應用整合。全雙工表示收音與發話可同時進行;語音轉語音指輸入和輸出都是音訊;本機推論則是模型在使用者設備計算。這些術語描述架構,不保證更準、更私密或更省成本。
四、本機 AI 減少哪些依賴,留下哪些責任?
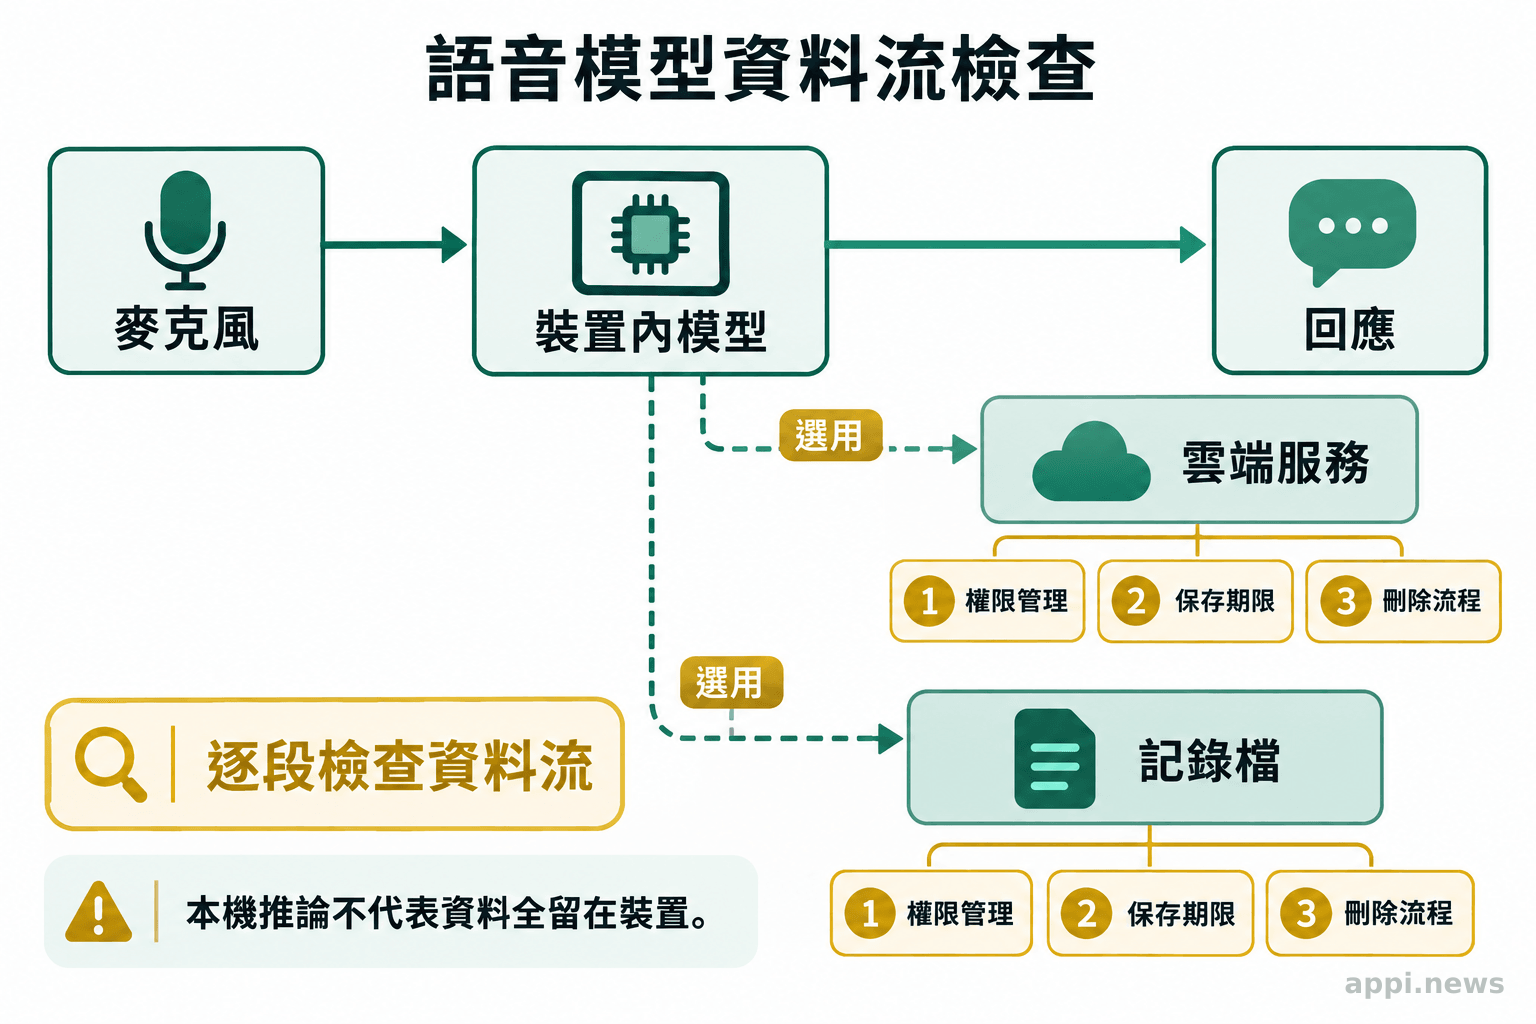
本機推論可能減少部分音訊傳到雲端的需求,但整個產品仍可能使用雲端服務;資料是否外流取決於完整資料流、應用程式設計和維運方式。
模型在裝置上運算,可能減少網路往返,亦可降低對外部推論服務持續可用的依賴。不過,設備規格、記憶體需求、啟動速度、電力消耗、更新方式和故障處理,都會影響能否實際部署。Block 提到 M4 Max 以上設備,不等於一般使用者已可取得模型,也沒有回答不同語言、裝置或產品情境下的運作表現。
本機運行也不會自動處理錄音告知、同意、保存期限、存取權限、刪除、備份和事故通報。整合前應盤點音訊從麥克風到模型、記錄檔和客服系統的路徑,確認資料是否離開設備、誰能存取、何時刪除。若產品服務健康諮詢或敏感對話,還要明定資料管理責任。
Hume 官方描述 EVI 會依使用者的情緒表達調整用字與聲音語氣,這是產品功能說明,不等於情緒判讀對每位使用者都正確。引自 Hume AI 官方介紹(中文摘譯)
語音情緒訊號不得單獨用於醫療判斷、心理狀態標記或其他高影響決策。若模型推測錯誤,必須讓使用者能澄清或退出,並安排人工接手。供應商沒有公開權重、授權和資料處理細節時,也應將這些列為整合前的待確認條件,而不是先假設可以商用或在地部署。
五、產品團隊怎麼判斷是否值得試用?
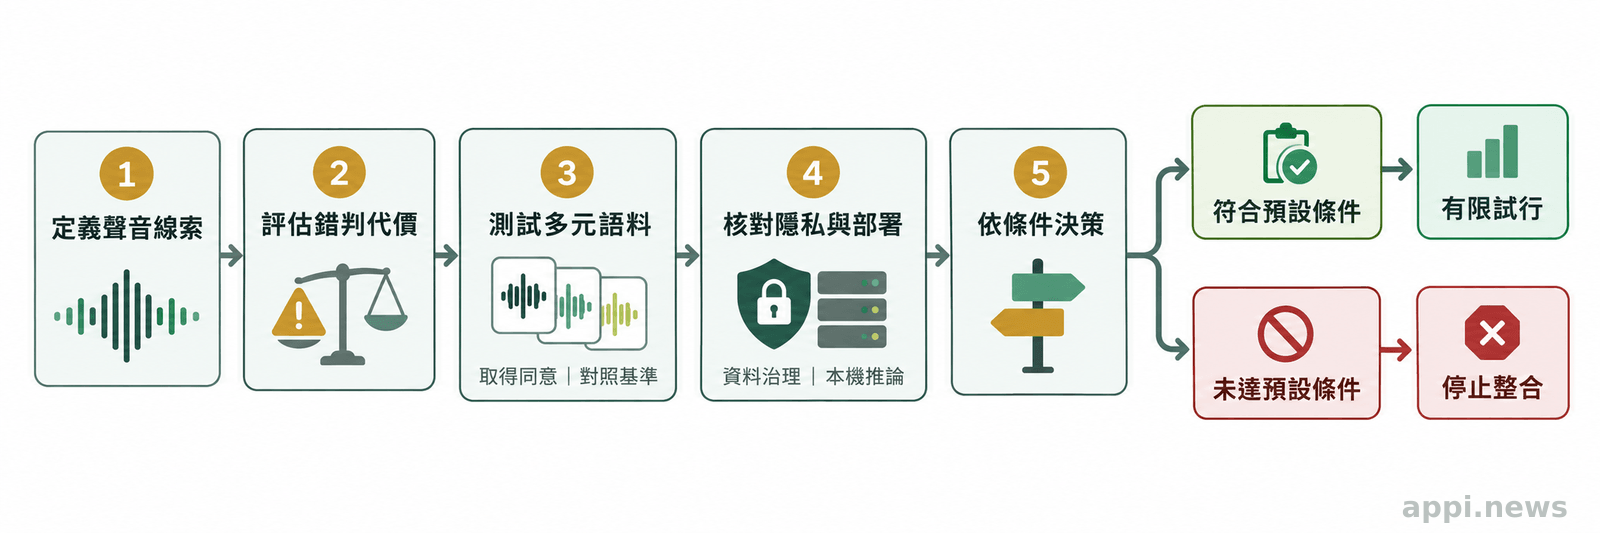
先界定產品要辨認的聲音線索和錯判後果,再用涵蓋真實使用者與環境的語料,和現行流程比較;結果未通過驗收,就不要擴大整合。
- 定義任務。 寫清楚模型要處理的是停頓、插話、語音轉錄,還是情緒相關線索。將可觀察的聲音特徵與「焦慮」「疼痛」等狀態推測分開,並說明哪些結論不能由模型單獨產生。
- 列出錯判成本。 分別記錄漏掉訊號和誤判訊號會造成什麼後果;涉及健康或敏感服務時,安排人工覆核和退出方式,不讓模型推測直接觸發高影響處置。
- 準備代表性語料。 納入口音、語言、不同說話習慣、背景噪音、重疊發話和設備差異。先取得合適的告知與同意,再測試各族群的錯誤情形;單一團隊的示範錄音不能代替真實使用者樣本。
- 和基準流程比較。 對照目前的語音轉文字流程,記錄延遲、辨識結果、人工接手比例、錯誤類型和維運成本。若要測情緒線索,需事先定義標註方式與可接受的錯誤範圍,避免只憑聽感評分。
- 核對部署條件。 確認模型取得方式、硬體、權重、授權、資料路徑、更新和故障責任;只有在小規模驗證達到事先訂定的門檻後,才決定擴大整合。
實際評估時,可先選一條產品中的語音互動流程,列出四項條件:要辨識的聲音線索、錯判的可能後果、可接受的硬體環境,以及人工介入時機。再用代表性語音和現行流程作小規模比較。這能讓團隊判斷,增加音訊能力是否真的解決原有卡點,而不是因為示範聽起來自然就改動整套產品。
- 語音保留文字轉錄可能丟失的韻律與非語言聲音,但保留線索不等於辨認真實情緒。
- Dessa 的本機能力、權重、獨立測試和授權仍須以後續公開資料核實。
- 是否導入,應由任務定義、代表性語料、錯判處理和資料治理共同決定。
常見問題
Dessa 目前仍屬研究預覽,未向一般開發者公開;Block 僅開放有限安全研究者申請測試,公開資料也未確認一般 API 或商用授權。
Q1:Dessa 是否已公開提供下載或 API?
Dessa 目前仍是研究預覽,未向一般開發者公開下載或 API;Block 僅邀有限安全研究者申請測試,公開資料也未提供可據以判斷的商用授權條款。
Q2:聲音中的情緒訊號能代表使用者真實感受嗎?
不能直接畫上等號。音高、語速和笑聲等是可觀察訊號,解讀會受情境、文化、口音、噪音與個人表達方式影響。它們可以作為需要再確認的線索,不應單獨作醫療判斷、心理標記或高影響決策。
Q3:模型在本機運行,錄音就完全不會外流嗎?
不一定。除模型推論外,產品還可能將錄音、轉錄、錯誤紀錄或診斷資料傳往其他服務。需要逐一檢查資料流、保存和刪除方式、存取權限與備份,才能說明哪些資料留在裝置上。
參考來源
- Block. (2026). *Dessa: the Conversation Model trained only on speech
- Hume AI. (2024). *Hume Raises $50M Series B and Releases New Empathic Voice Interface
- Kyutai. (2024). *Moshi open-source release: run Moshi locally!
- Défossez A, et al. (2024). *Moshi: a speech-text foundation model for real-time dialogue*. arXiv
- Mehta I. (2026). *Block’s new voice model sounds eerily human*. TechCrunch


