
很多人看到 Mercury 3 的速度宣稱,第一個想到的可能是 tokens per second(每秒生成 token 數):這個數字能代表使用者真的等得比較少嗎?Inception Labs 於 2026 年 10 月推出 Mercury 3,稱它採用擴散式語言模型,在 NVIDIA GPU 上可達每秒 1,068 個 token,並在多項基準測試中與速度導向模型相比。這些數字來自廠商發布,實際體感仍要看任務、輸出長度、服務負載和測量方式。
理解這項產品,得把三件事分開看:模型如何生成文字、基準測試測了什麼,以及放進現有工作流程後省下多少等待。擴散式語言模型提供了不同的生成路徑,卻不會自動保證每種任務都更快或答案更好。對台灣開發者而言,值得做的是拿自有工作負載比較,而非只看單一速度數字。
Mercury 3 的主打速度,先問測量的是哪一段
Inception 表示 Mercury 3 在自家公布的測試中,NVIDIA GPU 推論速度達每秒 1,068 個 token;這是廠商數據,不能直接推定所有使用情境的等待時間。
Inception 也公布了多項基準測試比較,並描述早期合作夥伴將模型用於搜尋代理、客服、互動教學和瀏覽器操作代理。這些資訊適合用來找出可試跑的情境,不能取代獨立評測:測試提示、模型設定、硬體、服務端負載,以及「完成」的判定方式不同,結果就可能不同。官方另稱 Mercury 3 可處理一百萬 token 的上下文,並提供 OpenAI API 相容介面;這些規格同樣要以實際端點和方案為準。
tokens per second、首字延遲與完整回覆時間
每秒生成 token 數是輸出吞吐量指標,描述一段時間內產出多少文字,卻不一定反映使用者何時看到第一個字。首字延遲(time to first token)是送出請求到第一段輸出出現的時間;完整回覆時間則量到答案完成所需時間。若應用會先搜尋資料、呼叫工具再組答案,端到端時間還包括這些步驟和網路往返。
因此,短回答可能更在意首字延遲,批次摘要可能重視整批處理量,多輪代理則要看每一步等待如何累積。Inception 的文章提到其合作方 Octen 在特定搜尋 API 測試中,Mercury 3 的模型生成中位數時間為 0.9 秒、端到端回覆中位數為 2.2 秒。這是特定合作方的測試描述,不等於其他資料、網路或使用者環境會有相同結果。評測時應同時記錄首字、完整輸出和任務總時間,也要看第 50、95 百分位數,避免平均值遮住慢請求。
擴散式生成如何改變文字輸出的流程
擴散式語言模型會從帶有遮罩的位置開始,經過多輪預測與修正逐步形成文字;它理論上能在同一輪處理多個位置,和逐 token 的左至右生成不同。
逐 token 生成:前一個 token 接著決定下一個
常見的自回歸模型會依序生成文字:先產生一個 token,再以目前上下文預測下一個,反覆進行直到完成。這讓文字能逐步串流給使用者,但後續 token 的生成必須等待前面的結果。若答案很長,模型端的計算步驟可能因此拉長,雖然實際等待也受到硬體、批次處理與服務排隊影響。
擴散式語言模型:多個位置反覆預測與修正
擴散式語言模型(diffusion language model)借用逐步去噪的概念處理離散文字。以遮罩式方法為例,模型先看到部分位置被遮住的序列,再在一輪推論中為多個位置預測候選 token;接著保留較可信的部分,對其餘遮罩位置繼續預測,直到形成完整輸出。這種方式有機會把部分原本逐步進行的計算平行化。
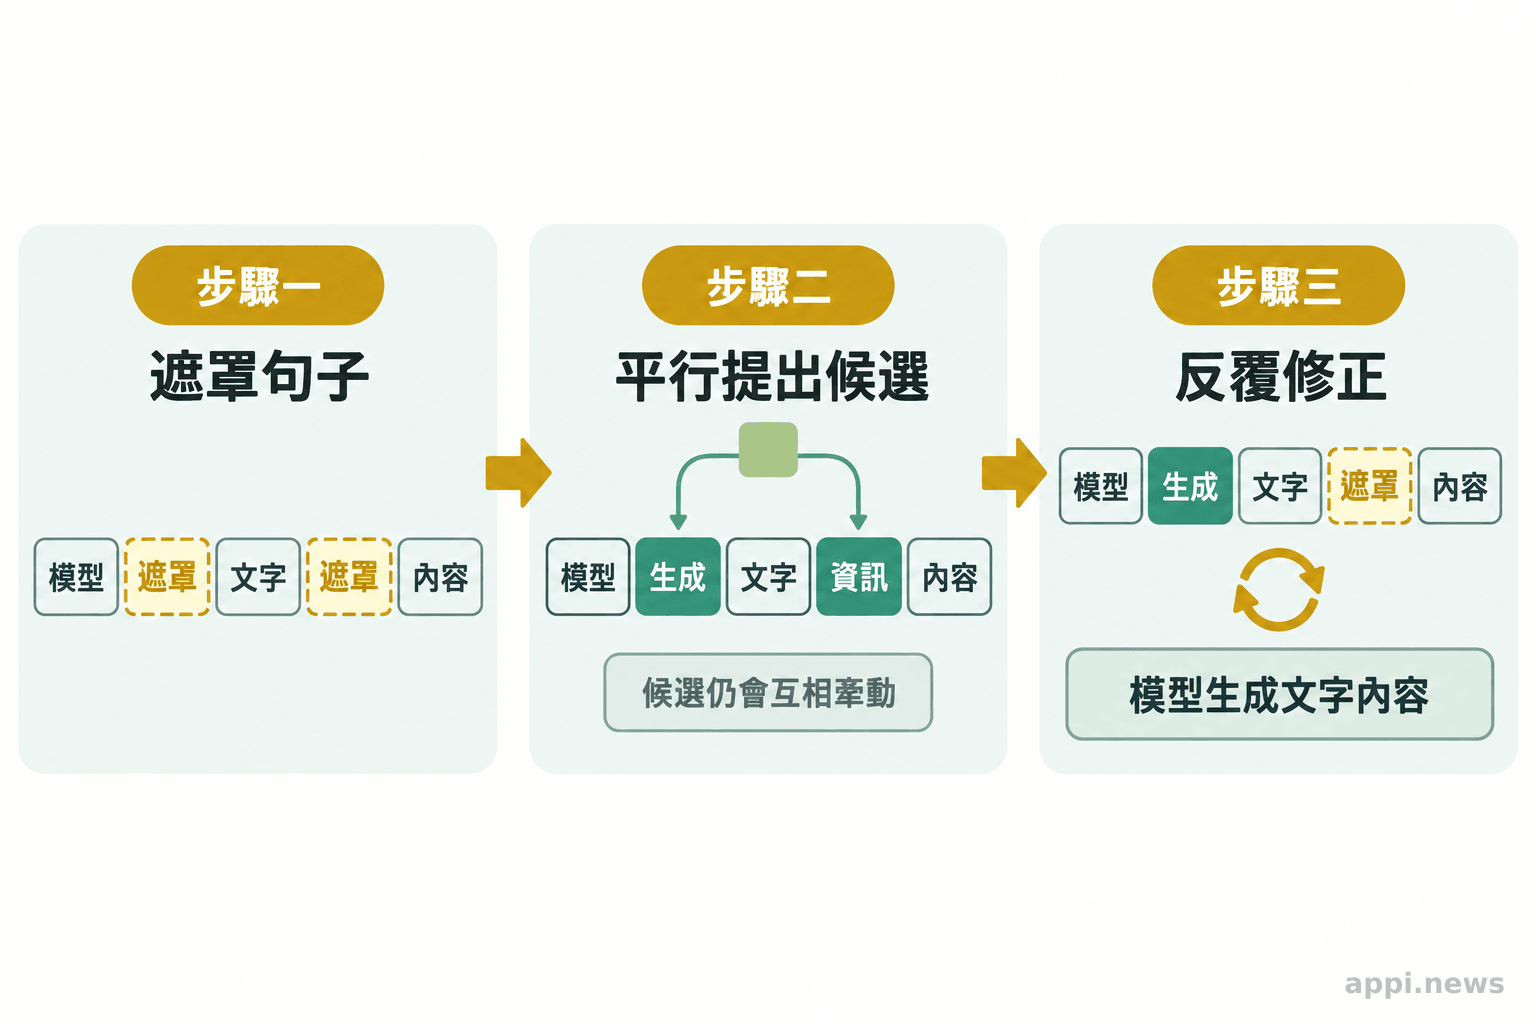
平行生成的限制:token 之間仍有依賴
文字位置不是彼此獨立。句子後段可能要依賴前段的主詞、條件或推理結果;若模型過早同時確定多個互相牽動的位置,就可能產生不一致內容。2026 年一篇探討擴散式大型語言模型平行解碼的研究指出,直接一次解開多個遮罩位置可能降低生成品質與穩定度,實務上需要在平行程度和逐步修正間取捨。該研究討論的是其他擴散模型與解碼方法,不能直接證明 Mercury 3 的速度或品質。
「Speed: 1,068 tokens per second on NVIDIA GPUs.」— Inception Labs,Mercury 3 產品公告(廠商公布數據)
快速生成對哪些應用流程比較有感
模型等待占比高、每次回覆較短、且答案可由人員檢查的工作流程,適合先做小規模比較;多輪工具呼叫尤其應測量整個任務,而非只測單次生成。
多輪 Agent:每次等待如何累積
AI Agent(人工智慧代理)常要多次判斷、呼叫搜尋或其他工具,再依結果繼續推理。若模型每一輪都少等一些,整個任務可能更快完成;反過來說,工具本身很慢、重試很多,或模型輸出不符工具格式,也會抵銷生成端的時間差。測試時要固定工具、步驟上限與任務,記錄成功完成率、重試次數及端到端時間。
搜尋與客服:回覆時間和答案品質一起看
互動式搜尋、客服草稿和即時教學回饋,可先用來測試短回覆是否更快出現。客服若牽涉退款、個資或合規承諾,速度不能凌駕正確性;應由評分者檢查事實、引用、語氣和是否遵守既有政策,再比較延遲。若是語音產品,也要分清 Mercury 3 文字模型與 Inception 另行介紹的 Mercury Voice。語音體驗還包含辨識、語音合成和輪次切換延遲,不能用文字模型的 tokens per second 代替。
API 相容不代表整合成本歸零
相容介面能減少部分串接工作,但應逐項確認串流輸出、工具呼叫、錯誤回應、上下文限制、速率限制和資料保留政策。將模型接到現有服務前,也要檢查輸出格式是否穩定、超時和重試機制是否適用,以及供應商條款是否符合資料處理要求。初期可保留舊模型作為回退路徑,避免小規模測試影響正式服務。
台灣開發者可以怎麼測 Mercury 3
以相同提示、資料、工具和輸出要求比較現用模型與 Mercury 3,分開記錄延遲、品質、費用和失敗情形,才能判斷速度提升是否符合自己的工作負載。
固定提示、資料與工作負載
先挑一項目前確實受模型等待影響的任務,例如客服草稿、搜尋摘要或工具代理。整理一批去識別化的真實輸入,固定系統提示、上下文、輸出長度上限、解碼設定和工具版本;各模型使用相同條件,並交錯執行,降低尖峰負載或時段差異造成的偏差。若使用供應商公開基準,則另外標示其測試條件,不要與自家結果混為一談。
同時記錄延遲分位數、品質、成本與失敗率
每個案例可記錄首字延遲、完整回覆時間、輸出 token 數、單次費用、逾時、格式錯誤與工具呼叫成功率。品質評分應事先訂出標準,例如正確性、完整性、是否遵循格式和引用是否可追溯;有條件時採盲評,降低評分者對模型名稱的預期影響。不要只看平均速度,也要檢查慢請求和失敗案例。

先從低風險、可回退的工作流試跑
先在不直接對外承諾的草稿或內部檢索任務測試,設定品質門檻、費用上限和停止條件。若速度改善但錯誤增加,或串接維護成本過高,就維持原流程並調整提示或工作負載後再測。評估時也要確認服務可用性、資料政策和台灣團隊實際採用的部署方式。沒有獨立重現測試前,Mercury 3 適合視為可評測的新選項,採用與否交由工作負載測量結果決定。
- Mercury 3 的每秒 token 數是 Inception 公布的測試結果,不能直接代表所有場景的實際等待。
- 擴散式生成可平行預測多個文字位置,但 token 依賴使速度和輸出品質需要一起評估。
- 用自有資料比較首字延遲、端到端時間、品質、成本與失敗率,再決定是否擴大試用。
常見問題
Q1:Mercury 3 是擴散式語言模型嗎?
是。Inception 將 Mercury 3 描述為擴散式語言模型,並表示它透過 Inception API 和多個平台提供服務。
Q2:擴散式語言模型一定比逐 token 模型快嗎?
不一定。平行預測可能縮短部分生成流程,但任務類型、輸出長度、解碼策略、硬體與服務負載都會影響結果,品質也要一併檢查。
Q3:每秒 1,068 個 token 等於一秒內收到完整答案嗎?
不等於。這是 Inception 公布的輸出速度指標,未涵蓋每種請求的首字等待、網路往返、工具執行和答案長度。
Q4:開發者該怎麼開始評估?
挑一段模型造成等待的流程,固定同一批輸入與工具,比較 Mercury 3 和現用模型的首字延遲、完整任務時間、答案品質、成本及失敗率,再決定是否擴大試用。


