
GitHub 公告引述 AT&T 資深軟體工程師 Hari Pokhrel 的回饋:Copilot Fusion Standard 會自動為任務挑選模型,減少開發者使用高階模型處理複雜任務後,忘記切回日常模型的情況;Pokhrel 表示這有助減少不必要支出,並把高階模型容量留給更重要的工作。GitHub 公告中的 AT&T 使用回饋。這是企業使用者的經驗分享,公告未提供任務樣本或前後帳單,不能據此推算團隊的實際節省。
Artificial Analysis 的 Coding Agent Index v2.0 顯示,在該測試設定中,Copilot Fusion Max 綜合分數為 60,Claude Code 搭配 Opus 5.5 Max 為 62;平均每項任務的 API 成本則分別約 5.59 美元與 11.42 美元。這是指定基準任務中的代理測試,對照設定為 GitHub Copilot 的 Copilot Fusion(max)與 Claude Code 的 Claude Opus 5.5(Max, Default Fallback),不能視為脫離代理工具與設定的單一模型比較。Artificial Analysis 的程式代理成本與分數比較
分數接近、成本約差一半,乍看像是只要換工具就能省下預算。但這組結果比較的是兩套程式代理在特定基準中的表現,不能直接換算成團隊帳單或日常程式品質。
對正在評估程式代理的開發者來說,真正要問的是:Fusion 能不能把任務交給合適的模型,交接後的結果是否容易驗收?程式代理 Harness 評估的幾個檢查點已談過代理執行環境如何影響品質;HydraFusion 的多模型工作流則可補足 Fusion 的前身脈絡。以下把焦點放在這次正式推出的 Copilot Fusion,以及試用時如何看成本、模型協作和人工覆核。
一、Copilot Fusion 的低成本數字,回答不了你的任務是否適合
不能直接代表。目前的分數與成本來自 Artificial Analysis 的 Coding Agent Index v2.0,適合比較該設定中的代理表現,不等於每個專案的預算估算。
Fusion 是 GitHub Copilot 中的模型路由與協調系統。模型路由是系統依任務選擇可用模型;模型交接則是讓不同模型分別起草、檢查或修訂同一項工作。
使用者選擇 Fusion 和推理投入程度,由系統判斷單一模型是否足夠,或採用多個模型協作。GitHub 在 2026 年 10 月 28 日宣布 Fusion 正式推出,整合 HydraFusion 的多模型協調與 Copilot 自動模型選擇。
Artificial Analysis 的指數由 FrontierCode v1.1、Terminal-Bench 4.0、SWE-Atlas-QnA-AA 三項基準組成。兩套代理的總分相差兩分,但分項並不一致:Fusion 在 Terminal-Bench 4.0 為 71%,Claude Code 為 63%;在 FrontierCode v1.1 分別為 51% 和 56%。
SWE-Atlas-QnA-AA 分數則是 Fusion 57%、Claude Code 66%。總分把不同任務合併,讀者要先想自己的工作偏向命令列操作、程式庫修改,還是依規準回答問題,再看對應分項。
| 評估項目 | Copilot Fusion Max | Claude Code Opus 5.5 Max |
|---|---|---|
| FrontierCode v1.1 | 51% | 56% |
| Terminal-Bench 4.0 | 71% | 63% |
| SWE-Atlas-QnA-AA | 57% | 66% |
| 綜合分數 | 60 | 62 |
| 平均每項任務 API 成本 | 約 5.59 美元 | 約 11.42 美元 |
這組比較顯示,綜合分數接近不代表各項任務表現相同;成本則是該基準設定下的 API 估算,不等於團隊帳單。
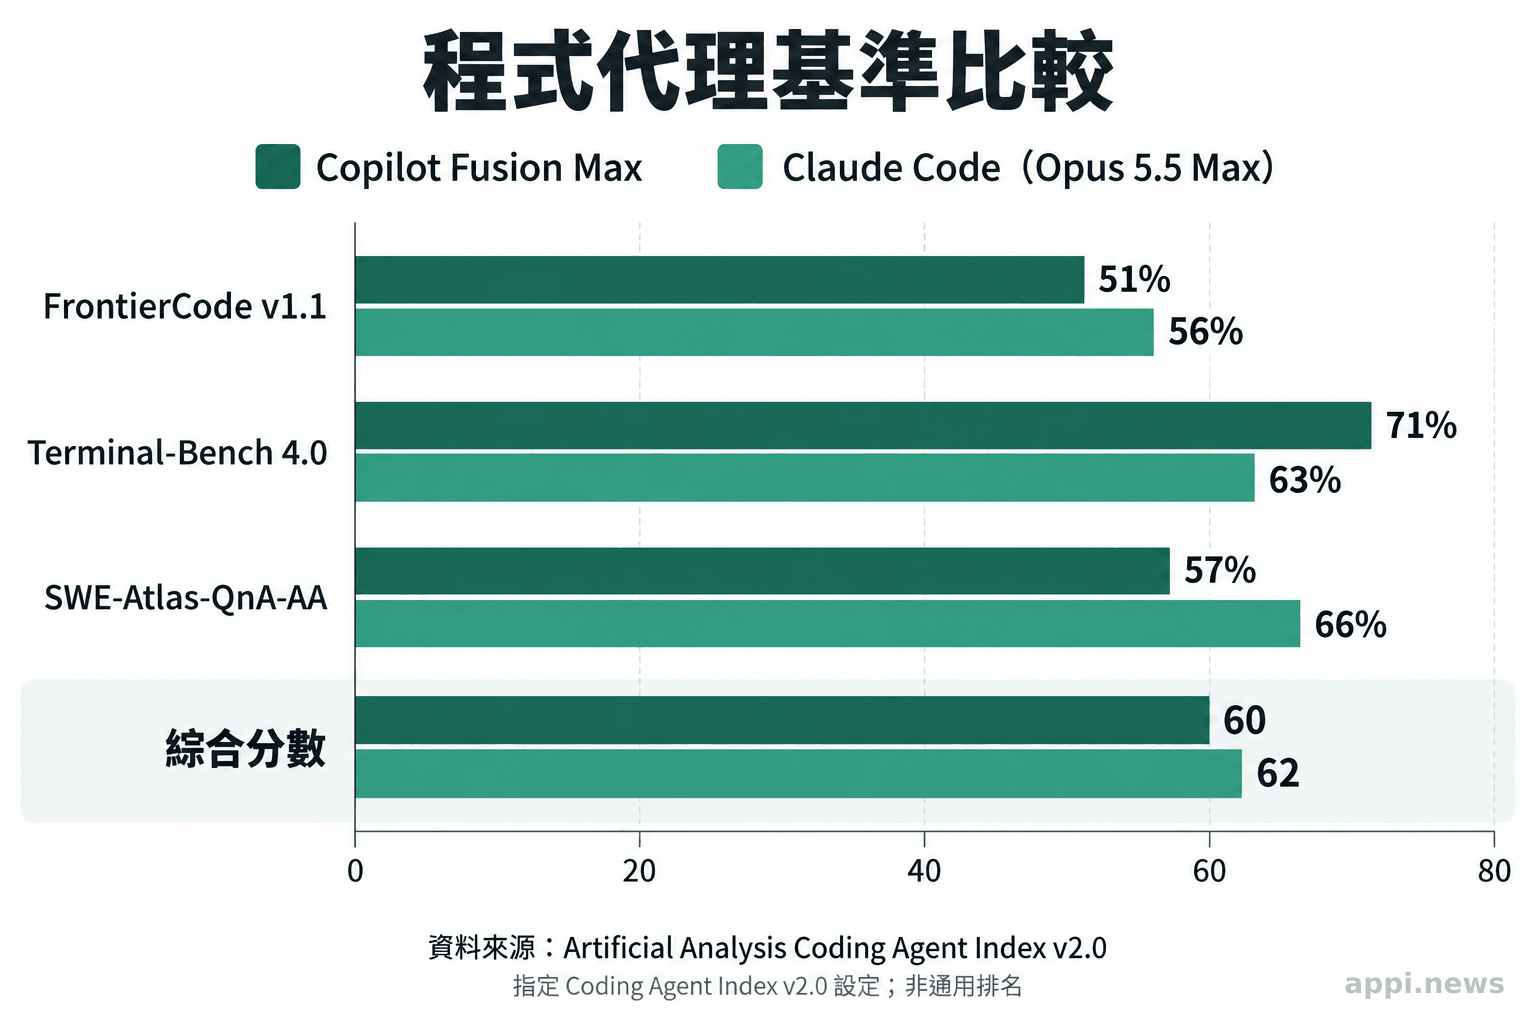
還要分清代理與模型。基準比較的是 GitHub Copilot 與 Claude Code 的完整代理設定,包含模型、工具和執行流程,並非單獨測量一顆模型。Artificial Analysis 也提醒,綜合分數相近的代理,仍可能在不同類型的工作上各有強弱。想知道自己的團隊是否受益,需以實際任務和既有流程做小規模對照。
二、GitHub Copilot Fusion 如何依任務協作
不一定。Fusion 有 Single、Cascade、Critique 三種執行方式,系統可讓單一模型完成簡單任務,也可在需要時安排檢查或修訂。
Single 由單一模型完成任務;Standard 努力等級每項任務選一個模型。Cascade 先由較有效率的模型提出解法,再由判斷模型檢查是否接受或升級至更強模型。Critique 則由一個模型起草,多個模型平行、獨立檢視,系統彙整意見後再由原模型修訂。工作流會依任務和努力等級選擇;High 或 Max 可能增加模型呼叫,讓檢查更深入,也會增加時間與 AI credits 消耗。
GitHub 公布的 HydraFusion 預覽資料顯示,Fusion 前身研究計畫曾在 Copilot CLI 和 Copilot App 路由近 6 萬個工作階段。GitHub Octoverse 對 HydraFusion 預覽的說明這是正式推出 Copilot Fusion 之前的預覽使用量,不能當成正式產品的採用數或成效證據;資料也未列出預覽工作階段的成功率、人工修正量或節省金額。
「Copilot Fusion 會為每個提示判斷使用哪些模型,以及它們如何協作。」(GitHub Copilot Fusion 官方公告) 工作流選得合適,仍須有可讀取的任務上下文。若需求沒有寫清楚修改範圍、相容性條件或完成定義,初始模型可能做出表面正確的改動,後續檢查模型也可能沿用錯誤假設。多一個模型不會自動補齊遺漏的規格;它能否找出問題,取決於檢查步驟掌握了哪些檔案、限制與測試結果。
三、基準測試的成本,和團隊帳單之間還隔著哪些條件
不會。基準的 5.59 美元是按模型 API 費率估算的平均任務成本;Fusion 在 Copilot 中則依實際使用的模型及其標準費率計費,適用中的折扣也會改變支出。
Artificial Analysis 明確說明,其成本指標採每個任務的按量 API 成本,不包含消費者訂閱方案價格,也不涵蓋基礎設施、工程和監督等完整營運成本。基準中的 Claude Code 約 11.42 美元、Fusion 約 5.59 美元,表示在該組任務與定價假設下,Fusion 的平均 API 成本較低。它沒有告訴團隊每月實付多少,也沒有把程式碼審查、回退、人工除錯與部署維護算進去。
GitHub 說明,Fusion 依它實際使用的每個模型標準費率計費,不另收 Fusion 費用。Fusion High 和 Max 可能在單項任務中使用多個模型,因此比 Standard 消耗更多 AI credits。
GitHub 文件目前列出付費方案截至 2026 年 11 月 30 日使用 Fusion,可享模型成本 30% 折扣。這是有期限的公告,採購或試算時應再核對當期方案、模型政策和定價頁,不能把折扣當永久價格。
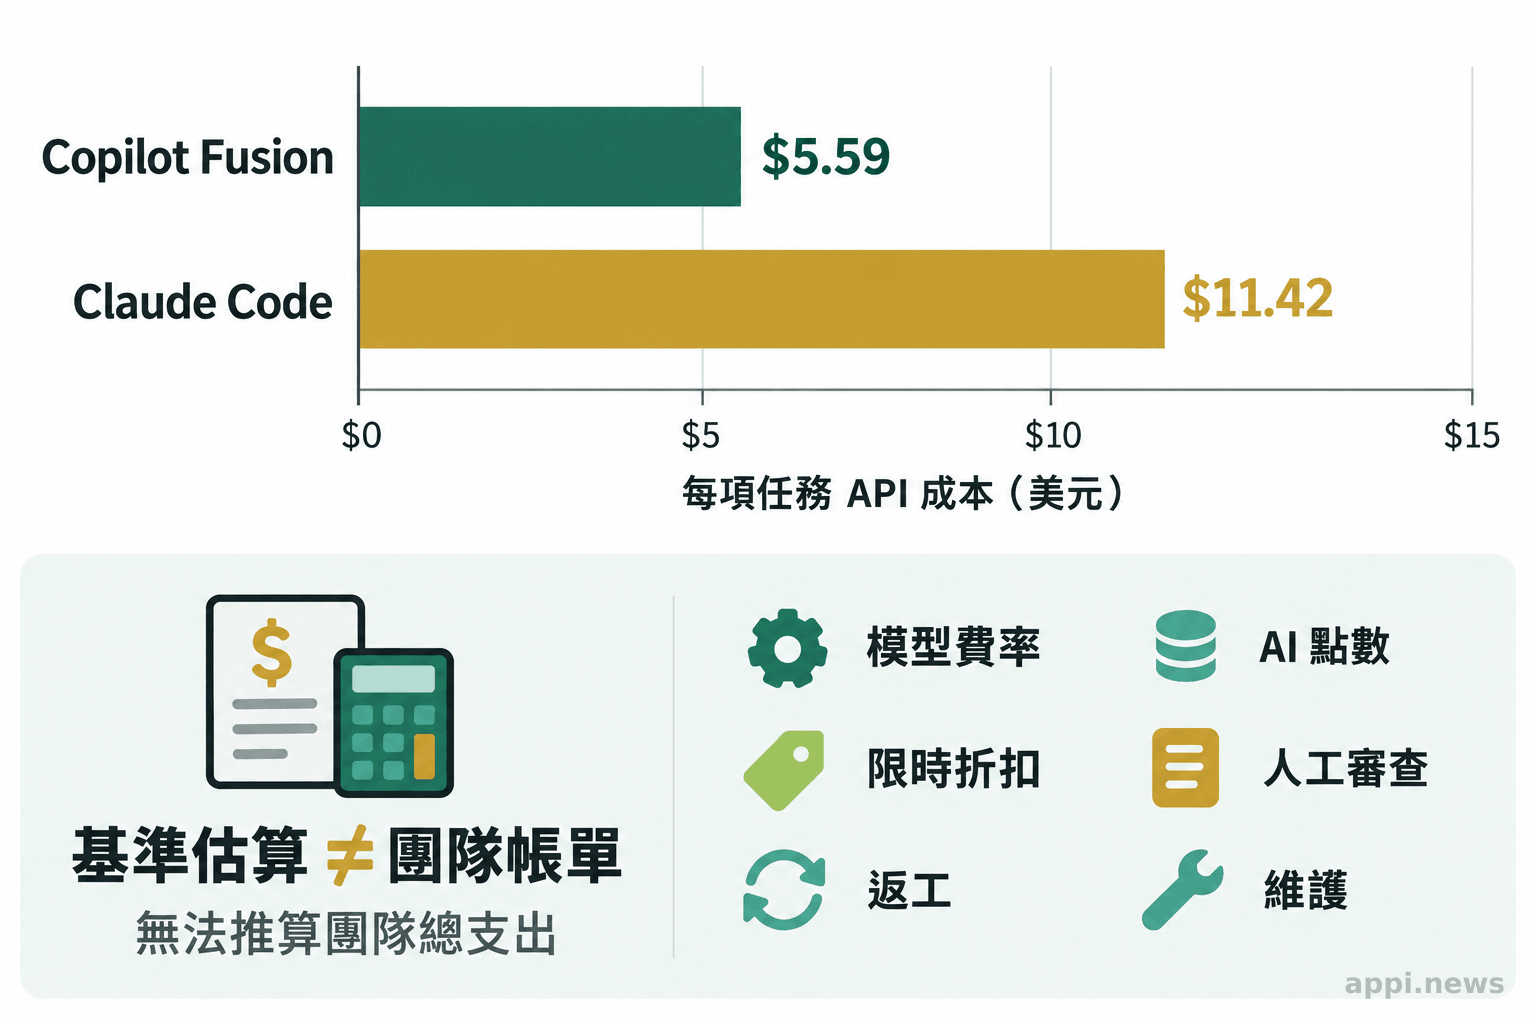
「Coding Agent Index 的成本是每項任務的 API 成本,不含完整的生產營運成本。」(Artificial Analysis 方法說明) AT&T 的回饋屬於使用者經驗,團隊仍須自行驗證成本與成效。
四、交接出錯時,增加的模型輪次可能變成返工
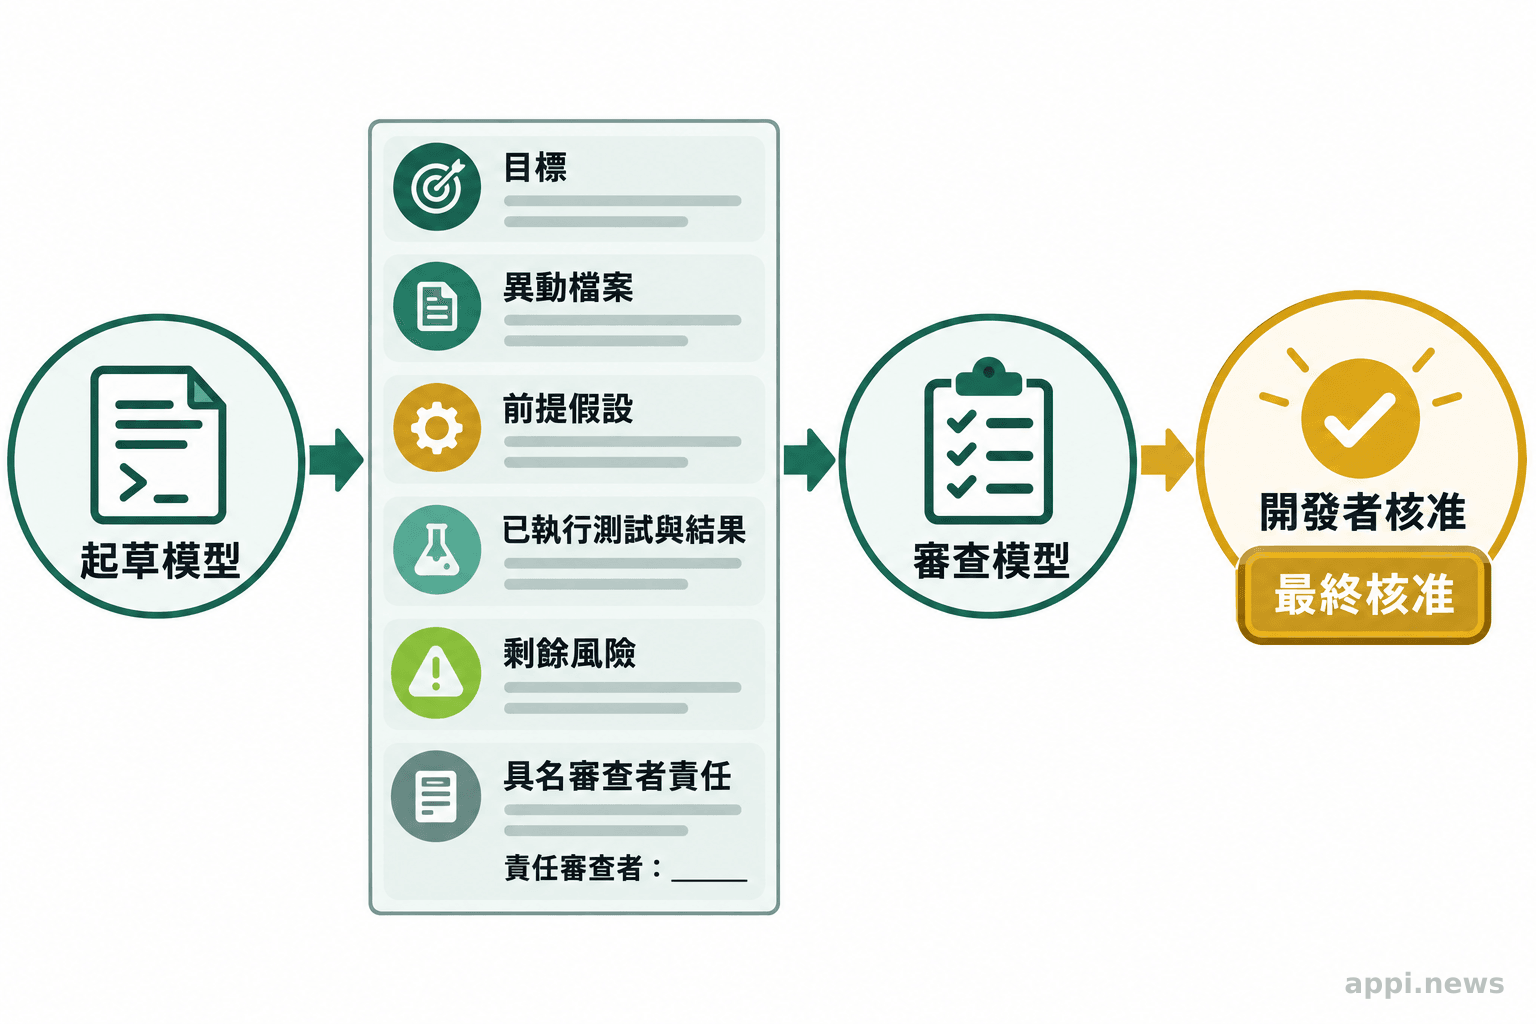
檢查目標、修改範圍、假設、測試狀態和責任人是否清楚。模型若看不到這些資訊,審查意見可能無法對應實際程式碼或完成標準。
跨模型協作的根因問題,是任務資訊能否連續傳遞。第一個模型若只留下結論,沒有交代動過哪些檔案、哪些測試失敗、哪些假設尚未驗證,接手的模型便得重新推理,可能重複工作,也可能忽略已知限制。即使工具能顯示目前步驟與使用模型,團隊仍應檢查差異檔案、執行結果與最終回覆,不要只因流程顯示完成就合併程式碼。
GitHub 文件也提醒,Fusion 丟棄草稿時,草稿已在工作區留下的檔案修改不一定會自動復原。因此驗收要回到版本控制差異,確認留下的變更都屬於本次任務,測試結果能重現,且審查者知道哪個人負責接受或退回修改。這也說明高階協作模式若增加呼叫,等待時間和審查成本需一併計入。
五、用一組可比較的任務,判斷是否值得導入
用同一批代表性任務對照既有流程,記錄品質、成本和返工,再決定適用範圍。先讓 Fusion 和原本工具完成相近的任務,並由同一套測試與審查標準判定結果。
- 挑任務分層。各選一項日常小修改、疑難除錯與跨檔案變更,固定程式庫版本、提示內容和完成條件;不要只挑 Fusion 擅長或剛好較簡單的工作。
- 分別試用模式。日常任務先測 Standard,較大變更再視需求測 High 或 Max,並保留原本單模型或既有代理的結果作對照。記下是否動用多個模型,以及是否產生額外修訂輪次。
- 記錄完整成本。除了模型費用,也記錄等待時間、人工修正與審查分鐘數、返工次數,以及測試和程式碼審查是否通過。基準 API 費用不能替代這份實際帳本。
- 檢查交接品質。確認工作目標、修改檔案、採用的假設、已跑測試及失敗項目都能追溯,並指定由誰負責最後核准。
- 按結果縮小或擴大範圍。若成本降低但返工或審查時間上升,先調整任務分流和驗收規則;若品質、成本與交接都符合團隊門檻,再擴大測試任務種類。
這樣的對照能回答團隊真正關心的問題:哪些工作交由 Fusion 有幫助,哪些工作仍適合固定模型或人工拆解。模型池、執行方式與價格都可能調整,初次試用的紀錄也應標明日期、方案、Fusion 努力等級和模型政策,日後比較才有依據。
開始試用前,先把任務的完成條件寫成可檢查項目,例如指定測試須通過、不得改動公開介面、變更須附上遷移說明。若只用「看起來寫得不錯」評分,審查者容易被語氣和答案長度影響,難以比較兩套流程。測試標準固定後,再看同類任務中 Fusion 是否減少人工介入,或只是把工作轉移到後續檢查。
未完成、測試失敗或需要人工大幅修補的任務,也要列入平均值,避免只計成功案例而低估真實成本。
GitHub 與 Accenture 以隨機對照研究觀察企業開發者使用 Copilot,報告稱 PR 合併率增加 15%、成功建置增加 84%。GitHub 與 Accenture 的研究說明。這是特定企業的研究結果,不能推論為 Fusion 或其他團隊的預期成果。
KOHLER 透過管理支持、推廣者社群與分層培訓導入 Copilot。Microsoft 客戶案例稱,該公司使用 GitHub Copilot 後程式碼發布提升 25%、錯誤缺陷率降低 75%,5,000 名員工每週節省 2 至 5 小時。Microsoft 的 KOHLER 客戶案例。這是廠商刊載的個案回報,未交代量測方法,也不能推論為 Fusion 或其他團隊的預期成果。
- Fusion Max 在特定 Coding Agent Index v2.0 的綜合分數是 60,平均 API 任務成本約 5.59 美元;基準結果不能當作團隊報價。
- Single、Cascade、Critique 對應不同的分流與檢查方式,多模型協作不保證每項任務都變好或變便宜。
- 試用時同步記錄費用、通過率、等待、人工修正、返工與交接資訊,再決定哪些任務適合採用。
常見問題
Q1:Copilot Fusion 是一個新的 AI 模型嗎?
Copilot Fusion 是模型路由與協調系統,依任務和可用政策選擇模型,必要時安排多個模型依序處理。
Q2:Fusion 每個任務都會用多個模型嗎?
不一定。Single 可由單一模型直接作答;Cascade 或 Critique 才會加入檢查、升級或修訂步驟。
Q3:Fusion 一定比單一模型便宜嗎?
不能這樣推論。Artificial Analysis 的特定基準測得較低平均 API 成本,但實際費用取決於模型、任務、努力等級、使用量及適用折扣。
Q4:企業試用時要優先檢查什麼?
確認管理員允許的模型與方案、實際計費方式、程式碼差異與測試結果,以及誰負責最終審查;再用代表性任務與既有流程對照。
參考來源
- GitHub (2026). Route and orchestrate models with GitHub Copilot Fusion. *GitHub Changelog
- Artificial Analysis (2026). Claude Code vs. GitHub Copilot: Coding Agent Comparison. *Artificial Analysis
- GitHub (2026). About GitHub Copilot Fusion. *GitHub Docs
- GitHub (2026). Octoverse: Commits, pushes, reach new highs in 2026 as developers build with agents. *The GitHub Blog
- Gao Y, et al. (2024). Research: Quantifying GitHub Copilot’s impact in the enterprise with Accenture. *The GitHub Blog
- Microsoft (2026). KOHLER achieves 98% Microsoft 365 Copilot adoption with AI change management strategy. *Microsoft Customer Stories


