
一項由卡內基美隆大學、牛津大學、加州大學柏克萊分校、麻省理工學院與加州大學洛杉磯分校研究者共同完成的實驗,讓參與者先用 AI 解分數題,再突然拿走工具。AI 使用者在有工具時較常答對,工具撤除後,獨立作答正確率下降,跳過題目的比例也上升。這些線上實驗共招募 1,222 人,涵蓋分數運算與 SAT 式閱讀理解,研究結果刊於 2026 年語言模型會議相關論文。(論文原文)
這個反差和 AI 學習工具的常見承諾有關:答案更快出現,眼前任務便容易完成;但產品若以「當下答對」作為主要成效,可能漏看使用者稍後獨立作答的狀況。設計者可參考如何評估 AI 研究中的不確定性與產品風險,先界定系統正在提供答案、提示,還是協助檢查思路。
研究提出值得追問的問題:短暫 AI 協助後的差異,究竟代表能力永久改變,還是使用者在工具突然撤除時較少作答?這兩種解讀並不相同,產品評估也需要分開看正確率、是否繼續嘗試,以及較長時間後能否獨立完成類似任務。
一、AI撤除後,三組解題實驗出現什麼變化?
三組實驗都觀察到 AI 使用者在工具撤除後的獨立作答表現較低;跳題增加的結果則並非每組都達顯著差異。研究使用分數題與閱讀題,並在學習階段後安排無 AI 測驗。
分數題第一組招募 354 人,參與者先做 12 題分數題,再獨立回答 3 題;AI 組在前 12 題可用側欄中的 GPT-5。研究剔除注意力檢核未過及基礎題未達標者後,分析 305 人。AI 組最後三題平均答對率為 57%,控制組為 74%;平均跳題率則為 20% 和 11%。這表示差異同時出現在答對表現與是否作答,但它是工具撤除當下的結果。
第二組有 667 名參與者,先用無 AI 前測確認基本能力,也替控制組安排同樣會消失的側欄,以排除介面改變造成的干擾。最終分析 585 人,AI 組在工具撤除後的答對率為 71%,控制組為 77%,差異達統計顯著;兩組跳題率差異則未達顯著。這次重複實驗支持獨立表現差異,但不宜把持續作答的結果說成每組都一致。
第三組把任務改為 SAT 式閱讀理解。201 人受邀參與,剔除檢核未過者後分析 168 人;AI 組先用工具處理 5 題,再自行完成 3 題。撤除工具後,AI 組答對率為 76%,控制組為 89%;跳題率分別為 8% 與 1%。這提供了另一種任務的相似觀察,但仍是短時間、線上題目,不等同真實課堂的學習成效。柏克萊校方對三組研究設計與樣本的報導也指出,參與者是在網路平台完成實驗。
二、研究測得的是短期表現與作答行為
不能。研究測量的是短暫使用 AI 後、工具立即撤除時的答題與跳題情形,沒有追蹤數週或數月,也沒有測量永久的智力或能力變化。
隨機分派讓研究者得以比較實驗條件下的差異,且第二組以能力前測和對照介面補強第一組可能存在的混淆。不過,三組參與者都是美國線上招募者,任務集中於分數運算和 SAT 式閱讀題,並使用可直接提供完整解答的 AI。真實學習可能包含教師回饋、課堂討論、反覆練習與不同工具設定,不能直接把這些結果套用到所有年齡、科目和產品。
研究也沒有在數週後重新測驗參與者。論文作者明確指出,效果能否持續、累積或消退仍待縱向研究確認。研究觀察到的「獨立表現較差」,指的是那幾題立即測驗的平均正確率較低;「持續作答較少」則以跳題行為作為指標,不能直接等同學習動機或毅力已發生長期改變。
「是否能以蘇格拉底式 AI 保留協助效益,同時避免持續作答上的代價,仍是重要的開放問題。」(Liu 等人,論文結論(中譯))
三、直接代答與提示輔助要分開看
論文中的探索性分析顯示,差異較集中在自述曾向 AI 索取直接答案的參與者;自述使用提示或釐清問題者沒有呈現相同程度的表現落差。這項比較源自非隨機分派的使用方式分析,不能作為因果證據。
第二組實驗結束時,研究者詢問 AI 組如何使用工具。約 61% 自述主要取得直接答案,27% 自述索取提示或釐清,另有 12% 表示未使用 AI。直接答案組後測答對率較低、跳題較多;提示組相較控制組沒有顯著的整體損害。不過,使用方式是參與者自行選擇並在事後回報,並非研究者將人隨機分到「直接答案」或「提示」兩組。因此,先前能力、題目難度感受或使用習慣等因素,都可能和選擇的協助方式同時相關。
研究者提出兩種可能解釋:若答案總在數秒內出現,使用者可能逐漸把這個速度當成標準,獨立思考便顯得更費力;直接取得答案也減少自行嘗試與發現錯誤的機會。這是作者提出的機制假說,實驗沒有直接證明哪一個機制造成觀察結果。提示式互動因而值得產品團隊測試,但目前不能宣稱提示一定能保住學習成效。
「AI 的回應可以預設得更有教學性,像一位家教。」(Brian Christian,柏克萊新聞報導(中譯))
四、查詢、練習與評量任務需要不同揭露方式
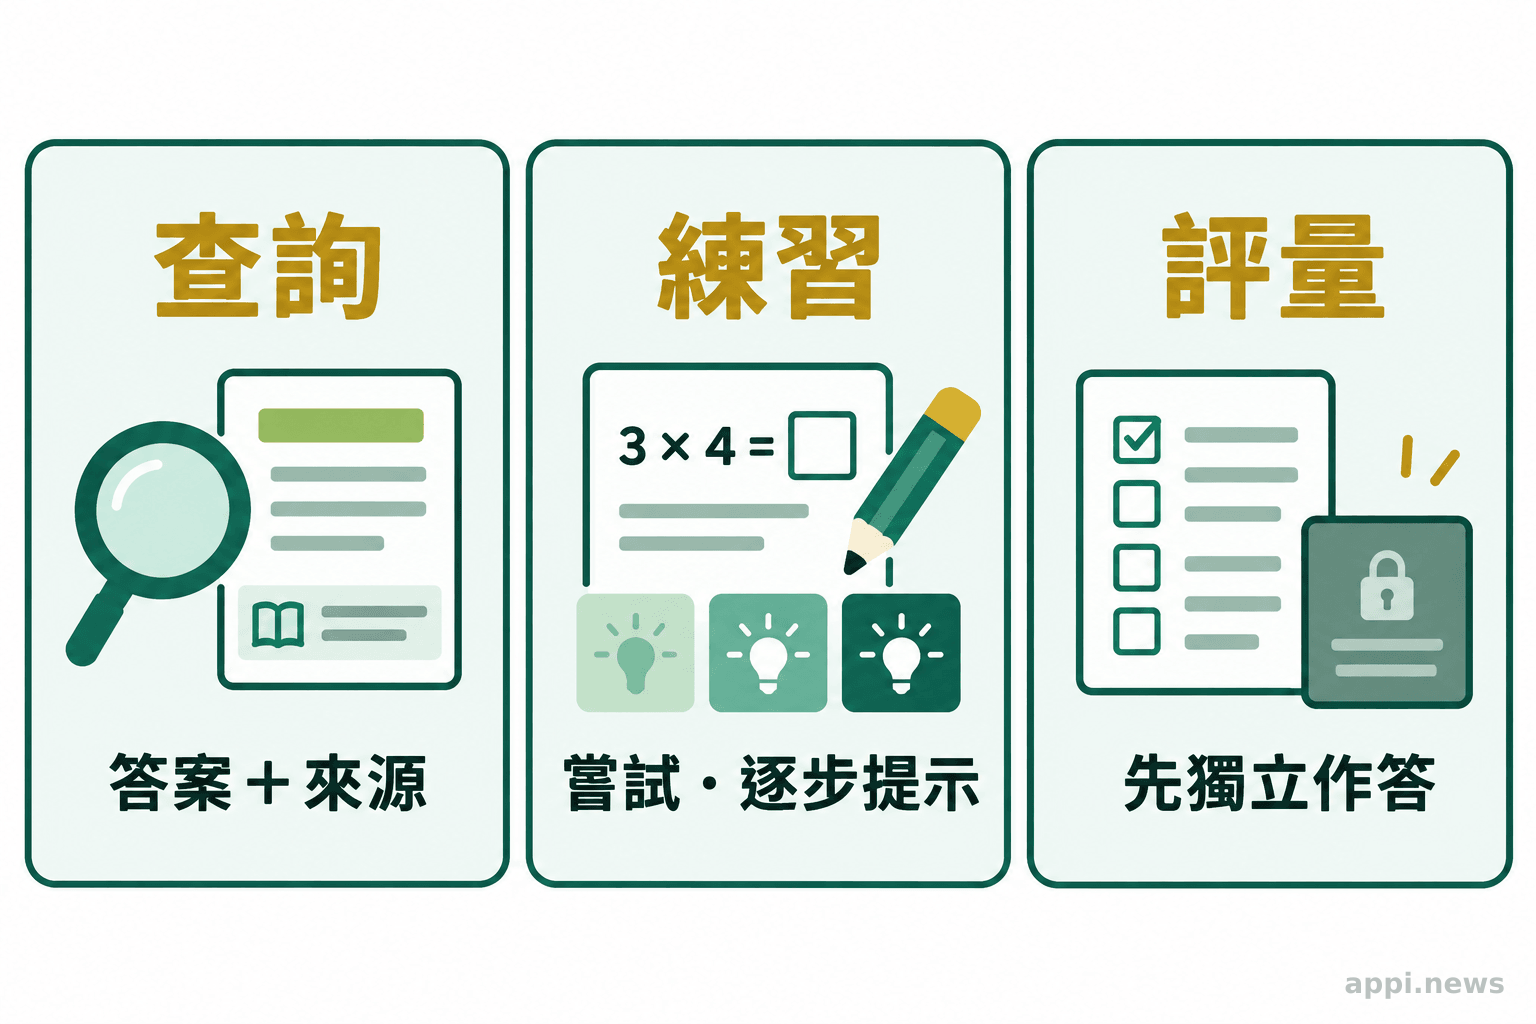
答案揭露方式要依任務目標安排:查詢重視效率,練習需要保留嘗試空間,評量則應先避免答案介入。下表是根據任務目的整理的產品設計選項,並非研究已驗證的最佳配置。
| 任務 | AI 介入方式 | 使用者該保留的活動 | 可觀察的成效 |
|---|---|---|---|
| 查詢概念或事實 | 可先給簡明答案,再附來源與解釋 | 判讀答案是否符合情境 | 資訊是否正確、能否找到依據 |
| 練習解題 | 先問使用者做過哪一步,再分層提供提示 | 嘗試、說明思路、修正錯誤 | 提示後能否自行完成相近題 |
| 評量或檢核 | 作答期間暫不顯示解答,完成後再回饋 | 獨立作答 | 無 AI 時的正確率、作答時間與跳題情形 |
這種分流讓答案揭露程度對應任務目標。使用者若只是查名詞,直接答案可能正合需要;若目標是學會解法,系統可以先提供方向或追問步驟,再由使用者選擇是否查看完整解答。若是正式評量,則要明確標示 AI 是否開放,避免把有工具和無工具的成績混為一談。
面向兒童或未成年人的工具,還需額外評估年齡、學習階段、題目難度、家長或教師如何設定協助層級,以及孩子能否在無提示時完成相近任務。單一成人線上實驗不足以替兒童產品決定答案揭露政策。
五、產品團隊可用獨立作答檢查學習成效
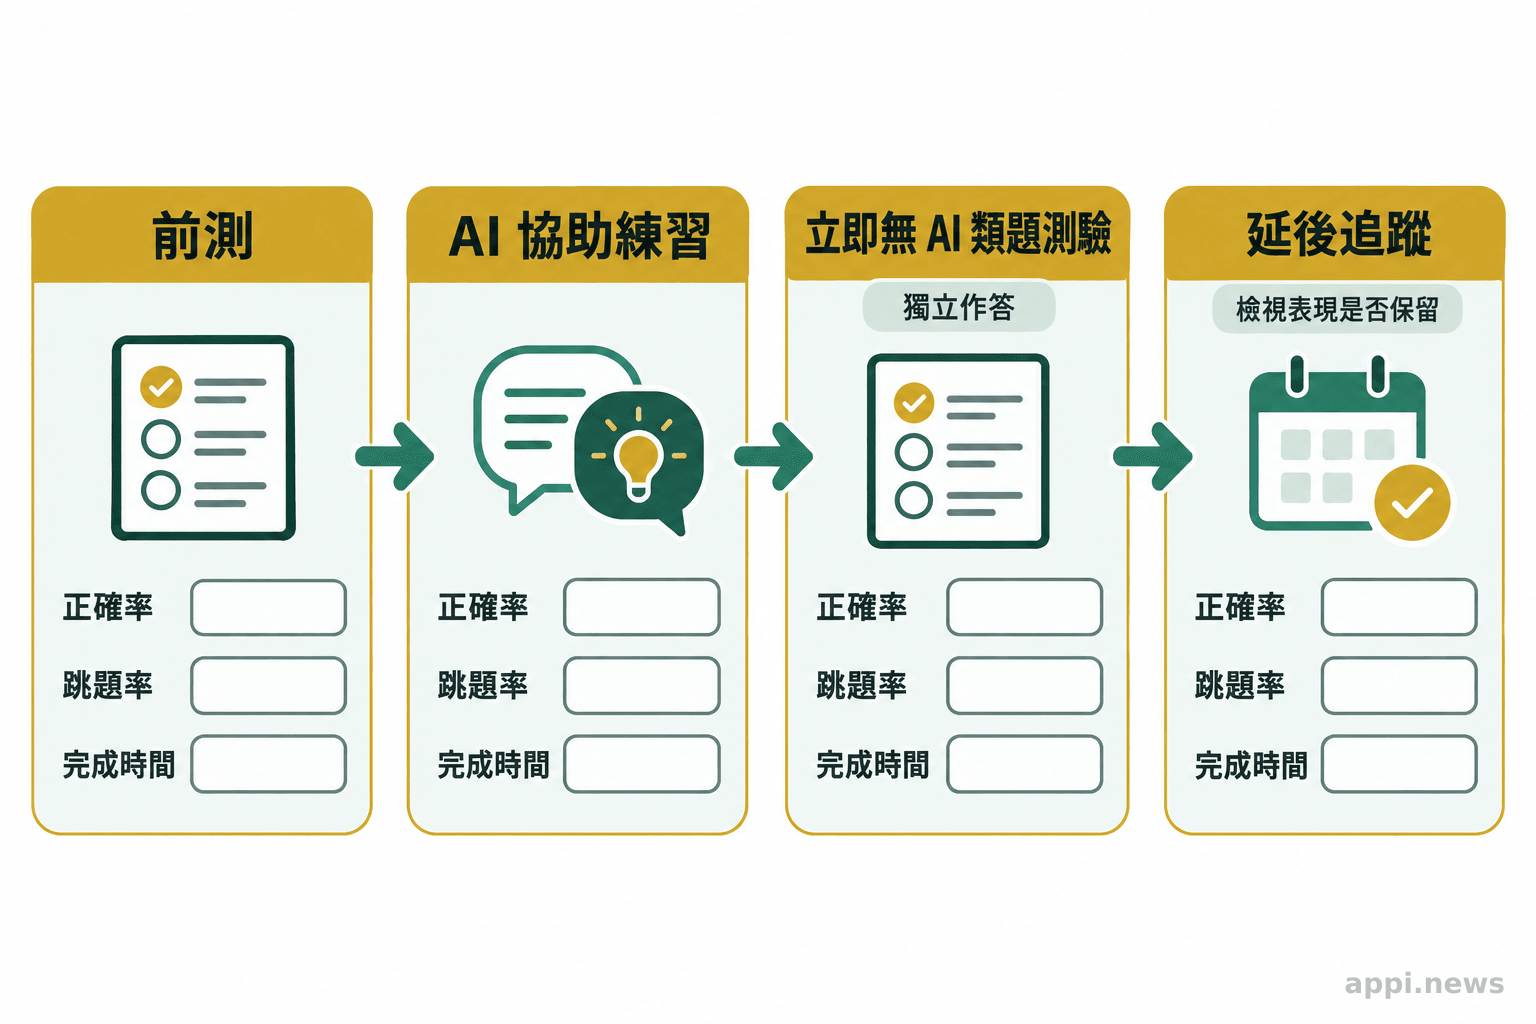
除完成速度與當下正確率,還要測量使用者在提示減少或工具撤除後,能否完成相近題目,並在延後測驗中維持表現。產品指標應對應它承諾要改善的能力。
可以用以下檢查清單設計試用評估:
- 先定義目標。 這個功能是在查資料、教會一種解法,還是替使用者評量?若目標是學習,需設定無 AI 情境下的獨立作答指標。
- 記錄協助層級。 區分完整答案、提示、概念說明和錯誤檢查,並記錄使用者在哪個階段索取協助。
- 比較相近任務。 使用前測、使用後的無 AI 題目,以及難度相近的新題,觀察正確率、跳題率與完成時間;避免只看同一題背答案。
- 安排延後測量。 隔一段時間再測同類能力,判斷短期完成是否轉成可保留的知識。這屬於產品評估建議,論文沒有實際追蹤。
- 依族群拆分結果。 若使用者包含兒童,另看年齡和學習階段差異,並與教師、家長確認提示及答案揭露是否符合教學目標。
研究團隊在結論中主張,AI 設計應同時觀察人們「能用 AI 做什麼」以及「沒有 AI 時仍能做什麼」。對產品團隊而言,這代表完成率只能回答工具是否幫忙做完眼前任務,獨立作答與延後表現才能補上工具是否支持能力成長的線索。
- 三組線上實驗觀察到短暫 AI 協助後的獨立答題表現差異,但沒有證明永久能力退化。
- 直接取得完整答案的使用方式與較低後測表現相關;提示分析屬探索性結果,不能視為隨機實驗的因果結論。
- 評估學習型 AI 時,將當下完成率與無 AI 的獨立作答、延後測驗分開追蹤。
常見問題
Q1:研究是否證明 AI 會永久削弱解題能力?
沒有。參與者在工具撤除後立即完成少量測驗,研究沒有追蹤長期變化,因此不能推論永久或長期能力退化。
Q2:使用提示也會造成相同結果嗎?
論文的事後自述分析中,提示或釐清組沒有呈現與直接答案組相同的顯著落差;但使用方式並非隨機分派,提示的保護效果仍需專門實驗驗證。
Q3:哪些任務適合直接取得答案?
單純查詢概念或事實時,直接答案可能符合效率目標;練習和評量則應依學習目的安排提示、解答揭露與無 AI 作答,並實際檢查使用者能否獨立完成相近任務。


