
很多人在談 AI 科學研究時,第一個想到的是搜尋速度;但這裡要先問一個更前面的問題:AI 縮小的是資料庫範圍,還是已經證明候選具有抗菌效果?Google DeepMind 以 Antigravity 示範尋找抗菌胜肽,呈現的是一條由序列預測、資料庫比對、結構檢查到基因脈絡分析的候選篩選流程。計算結果能讓研究者把注意力集中到較值得測試的分子,卻還不能回答它在實驗中是否有效、安全或能成為治療方式。
一、AI 搜尋抗菌胜肽,先分清楚候選排序與活性證明
不代表。 AI 搜尋流程提供的是候選假說與計算支持,抗菌活性、對人體細胞的影響及治療價值,仍須經過適當的實驗和後續研究確認。
抗菌胜肽研究面對的資料搜尋瓶頸
抗菌胜肽是能抑制或殺死細菌的一類短蛋白質分子,其中細菌素(bacteriocin)是細菌產生、可影響其他細菌的胜肽。自然界累積大量細菌與環境微生物的基因序列,基因定序越普及,蛋白質資料庫就越龐大。難處在於,資料庫中許多序列只有編號或「功能未知」標記,研究者即使取得序列,也未必能從已知名稱直接找到它可能參與的生物功能。
若逐筆比對、查看結構資料、檢索基因周邊序列,再回頭搜尋文獻,步驟會散落在不同網站和分析工具。研究者得在檔案格式、資料欄位與分析結果之間來回整理。時間花在串接資料,不一定花在最需要判斷的生物學問題上。
Antigravity 示範回答的是哪一段研究流程
Google DeepMind 的文章將 Antigravity 描述為可供研究者與 AI 代理協作的科學工作環境。示範的任務是從 Streptococcus pseudopneumoniae(偽肺炎鏈球菌)相關蛋白質中尋找新型抗菌胜肽;研究者設定搜尋目標、逐輪決定要補查的證據,代理則協助串接資料庫查詢、結構分析及文獻整理。
模型與代理可以加快搜尋、整理和提出假說,研究者仍需界定問題、檢查結果並安排驗證。示範將多個原本分開的工作放在同一個協作流程中,說明的是研究探索可能如何進行,不等於整個抗菌藥物開發已自動化,也沒有證明每項任務都能在其他實驗室以相同時間完成。
二、從 ProtNLM 到資料庫比對,候選如何逐步縮小
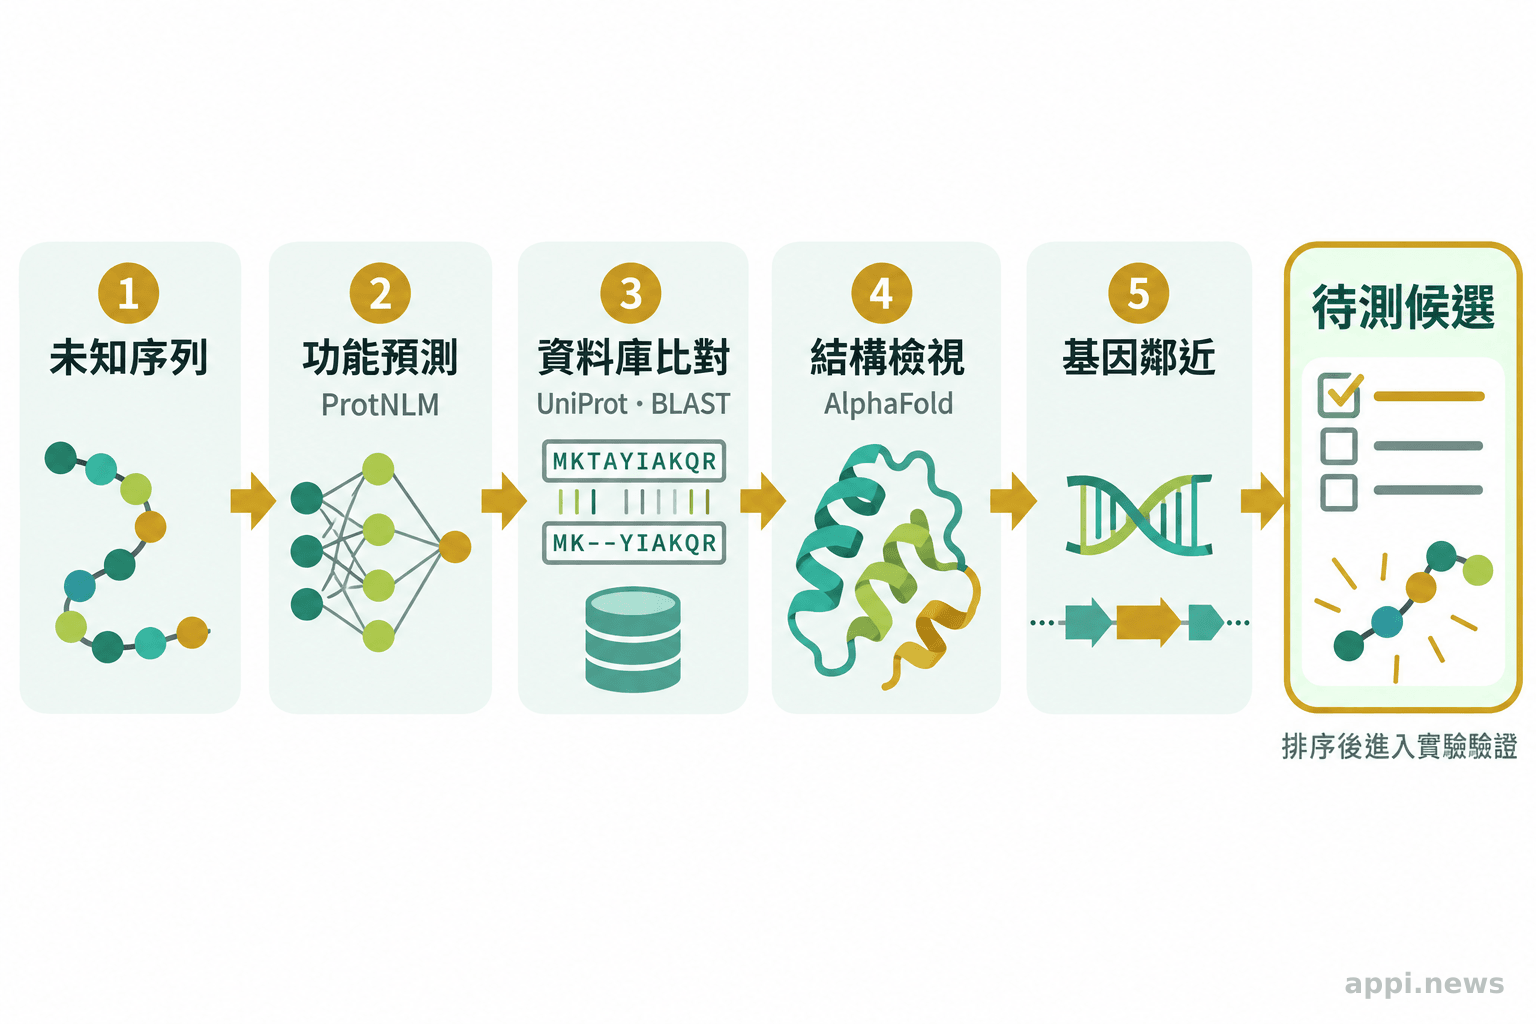
流程先用 ProtNLM 從序列預測功能,再由研究者引導代理查核序列相似性、預測結構和基因鄰近資訊。 各項線索互相補充,協助判斷哪些序列值得進入下一輪研究。
蛋白質序列功能預測如何提供搜尋線索
蛋白質由胺基酸序列組成,序列中保留演化與功能相關的模式。ProtNLM 是 Google 開發的蛋白質自然語言模型,DeepMind 在示範文中說明,它可從原始胺基酸序列預測生物功能,並協助替 UniProt 中先前未註解的蛋白質補上功能標籤。
這類預測相當於提出一個可以繼續查證的方向,例如某段序列可能與細菌素相關。它不會直接量到胜肽如何影響細菌,也不能單靠模型標籤確認蛋白質在特定菌株、培養條件或人體環境中的作用。預測的價值在於讓搜尋有較具體的起點,接下來仍要找不同來源的資料支持或推翻這個假說。
BLAST、AlphaFold 與基因鄰近資訊各自補上什麼證據
示範案例把一個 97 個胺基酸長的序列列為候選,資料庫註記將它歸在 Lactococcin 972 家族。研究者接著引導代理透過 BLAST(基本局部序列比對搜尋工具)與 Swiss-Prot 的人工審核蛋白質比對,檢查是否有已知的近似序列。DeepMind 表示,這次比對未找到有意義的同源序列。這支持「可能具有新穎性」的判斷,但資料庫中找不到近似序列,不會自動證明它真的有抗菌功能。
第二層是結構線索。代理從 AlphaFold 蛋白質結構資料庫取得預測模型,再以 Foldseek(蛋白質結構相似性搜尋工具)搜尋實驗結構並疊合。DeepMind 說明,候選的折疊形狀與一種已實驗解析的細菌素相近,與 ProtNLM 的功能預測方向相符。這能提高假說的生物學合理性,仍受限於結構模型品質、比對方法與實際分子狀態;結構相似不等於功能必然相同。
第三層看基因周邊。基因在染色體上的鄰居有時能提示同一區域的基因是否共同參與某個生物系統。DeepMind 指出,候選基因上游僅隔 6 個鹼基,附近有 ABC 轉運蛋白相關基因、另一個已註解的細菌素及 XRE(異生物反應元件)家族轉錄調節因子。這組排列為細菌素系統假說提供脈絡支持,但也需要基因表現、蛋白質功能與實驗資料進一步查證。
三、多層計算證據支持假說,仍不能代替實驗室驗證(濕實驗)
至少包括能否抑制目標細菌、有效濃度、對人體細胞的毒性與選擇性,以及作用範圍。 序列、結構或基因脈絡都不能取代這些測量。
序列、結構與基因脈絡的交叉檢查
不同計算證據的用途並不相同。序列模型提供可能的功能標籤,序列比對用來看與已知蛋白質的相似程度,結構搜尋檢查三維形狀是否與已知分子接近,基因鄰近分析則把單一蛋白質放回細菌基因組的上下文。若多條線索方向相同,研究者更有理由把候選送進實驗室,但仍要留意它們可能共用相同資料或假設,不能把多個相關預測當成多次獨立實驗。
抗菌作用也涉及細菌種類、菌株、培養環境、胜肽濃度和作用時間。資料庫中的新穎性,不能回答候選在培養皿中能否抑菌。研究者可用最低抑菌濃度等方法測量活性,並測試不同菌種與菌株;若只有單一條件或單一菌株的結果,適用範圍就應限制在該實驗條件內。
抗菌活性、毒性與選擇性仍須實驗測量
對抗菌胜肽而言,「能影響細菌」並不足以判斷它是否適合作為治療候選。若胜肽同時傷害人體細胞,或有效濃度接近有害濃度,治療用途便會受到限制。研究者需要分別測量抑菌效果、宿主細胞毒性、溶血等安全性指標,並觀察活性是否能選擇性作用於目標微生物。臨床前研究還需回答穩定性、體內分布、免疫反應及給藥方式等問題。
| 證據階段 | 可以回答的問題 | 仍不能單獨回答的問題 |
|---|---|---|
| 序列與功能預測 | 哪些蛋白質可能值得優先檢查? | 候選是否實際抑菌? |
| 結構與基因脈絡分析 | 功能假說是否有其他計算線索支持? | 活性強度、人體安全性如何? |
| 體外實驗 | 在特定菌株與條件下是否有活性? | 能否治療人體感染或改善臨床結果? |
| 動物與臨床研究 | 在更接近治療情境時的效益與風險為何? | 能否直接推廣到所有族群與感染? |
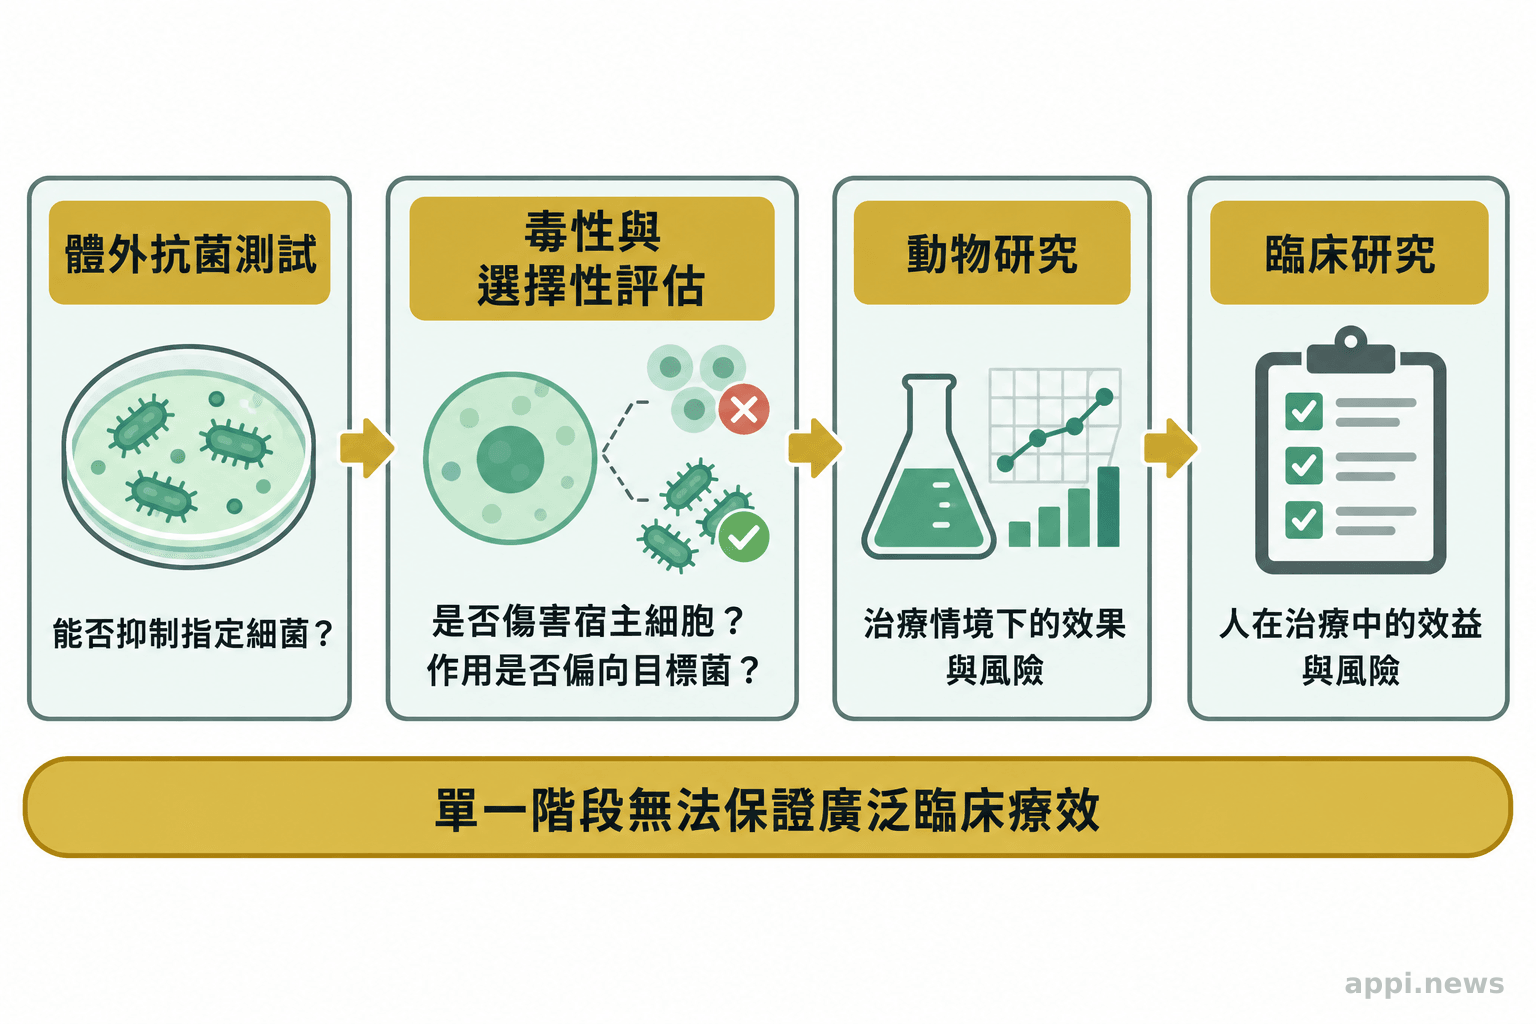
抗菌胜肽的計算篩選與實驗驗證有先後關係,不能互相代替。2021 年刊於《Annual Review of Biomedical Engineering》的回顧指出,胜肽對不同細菌的選擇性仍難以單靠理化性質設計,並整理了評估活性與選擇性的實驗方法。研究設計應依目標問題安排測試,不能只因模型預測「可能有效」就跳過毒性與選擇性檢驗。
“it remains challenging to design targeting peptides to discriminate between different bacteria” — 2021 年《Engineering Selectively Targeting Antimicrobial Peptides》回顧文章摘要
抗菌胜肽或抗生素的研究候選不代表可供一般人使用,也不構成用藥建議。孕婦、兒童、慢性病患者及長期服藥者,不應自行嘗試研究用胜肽或調整抗生素。若未來研究探討候選與現有抗生素併用,協同、拮抗及毒性都要以實驗檢查;進入臨床研究或治療開發時,也需評估受試者用藥、疾病狀態與族群特徵。
四、Antigravity 接入研究流程後,研究者仍需把關哪些環節
團隊應保存資料來源、版本、查詢條件、模型輸出與人工覆核紀錄,並清楚指定誰負責實驗驗證。 能追溯每個判斷,才有機會重現結果並找出錯誤發生在哪一段。
資料來源、分析步驟與候選排序的可追溯性
把資料查詢集中到同一個介面,能減少手動切換工具的負擔;但若看不見代理實際呼叫了哪個資料庫、使用哪個版本、採用什麼篩選條件,結果就難以重現。研究團隊應記錄原始序列的識別碼、資料庫版本與日期、模型名稱、分析參數、查詢紀錄和候選淘汰理由。代理摘要文獻時,也應保留論文連結並核對摘要依據。
研究者需要能檢查關鍵中間產物,包括序列比對結果、結構疊合依據、鄰近基因註釋和文獻出處。人工覆核的目的在於確認模型是否用對資料、是否跳過反例,以及排序依據是否符合實際研究問題。發現輸出互相矛盾時,團隊也要能回到特定步驟重查,並保留每個候選名稱形成的依據。
工具接入現有流程還有整合成本。實驗室可能使用不同的資料格式、權限規則與計算環境;敏感資料或尚未公開的研究資料,則要先確認存取權、保存方式及供應商的資料處理條件。將研究資料交給外部服務前,團隊應依機構政策與研究倫理要求評估資料能否上傳。
實驗回饋如何校正模型與研究假說
模型排序只是決定「先測誰」的方法之一。實驗的陰性結果同樣重要:若候選沒有抑菌活性,研究者應檢查假說、序列註釋、實驗條件與測試菌株是否有問題,再決定要調整搜尋條件或停止追蹤。陽性結果也要在獨立實驗或不同條件下重現,並與未經模型排序的候選或既有方法比較。
AI 代理產生的實驗計畫可以提供工作草案。DeepMind 示範包含蛋白質表現、抗菌感受性測試、標靶作用與體外毒性測試等想法,但具體設計仍須由熟悉相關技術的研究者檢查。實驗室要確認菌種與操作條件合適、對照組能回答問題、樣本數足以判讀,並依生物安全與倫理要求執行。代理生成計畫的速度,不能取代實驗設計的專業責任。
“The lead identified here is now undergoing wet-lab validation.” — Google DeepMind,〈Google Antigravity: Accelerating Antimicrobial Peptide Search — Google DeepMind〉
五、評估 AI 搜尋工具的實際效益,應看哪些指標
要用同一研究問題比較導入前後的搜尋時間、人工步驟、實驗成本與命中率,並公開候選和淘汰標準。 單一成功案例可說明流程如何操作,尚不足以證明工具普遍省時或提高實驗成功率。
比較人工流程與工具流程的時間、成本及候選命中率
DeepMind 表示,Antigravity 可把原本分散於多個資料庫的搜尋壓縮到單一協作流程,並稱過去需要數天的資料整理可以在一次協作工作階段中完成。這是開發者對示範的描述,文章沒有提供獨立對照研究、明確計時方式、實驗室間重現資料,或導入前後命中率及成本的比較數據。因此,這些說法適合作為待驗證的效益假設,不能直接視為已證實的效率提升。
研究團隊可把「更快」拆成指標:從提出問題到得到候選清單用了多少工時、多少步驟仍需人工處理、工具與資料存取成本是多少、候選進入實驗後有幾個達到事先設定的活性和安全性門檻。只統計模型列出多少候選,無法說明候選品質;只挑成功案例,也會忽略被淘汰或實驗失敗的結果。
比較時應事先固定研究問題、資料庫快照、目標菌種、候選定義和實驗判定門檻。人工流程與工具流程最好各自保留完整紀錄,避免因一組採用較新的資料或不同實驗條件,造成看似有效的差異。若測試候選數量不同,可同時報告每個候選的實驗成本、每個陽性候選所需成本,以及從全部候選到有效候選的比例。團隊也可以檢查結果是否由少數研究者特別熟悉工具所帶來,或新進使用者也能重現。
依研究問題、資料品質與實驗能力決定導入範圍
Antigravity 示範聚焦在特定物種與一段候選搜尋,不能直接推論其他病原體、其他蛋白質類別或所有研究室都會得到相同結果。導入評估先問清楚原流程卡在哪裡:是資料散落、序列註釋不足、結構分析需要專業程式,還是實驗室缺少驗證候選的能力?如果瓶頸在實驗設備、胜肽合成成本或安全性測試,搜尋介面再方便也不會自動排除這些限制。
研究團隊可先選定一個具體搜尋問題,事前寫下資料來源、候選排序與淘汰規則、人工覆核點及實驗判定指標,再用同一套條件比較工具導入前後的時間、成本與實驗命中率。結果也應納入負面發現,供其他團隊判斷適用條件。這樣才能把「看起來流程更順」轉成可檢查的研究效益。
- 設定一個清楚的目標菌種與搜尋問題,固定資料庫版本及候選條件。
- 記錄每個候選的預測依據、資料來源、淘汰理由與人工覆核結果。
- 預先訂定活性、選擇性及毒性實驗門檻,納入陰性結果。
- 比較導入前後的人工工時、總成本、候選實驗命中率與重現性。
- Antigravity 示範把序列功能預測、資料庫比對、結構檢視與基因脈絡分析串成候選搜尋流程。
- 多種計算線索可以提高候選假說的合理性,不能證明抗菌效果、安全性或臨床效益。
- DeepMind 表示候選仍在濕實驗驗證,示範尚未提供獨立的時間、成本或命中率對照。
- 導入工具前,研究團隊應先訂出可追溯紀錄、人工覆核責任與實驗判定指標。
常見問題
Q1:Google Antigravity 在這項研究中是抗菌胜肽模型嗎?
Antigravity 在 DeepMind 示範中扮演協作工作環境,由研究者引導 AI 代理串接資料庫查詢、結構分析與文獻整理;ProtNLM 則是用來預測蛋白質功能的模型之一。
Q2:ProtNLM 預測某序列可能是細菌素,代表它能殺菌嗎?
不代表。預測功能是供研究者查證的線索,實際活性需以適當的體外抗菌試驗測量,還要檢查對人體細胞的影響與選擇性。
Q3:DeepMind 示範的抗菌胜肽已經證明能治療呼吸道感染嗎?
沒有。DeepMind 將候選描述為具有預測活性、值得研究的分子,並表示它仍在濕實驗驗證。公開示範沒有證明它能治療感染或具有臨床效益。
Q4:研究候選可以和抗生素一起使用嗎?
目前不能依計算預測推定併用效果。是否協同、互相拮抗或增加毒性,都必須透過實驗評估;研究候選也不應由一般人自行使用。
參考來源
- Tian P, Bileschi ML, Tsangalidou Z, Singh S, Colwell LJ. (2026). Google Antigravity: Accelerating Antimicrobial Peptide Search — Google DeepMind. *Google DeepMind
- Lei M, Jayaraman A, Van Deventer JA, Lee K. (2021). Engineering Selectively Targeting Antimicrobial Peptides. *Annual Review of Biomedical Engineering*, 23, 339–357


