很多人第一個會先想到,AI 能不能直接設計出有效抗體?但這裡要先問一個更前面的問題:模型交出的結果,究竟通過了哪一種驗證?AIntibody 盲測讓 29 個組織提交的 511 個抗體設計或預測結果,在共同的實驗框架下接受檢驗。結果顯示,既有抗體的親和力最佳化較能做出可測量的成果;候選排序與新序列設計的表現則不一致。這項研究的訊息,是模型在特定研發任務中可以協助提出候選,距離證明治療效果仍有多道實驗關卡。
一、AI 抗體設計實測要先看清楚問題:競賽檢驗了什麼?
AIntibody 檢驗三項不同工作:既有抗體親和力最佳化、在相近候選中排序,以及設計未納入原始選集的抗體序列。它以 SARS-CoV-2 刺突蛋白受體結合區為單一標的,並用實驗測量結合與可開發性,因此結論適用於這組任務與條件。
這不是讓模型自由回答「能不能做出新藥」的考試。研究者先設定資料與任務,再收取參與者的序列或排序結果,之後製造抗體並測量。這種前瞻、盲測設計,能減少只在既有資料集上回頭評分的偏差,也讓不同團隊的提交結果有共同的實驗尺標。研究的 511 個提交來自 29 個組織,並非 511 種已完成藥物,也不能把參賽組織數解讀成方法普遍有效的證明。
三種任務的輸入與難點並不相同
第一項是親和力成熟:研究提供既有抗體與第一階段篩選資料,參與團隊設計變體,希望讓抗體更緊密結合目標。第二項是候選排序:在 HCDR3(重鏈互補決定區 3,抗體辨識目標的重要區段)相近的候選群中,預測哪些結合較強。第三項則要求設計未出現在指定選集中的 CDR 序列,讓抗體能辨識同一標的。
三題要求的能力不同。最佳化有已知抗體和實驗資料當起點;排序必須辨別相似候選間細微差別,並勝過隨機挑選;新序列設計則要把已有規律延伸到未見過的序列。若只看「AI 抗體設計」這個總稱,容易忽略模型在哪一題成功、在哪一題遇到限制。
親和力與可開發性是兩個不同判準
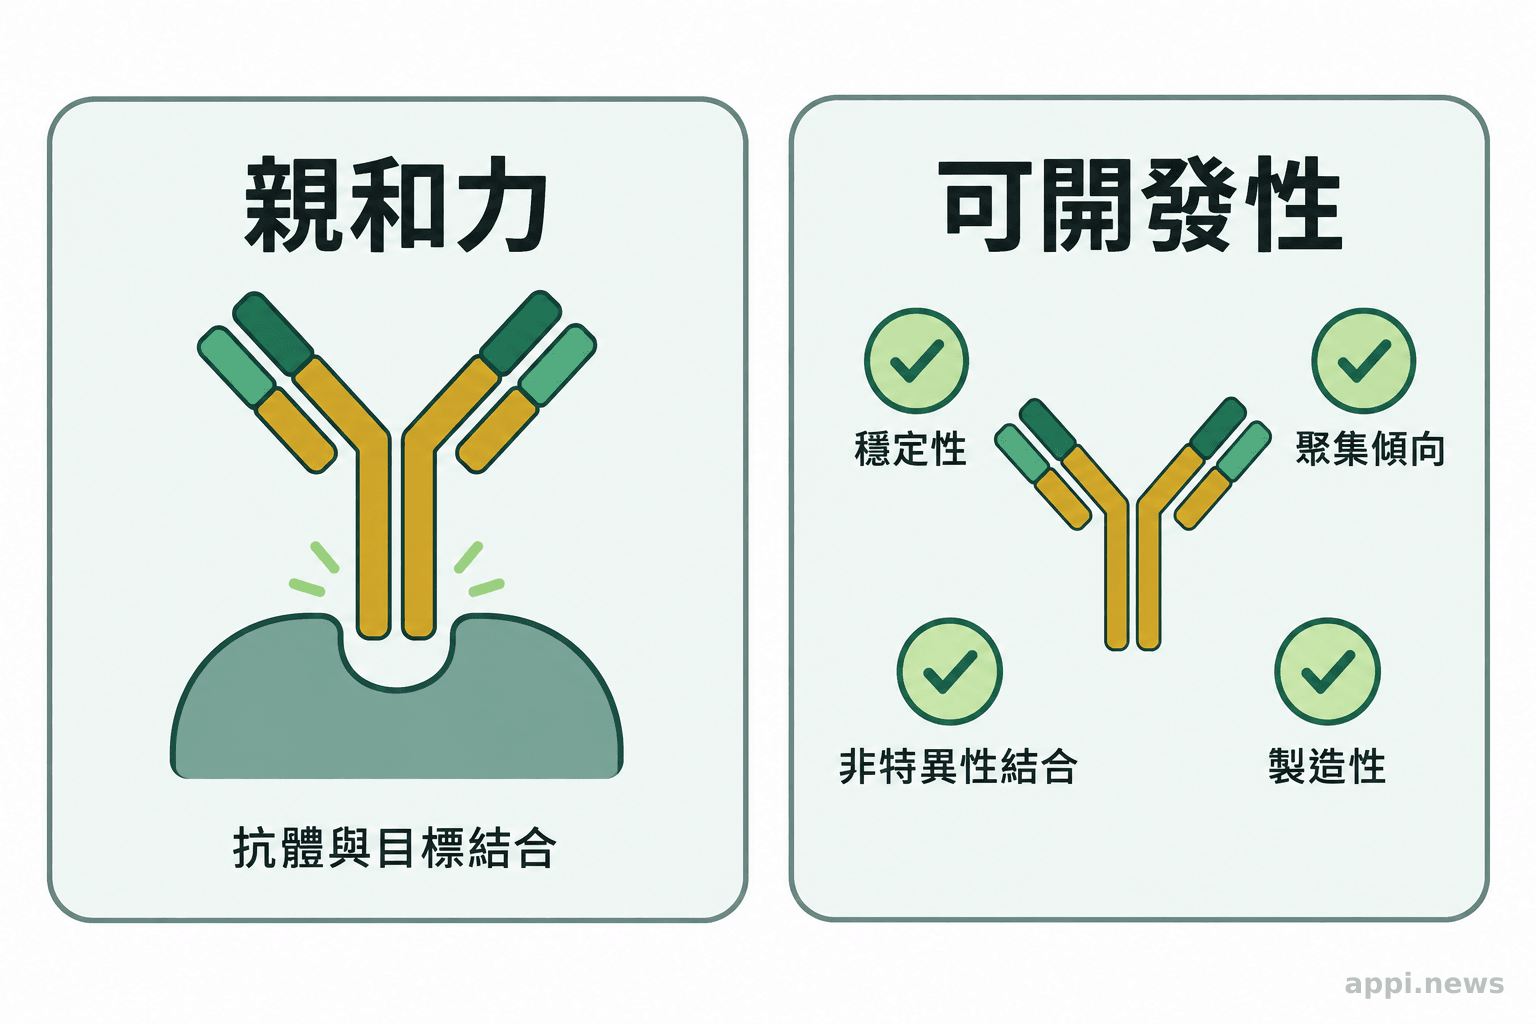
親和力(affinity)描述抗體與目標分子結合的強弱;研究以多種結合測試測量候選表現。可開發性(developability)則關注分子是否具備進一步藥物開發所需的性質,例如穩定性、聚集傾向、非特異性黏附或熱穩定性。兩者回答不同問題:前者偏向「能不能結合、結合多強」,後者關乎「這個分子是否具有可供後續開發的特性」。
研究使用表面電漿共振(SPR)及 KinExA 等方法測量結合,另以多項檢測組合評估可開發性。通過其中幾項檢驗,仍不等於完成細胞功能、動物研究、安全性或臨床效益驗證。對新藥研發而言,單一指標提高只是縮小候選範圍的線索,不能代替整體分子品質與作用效果的判讀。
二、為什麼既有抗體最佳化較容易看見成果?
既有抗體最佳化有明確的序列起點與相關篩選資料,模型能在已知的生物學脈絡中提出變體。這讓搜尋範圍比從零發明一個能結合目標的序列更受限制,但每個候選仍須實際製造與檢測。
研究摘要指出,親和力成熟任務中有數個團隊做出具可開發性、且結合力達高水準的抗體;這些成果並未穩定轉移到其他任務。這種差異值得留意:模型若能從已知序列出發調整局部區段,說明它可能有助於找出值得實驗測試的變體,卻不能據此推論它在候選排序或新序列生成也同樣可靠。
既有資料還提供了比較基準。研發團隊可以將模型提出的改造序列,與原始抗體或傳統篩選方法的結果並列,觀察結合變化及其他分子性質。如果只報告「親和力提升幾倍」,卻不交代起始抗體、測量方法、可開發性結果和重複實驗,就難以判斷這個提升對研發有什麼實際意義。
結合力提升仍須檢查穩定性與非預期結合
蛋白質序列的改變可能同時影響多個性質。某個改造讓抗體更容易與目標結合,也可能改變分子的溶解度、聚集風險或對其他分子的非預期結合。藥物開發還會評估表達、純化、保存穩定性及免疫原性等問題;其中免疫原性指治療性蛋白引發免疫反應的可能性,評估方式須依產品與風險個別規劃。FDA 對治療性蛋白產品提出以風險為基礎、依個案評估免疫反應的指引,足以說明單一結合數值無法涵蓋整體安全與開發問題。FDA 指引
「AI 可以在明確、具生物學根據的條件下最佳化抗體。」這是 AIntibody 研究摘要對其結果的界定;研究同時指出,成功沒有穩定轉移至不同任務。(Erasmus 等人,AIntibody 研究,2026)
因此,候選評估要看一組互補的測試,而不是用親和力分數代替「好抗體」的判斷。當分子進入更多研發階段,檢測問題也會從能否結合,逐步延伸至能否維持品質、是否具備預期功能,以及是否符合安全性要求。
三、候選排序與全新序列設計,難點在哪裡?
候選排序要能在相近序列中穩定找出較佳者,新序列設計則須預測未見序列能否結合並保有可開發性;AIntibody 的結果顯示這兩項仍有明顯落差。在候選排序任務中,除一個模型外,多數方法預測高親和力候選的表現不及隨機挑選。
排序任務與「找出一個看起來不錯的序列」不同。排序要先有一群候選,再判斷其中相對優劣。若每個候選的結合特性接近,模型必須捕捉微小但有意義的差異;實驗比較基準因此很重要。研究採用隨機挑選作為基準,讓人能看出模型是否真的提供額外資訊。若模型沒有勝過基準,研發團隊就需要調整使用方式,例如先用模型縮小候選,再透過實驗測序列,而不是把預測排名直接當成結論。
從資料外推到新序列,預測可能在哪裡失準?
新序列設計增加了資料外推的難度。模型可能學到訓練資料中常見的序列模式,卻未掌握該序列與目標結構如何互相作用;序列看似合理,也可能無法形成有效結合。即使測得結合,仍要確認分子的其他性質是否適合後續研究。AIntibody 的新序列設計結果呈現高度差異,部分提交可測得結合,另有不少未能勝過標準篩選流程。
要看懂這項結果,也要知道研究提供的是何種資料。AIntibody 的參與者取得了與特定 SARS-CoV-2 標的相關的篩選輸出,並在預設範圍內完成任務。這使比較有共同起點,卻也代表研究結果不等於模型面對陌生疾病標的、不同抗原結構或資料稀少情境時的表現。單一任務的最佳結果不能代表所有方法、所有標的或整個產業的平均能力。
四、模型輸出在新藥研發流程中可以走到哪一步?
模型輸出可作為候選生成、排序或實驗優先順序的依據,下一步仍是按研究問題進行製造與測試。預測分數不能當成實驗結果、藥效證明或人體療效,也不能取代臨床與監管審查。
較合適的做法,是先界定模型正在協助哪項工作,再安排相應測試。若目標是親和力成熟,就比較改造前後的結合及分子性質;若是候選排序,就檢查它是否優於隨機或既有篩選基準;若是設計新序列,就先確認序列能否表達、純化並結合目標,再評估特異性、可開發性及功能。實驗結果回到模型設計環節後,才能逐輪修正候選和資料使用方式。
這種人機分工也有助於控制成本與失敗風險。模型可以協助縮小候選池,把實驗資源集中在較值得測試的序列;實驗則負責檢查模型預測是否在生物材料與量測條件下成立。兩者形成迭代流程,才有機會讓每次實驗回答更具體的問題。若把分數直接當成候選已有效的證據,流程就會跳過最關鍵的驗證環節。
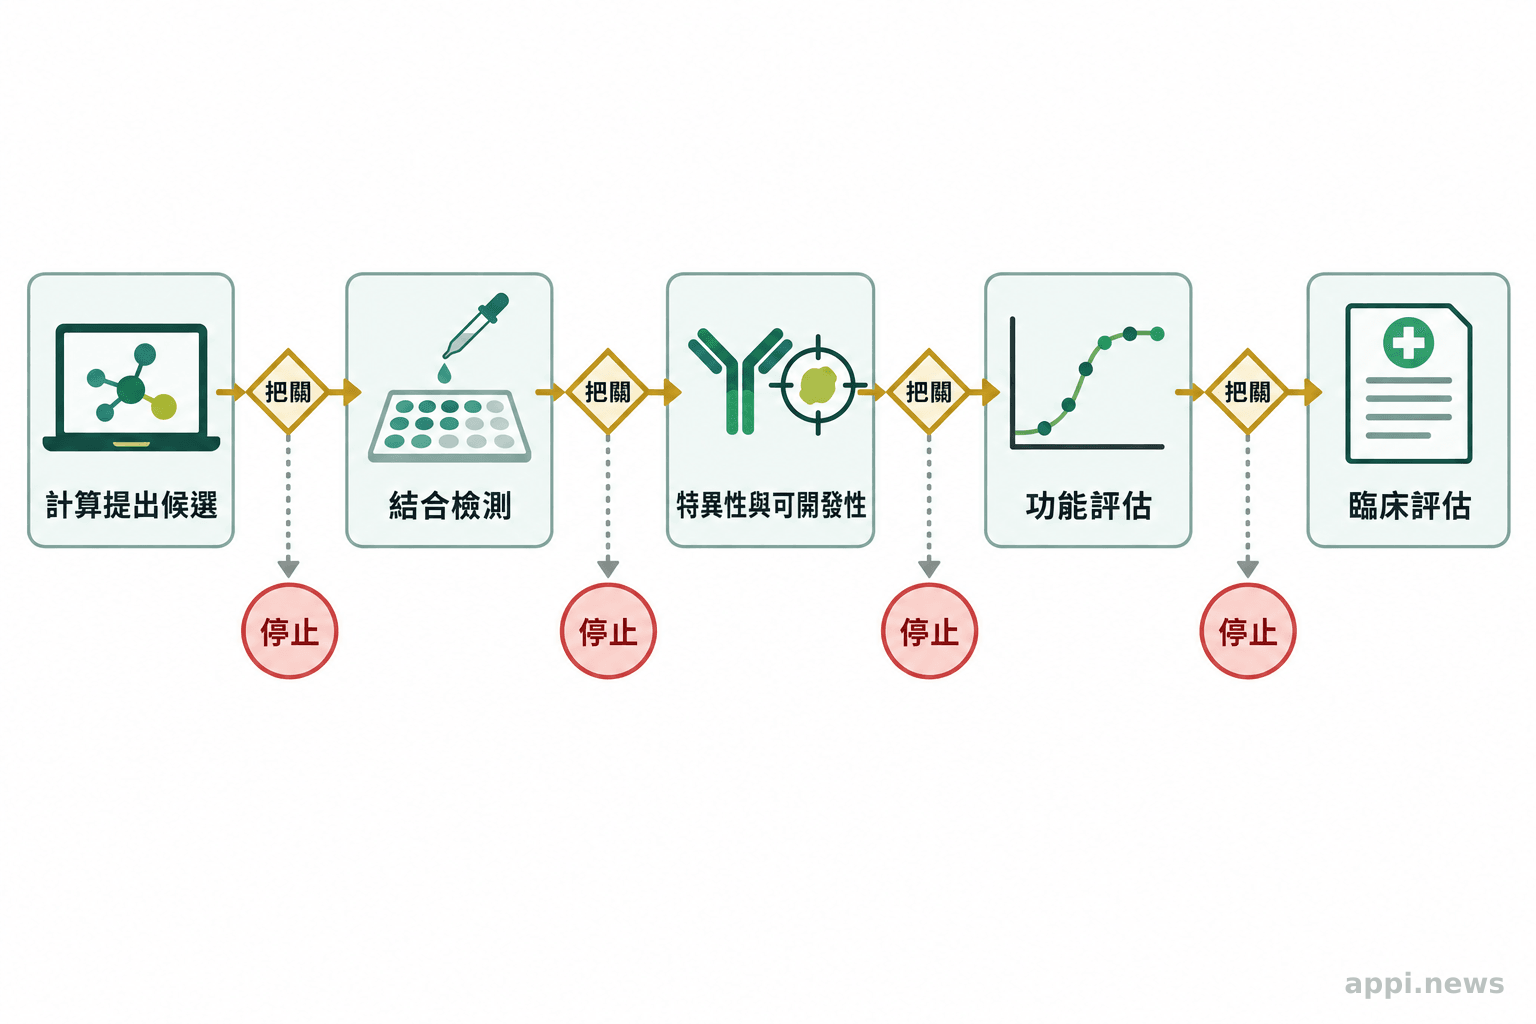
以多階段測試逐步把關
研究團隊或讀者評估 AI 抗體設計成果時,可以先核對四件事:
- 釐清任務:確認結果是既有抗體最佳化、候選排序,還是新序列設計。
- 核對比較方式:查看基準、分母、測量方法與對照組,勿只引用最佳單一數值。
- 檢查多項性質:分開看結合、特異性、穩定性、聚集與其他可開發性結果。
- 確認證據階段:辨認目前是體外結合測試、細胞或動物研究、臨床試驗,還是核准使用;不同階段不能互相替代。
這份清單也能幫助讀者理解新聞中的「AI 設計抗體」到底走到哪一步。若報導只提模型生成或親和力數值,卻沒有描述候選是否經過實驗、測了哪些面向、基準為何,就還無法推估它離治療用途有多遠。
五、這次盲測的結果可以推論到哪些範圍?
不能。這項盲測回答的是特定標的、輸入資料、任務設計與實驗方法下的表現,不能直接外推到其他疾病標的、候選藥物或臨床情境。參與者的方法與表現不一,跨任務泛化仍是研究指出的缺口。
研究團隊也在論文中交代其範圍:首輪只評估單一抗原,且由同一個聯盟組織競賽,盲測依賴主辦方誠信,未使用資訊學防護措施。這些安排不會抹去實驗測試的價值,但讀者應把它們納入解讀。研究選擇資料豐富、研究充分的 SARS-CoV-2 受體結合區作為標的,也不能代表較少研究、結構不同的目標會得到相同成績。
「除了單一模型外,從 HCDR3 群集中預測高親和力候選的結果不及隨機挑選。」這描述的是該研究特定排序任務及其比較基準,不能簡化成所有 AI 模型都無法排序抗體。— Erasmus 等人,AIntibody 研究摘要(2026)
跨標的與臨床用途仍須各自驗證
抗體藥物能否成為治療選項,還涉及功能、劑量、安全性、體內反應、患者族群與臨床效益等問題。結合測試只是早期分子特性的一部分。研究中所稱的「可開發」也依其檢測組合和判定門檻而定,不等於已完成臨床前或臨床開發,更不是主管機關核准。
這裡談的是抗體藥物研發流程,不提供個人用藥、停藥或療法選擇建議,也不能由模型設計結果推導抗體與現有藥物併用的安全性或交互作用。孕婦、兒童、慢性病患者及長期服藥者若有治療疑問,應由醫療專業人員依個別病況評估;研發中的候選抗體不應被視為可供自行使用的治療方案。
評估 AI 抗體設計成果時,先確認它做的是候選生成、排序還是既有抗體最佳化,再對照實驗條件、可開發性指標與適用標的,較能判斷結果在研發流程中的位置。AI 可以協助提出問題與縮小候選範圍,後續結論仍要由可重現的實驗逐步建立;有相關研究或流程設計議題,也歡迎交流討論。
- AIntibody 比較三種任務,既有抗體最佳化較有成果,候選排序與新序列設計仍有落差。
- 親和力、可開發性、功能與臨床效益是不同層次的判準。
- 模型結果適合作為候選或實驗規劃線索,不能代替實驗與臨床驗證。
抗體研發常見問題
不能。候選抗體仍須通過與研發階段相符的實驗及臨床評估,才能判斷其功能、安全性與療效。
常見問題
Q1:AI 設計的抗體通過結合測試,就代表有治療效果嗎?
不代表。結合測試顯示抗體能否在特定實驗條件下與目標結合,治療效果還需要功能、安全性、臨床等多階段證據。
Q2:親和力越高,候選抗體就越適合開發嗎?
不一定。親和力只描述結合強度,穩定性、聚集、特異性、免疫原性與其他開發條件仍要分別評估。
Q3:這次競賽能證明 AI 可直接設計出新藥嗎?
不能。它顯示部分方法在特定抗體任務中產生可測試的候選,但研究沒有證明候選具有臨床療效或已成為核准藥物。
Q4:抗體設計結果為什麼仍要交給實驗驗證?
序列與預測分數無法完整呈現蛋白質在實際製造、結合與功能測試中的表現。實驗能檢查預測是否成立,並揭露模型分數沒有涵蓋的分子性質。