GPT-6 Astra和Claude差在哪?長篇假訊息查證怎麼選
長篇假訊息會透過重複、誘導與假引用污染上下文。本文拆解GPT-6 Astra與Claude的證據差異,說明醫療衛教與台灣內容查證如何保留人工覆核。
長篇假訊息會透過重複、誘導與假引用污染上下文。本文拆解GPT-6 Astra與Claude的證據差異,說明醫療衛教與台灣內容查證如何保留人工覆核。
混合推論不等於資料零外傳。從 Perplexity、純雲端助理與 Ollama 本機部署的資料流、隱私、能力、網路、成本及臺灣個資責任,整理實際選擇方法。
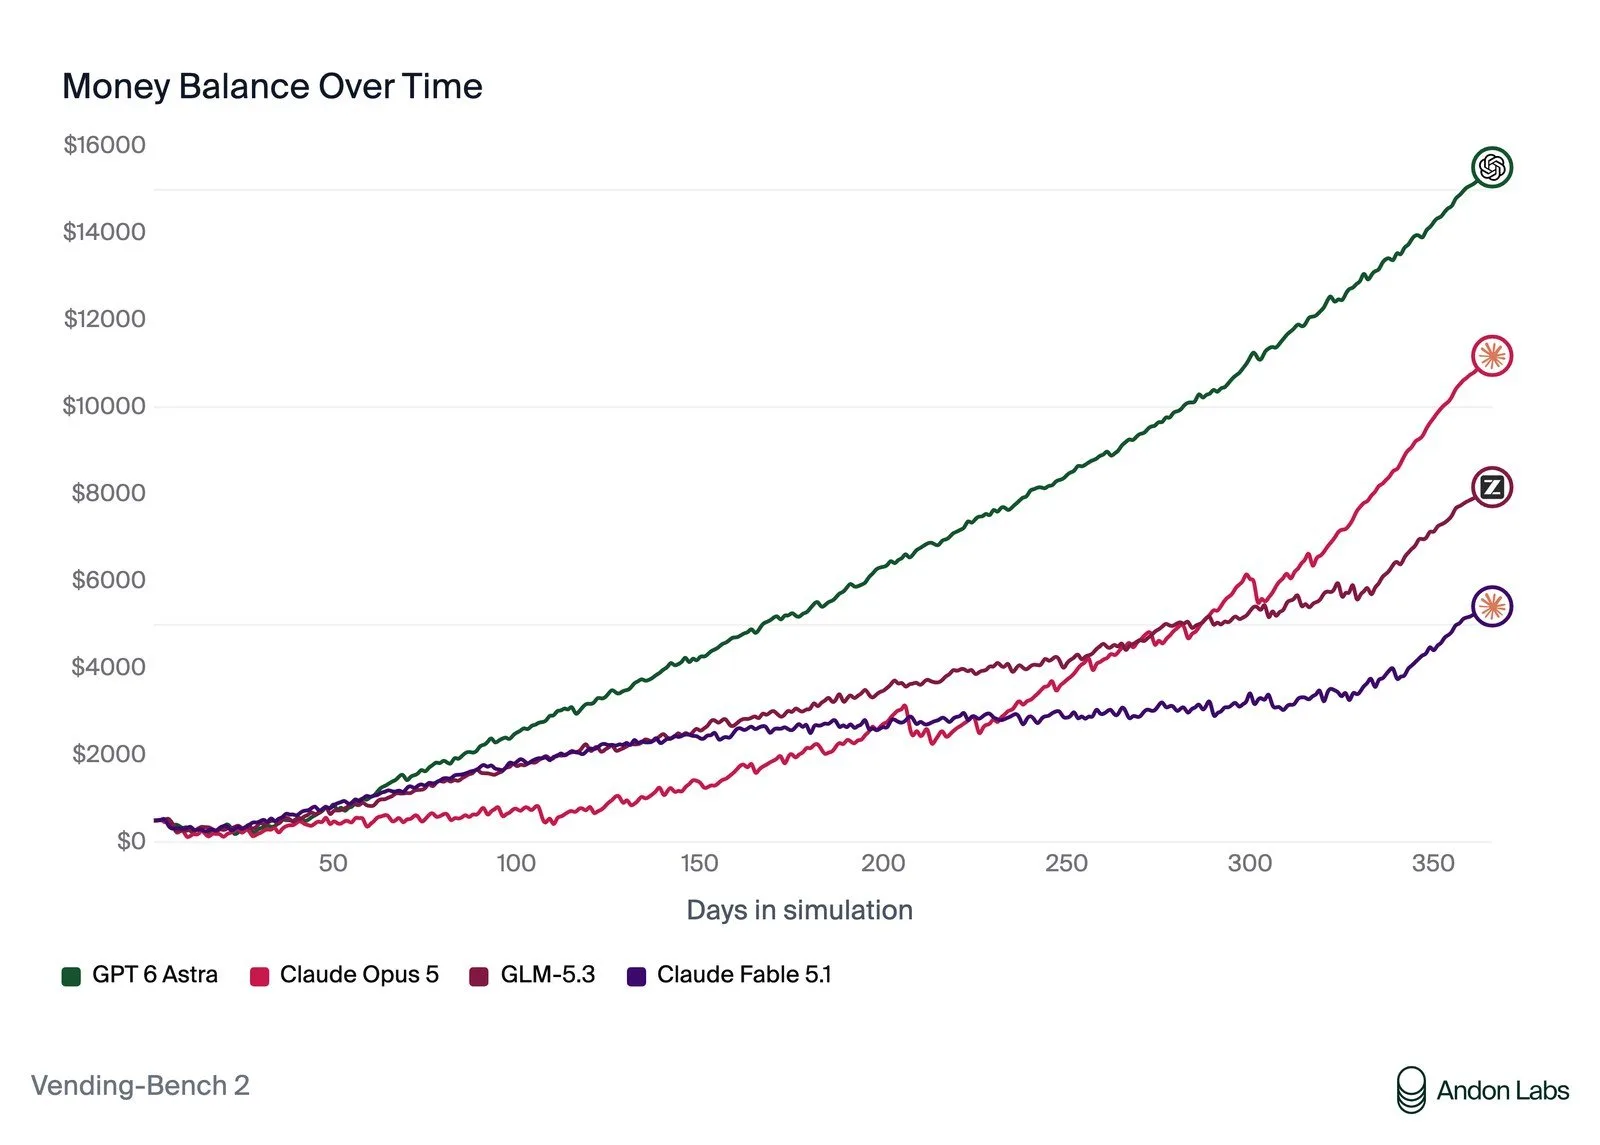
GPT-6 Astra在Vending-Bench 2的收入測試高於Claude Fable 5.1,也被放入無人機代理能力評估。本文拆解測試邊界、成本、可靠性與台灣導入限制。
Hugging Face以Gradio Workflow重建AUTOMATIC1111部分流程,本文比較三者的上手難度、節點彈性、部署方式與隱私取向,協助創作者選擇AI生圖工作流。
OpenAI公開抗菌分子探索案例,拆解ChatGPT與Codex在假設整理、資料處理、程式執行與結果驗證上的分工,說明研究者如何選擇起手工具。
Claude Fable 5.1與Fable 5版本比較,整理官方更新、語言自然度、文字厚度、推理表達與中文寫作差異,提供升級前的測試方法。
GPT-Live-1 以全雙工語音處理即時聽說與打斷,本文比較它和傳統 STT-LLM-TTS 架構的延遲、開發、成本與台灣應用條件。
DeepSeek V4.1 Flash 以低成本與高速度吸引開發者,但仍在內測;本文比較它與 GPT-6 Astra 的推理、多模態、價格、台灣可用性與本地部署門檻。
AI代理比較 MyAgent、Meta Muse 與 Gemini 的工作範圍、資料權限、台灣可用性與健康支付風險,整理企業、生活與桌面工作者的選擇方法。
ChatGPT Images 2.5 強化草圖、參考圖與多輪編修;Google Earth AI 生圖曾因爭議場景回撤。從生成能力、內容安全到台灣創作者工作流,整理公開發布前的判斷方法。
從量子位元量測、Lean 形式化證明、長流程規劃、驗證可靠性與總成本,拆解 Codex 與 Claude Code 的科研AI能力與適用任務。
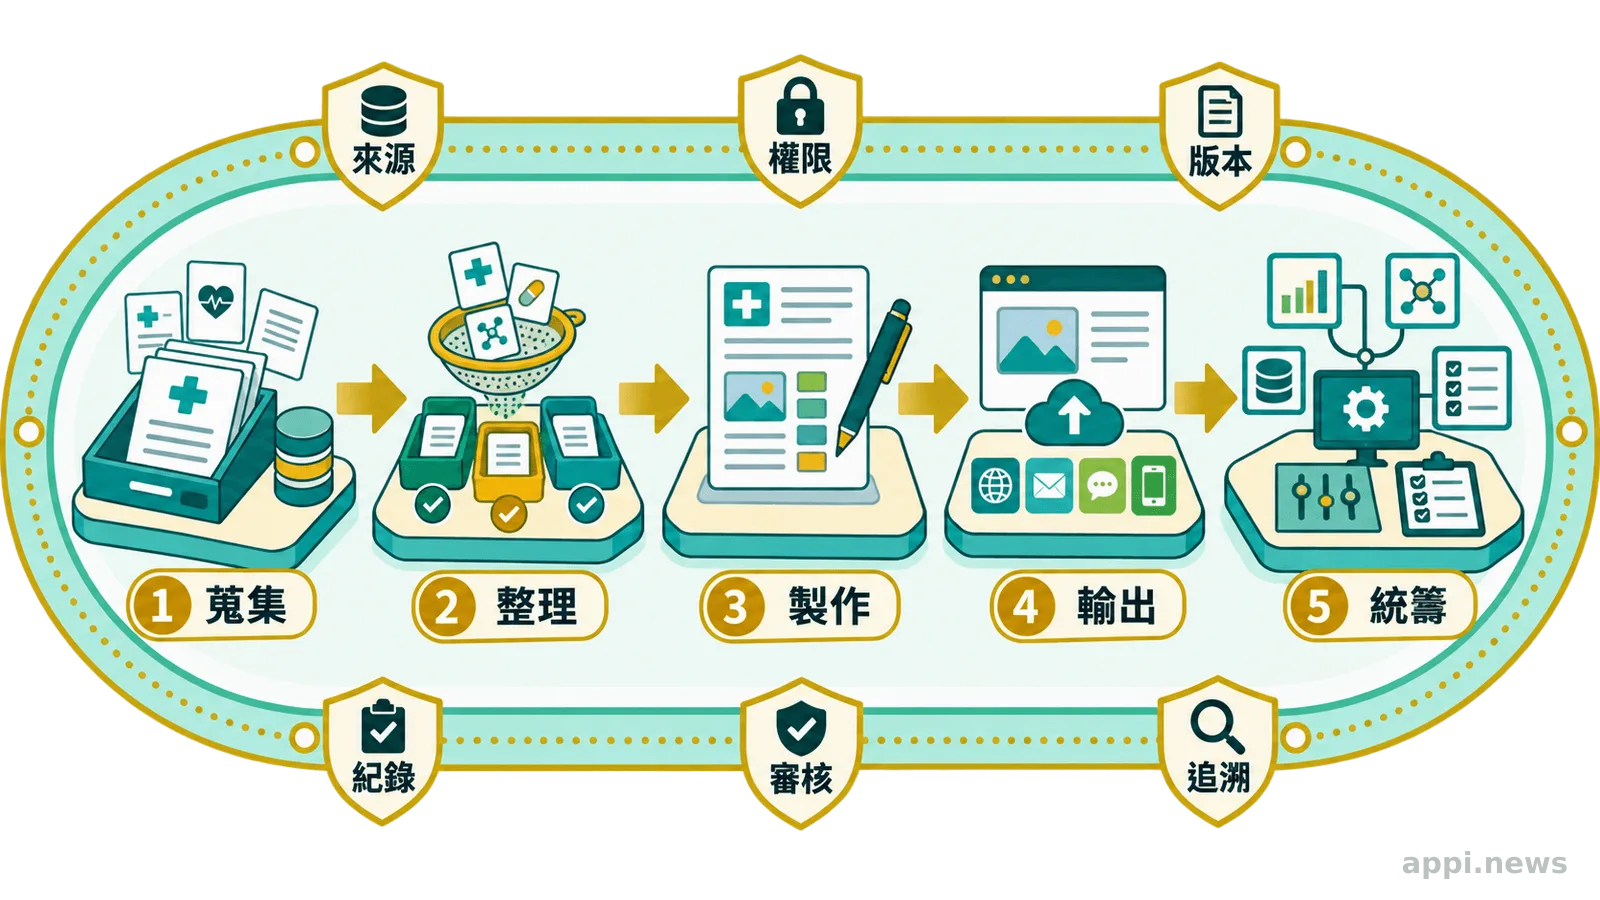
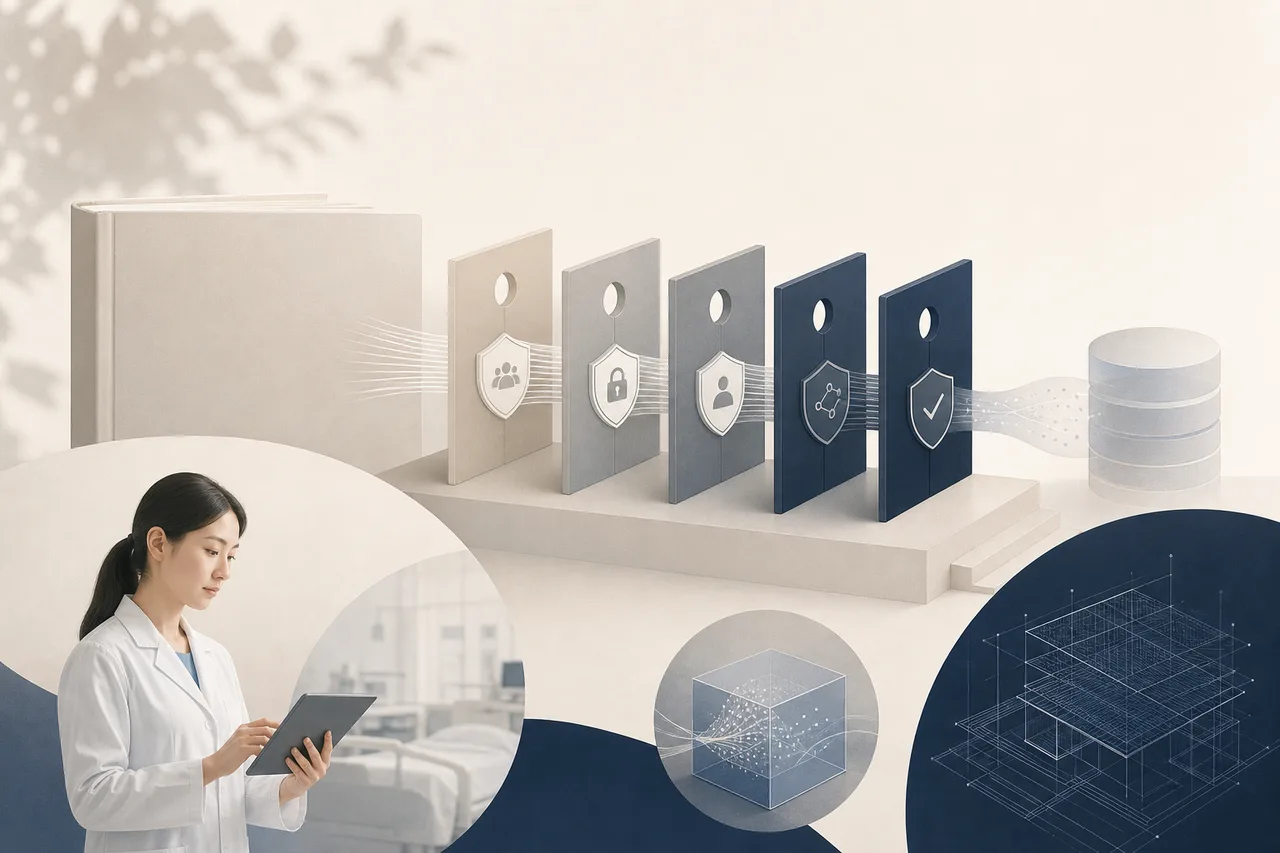
醫療 AI Agent 不宜只靠一個模型與長提示詞。本文拆解蒐集、整理、製作、輸出、統籌五個引擎,以及來源、權限、版本、紀錄、審核與追溯護欄。
Google Assistant 已從 2026 年 9 月起分批退出 Android 手機,Gemini 接手手機與部分配對裝置。本文整理手機、Wear OS、Android Auto、Google Home 音箱與車內 Google built-in 的影響、指令差異及設定做法。
比較雲端生成服務與 ComfyUI 本機工作流的品質、總成本、修改彈性、商用授權與健康素材隱私,協助台灣創作者依專案限制選擇。
Meta AI 推出 Muse Spark 1.3。本文從程式任務成功率、總成本、部署方式與醫療資料隱私,比較 GPT-5.6 Sol、Gemini 3.8 Flash,提供健康科技團隊選型方法。
兩項美國實驗顯示,約七分鐘 Gemini 對話在降低特定陰謀信念評分上優於靜態事實單張。本文拆解研究限制、錯誤與隱私風險,以及台灣衛教聊天助理的導入判準。
比較 GPT-6 Astra 與 Claude 的去 AI 味提示方法,從自然度、指令穩定性、事實準確度與繁體中文適用性,整理台灣健康內容團隊可執行的測試框架。
微軟推出MAI-Image-2.6-Flash,主打更快、更省。從速度、品質、有效成本、工作流與健康內容治理,拆解團隊導入前該怎麼測。
比較雲端 EHR 連接器、RAG 知識庫與本機模型的準確性、資料隱私、維護成本及臺灣法規要求,提供醫療機構可執行的架構選擇方法。
比較 GPT-6 Astra、Claude Fable 5.1 與 Gemini 3.8 Flash 的醫療文件能力、長上下文、幻覺、價格及高風險限制,提供臺灣醫療團隊可執行的選型方法。
從2026年9月3日ChatGPT與Codex大規模錯誤事件出發,整理雲端AI中斷常見原因、OpenAI公開的狀態頁與雲端SLA解讀,並提供個人保存資料、準備替代工具,以及企業建立切換層、人工流程與復原演練的做法。
OpenAI 官方資料顯示,GPT-6 Astra 在 ARC-AGI-3 拿到 99.9%,但這是特定互動測試的綜合分數。本文拆解關卡完成率、相對人類操作效率與評測落差,說明高分能代表的範圍,以及企業判斷實際能力時應補上的真實任務驗收。
Google 發表 Gemini 3.8 Flash,主打長時間軟體工程、自主代理與多步驟推理。本文從 PTT Stock 討論切入,整理它和 3.7 Flash 的差異、官方評測、價格與一般用戶的使用方式。
孩子開始用生成式 AI,家長該禁止還是放手?從共同提問、查證、實作到隱私界線,用 5 個步驟培養自學力、生活經驗、品味與親子連結。
AI 模型量化能縮小模型、降低記憶體需求,部分硬體也能因此加快推論;代價是精度與相容性要重新驗證,INT8、INT4不能直接視為通用加速按鈕。
庫克於2026年9月1日轉任蘋果執行董事長,由硬體工程主管約翰・特納斯接任執行長。本文整理交棒時程、特納斯資歷、庫克任內營收與服務業務變化,以及市場對蘋果產品與AI策略的觀察重點。
比較 ChatGPT Plus、Google AI Pro、Claude Pro 在台灣使用時的月費、任務工具、家庭共享、學生資格、用量上限與地區限制,並用三種常見情境整理訂閱前的查核順序。
Nano Banana 怎麼用?本文整理 Gemini 內生圖、上傳照片編修、多圖合成與局部修改的操作步驟,拆解主體、構圖、文字、保留範圍等提示詞寫法,並查核方案、地區、年齡、解析度與用量限制。
從 vibe coding 的建站與部署流程,分析 Cloudflare 可能進入 AI 建議清單的原因,以共同維度比較 Vercel、Netlify 與 Firebase,並整理可驗證的實作路徑。
AI模型選型要先從任務與資料開始,再用真實案例比較回答品質、延遲、每次呼叫成本、資料處理方式與版本穩定性。本文整理模型家族怎麼分工、台灣人工智慧基本法與風險分類框架走到哪,以及一般人與企業導入前的檢查清單。
Google Pixel 11 系列在台上市,主打 Tensor G6 晶片、Gemini 代理式 AI 與長變焦相機,全系列 7 年更新。整理四款機型的台灣售價、規格賣點、台版可刷日本西瓜卡(Suica)的實際設定門檻,以及 256GB 起跳但傳出記憶體縮水的買前提醒。
手機12G與16G RAM差異在哪、12G夠用嗎?用PTT MobileComm網友實測搭配Android與Apple官方記憶體管理文件,整理背景App保留、裝置端AI與長期使用的差異,判斷該不該多花錢升16G。
PTT Lifeismoney 熱議的 Gemini Pro 學生一年免費方案,台灣 2025 年活動已截止;本文對照 Google 官方公告與現行 AI Plus 方案,整理教育信箱、個人 Google 帳戶、付款方式、地區限制及常見卡關點。
醫院病歷受個資法保護、跨院共享困難,合成資料讓 AI 可以拿「統計特性像真的」但沒有真人紀錄的假資料練功。但假資料一路餵下去也有代價,叫模型崩潰。
OpenAI於2026年7月30日大砍GPT-5.6系列API價格因應中國Kimi K3、MiniMax M3等平價開源模型競爭,Luna降幅達八成、Terra降二成,整理官方降價細節、中國陣營定價策略,以及對台灣企業導入AI成本與新創競爭環境的影響。
祖克柏發表6500字宣言主張AI應開源、反對權力集中在少數企業或政府,Meta同步推出開源模型Muse Glimmer與進階模型Muse Spark 1.2,AI安全機構隨即質疑此舉風險。
深偽用AI合成的臉與聲音幾可亂真,詐騙集團已經拿它假冒家人來電行騙。台灣法規開始要求廣告與新聞標示AI生成內容,接到聲音相似的求助電話,換個熟悉管道回撥查證,才擋得住這類騙局。
蘋果2026年7月拿到中國核准上線Apple Intelligence,條件是整合阿里巴巴通義千問與百度AI模型,這篇整理核准經過、監理背景與兩家業者的功能分工。
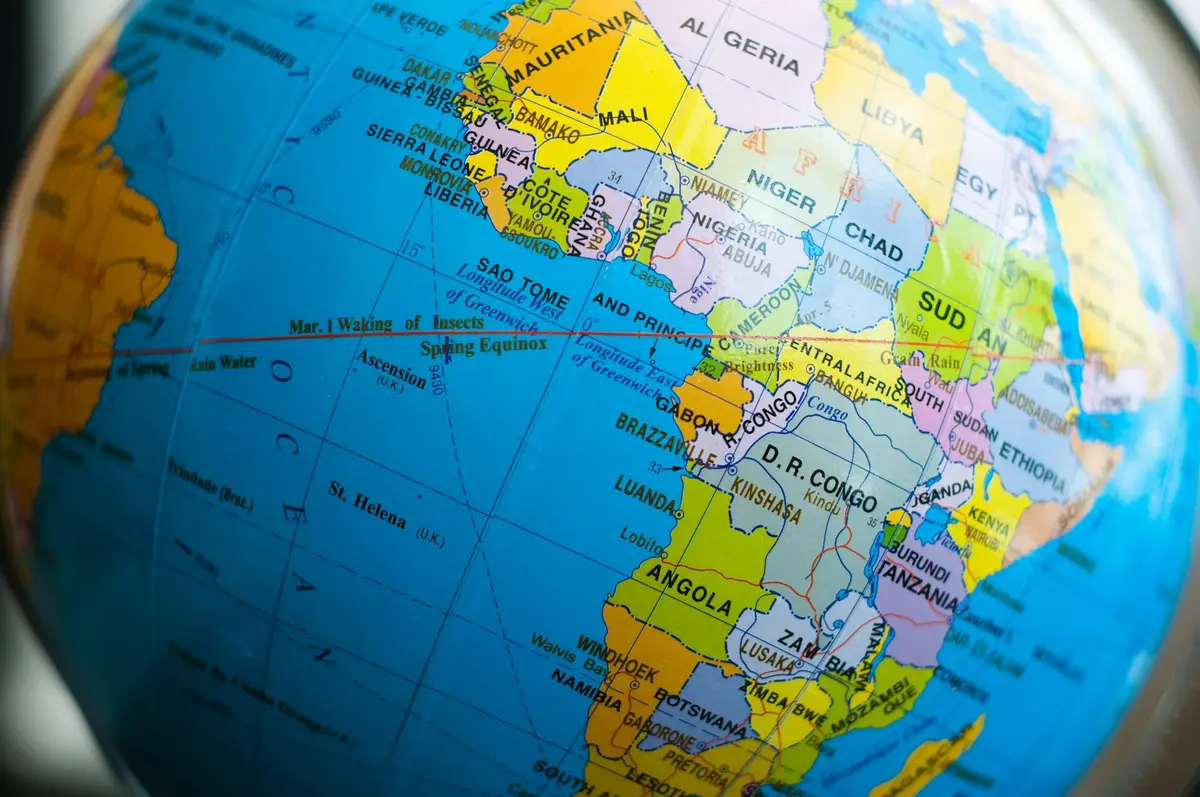
美國國務院在AIDS 2026大會簡報使用AI生成的非洲地圖,奈及利亞被畫進撒哈拉沙漠、莫三比克移到東非之角,路透社發現圖片含OpenAI浮水印。國務院致歉稱是會前倉促修改投影片所致,專家質疑反映美國對非洲夥伴的輕忽。
UpDoc 靠「LLM 只負責蒐集資料、醫師預設規則才做決策」的架構,拿到美國首張病人對話 LLM 醫材許可證。這套「守門不決策」的設計邏輯,正是台灣評估 AI 診斷工具給付時最該借鏡的先例。
中國網信辦7月29日公布《反網路暴力法》草案,首度明文納管AI生成的深偽騷擾內容,要求平台先驗身分、建黑名單,最重可罰人民幣1000萬元,公眾意見期至8月28日。
只要讓 AI 相信自己在玩遊戲,它就會套用遊戲邏輯、丟掉現實世界的安全邏輯。六款 AI 瀏覽器沒有一個拒絕。這不是一次可以靠改提示詞補掉的漏洞。
為什麼是 42 個州同時出手,而且挑在 IPO 遞件後?因為上市那一刻,法規風險第一次要被定價。
GPT-5 Pro 幫免疫學家解開卡三年的 T 細胞謎題,還預測了沒公開過的實驗結果。但把這件事讀成『AI 會做科學了』,就解錯題了。
AI 真的自己做出化學發現了嗎?讀準一點:GPT-5.4 提假設、自動化實驗室跑一萬筆反應、人工逐筆驗證,三者缺一都不成。被解掉的是『沒人跑得起一萬次』的通量問題,不是智力問題。台灣要接住這波,缺的不是模型,是實驗室與資料。
AI 連自家出的生命科學考卷都只過三成,這件事該怎麼讀?分數是一回事,出題兼改考卷兼頒獎的是同一個人,又是另一回事。
PCWorld 記者拿 Claude Pro 試用 Claude Design,25 分鐘做出三個變體就燒掉 80% 週額度。真正致命的不是貴,是不可預期。六月改版修的正是這一格。
AI 拿奧數金牌很亮眼,但那是自然語言、靠人工評審判對錯。用 Lean 4 逐行驗證的證明才解掉了難題:不用人幫忙也知道它是對的。這才是 AI 可信度第一次有的工程解法。
200 萬 token 是量產最長脈絡,但廣告脈絡不等於可用脈絡。長脈絡真正划算的只有幾類場景,其餘知識庫問答用 RAG 更省更準。這篇給一個先分清楚任務類型的選型判準。
200 這個破紀錄的數字不是新聞重點,它為什麼會破紀錄才是。找漏洞的成本被 AI 拉崩,企業該改的不是修補手速,是那套假設漏洞會慢慢來的排程。
上海 MiniMax 6/1 推出開源權重的 M3,前沿級 coding、百萬 token 脈絡、原生多模態一次到齊,定價只有西方旗艦零頭。但對台灣團隊真正的訊號不是又一個跑分新王,而是自架可行性與選型的成本結構被重寫。
多數人看到的是估值排名。我看到的是:前沿模型公司正在變成算力與供應鏈的金融槓桿體,估值撐起的其實是一張一張算力預購合約。台廠該讀的是配額流向,不是誰比較貴。
AI 助理原本值得信,不是因為它聰明,是因為機制上沒有騙你的理由。廣告生意種下的,正好是那個相反的理由。要盯的是誘因,不是那格 banner。
為什麼一家前沿模型公司要花 1.5 億去教非營利組織用 AI?把它讀成純慈善會漏掉一半:同一筆錢也在把 Claude 鋪進 400 家組織的日常,順便養一批以 Claude 為工具母語的早期職涯人才。
為什麼投資人搶的不是下一個大模型,而是一個租 GPU、代管開源模型的平台?因為開源模型正在把模型本身變成商品,價值移到了『誰能把它跑起來』那一層。
WWDC 2026 上 Apple 把新 Siri 建在 Google Gemini 之上,還因法規在歐盟、中國缺席。該讀的不是功能多炫,而是單一供應商依賴,加上落地範圍被治理與合規綁住。
為什麼一個還沒公開發布的模型,賭盤能開到六十幾萬美元?因為不確定性被商品化了。但賠率不是路線圖,跟著它調整選型是把工程問題交給賭客投票。
Anthropic 6/17 開首爾辦公室,一口氣拿下 NAVER、三星 SDS、LG CNS、Nexon、Hanwha。拿下一個國家的企業市場靠的不是模型強,而是在地辦公室、資料主權、國家安全合作、in-region data 整套打包。台廠導入前沿 AI,in-region 資料控管會是談判與選型的關鍵籌碼。
把模型關掉的不是 Anthropic 的商業決定,是它頭上的政府;理由跟你買它做什麼、付多少、合約怎麼簽都無關。這才是單一供應商風險真正抖的地方。
以前一家公司配一顆模型:Google 是 Gemini、OpenAI 是 GPT。現在三大雲全走 multi-model,模型正在商品化;企業未來買的不是模型,而是切換模型的能力。
OpenAI 說新模型的健康答案贏過醫師,但分數全在它自家內部跑、未公開外審。真正的重點不是它贏了幾項,是每週 2.3 億人已在用 ChatGPT 問健康。AI 取代的不是醫師,而是 Google 搜尋。
為什麼 Amazon 和 AMD 投的不是下一個 ChatGPT?答案可能是:聊天模型正在商品化,而世界模型要真實世界資料、感測器、機器人、模擬環境,護城河更深。
大部分人看到 74 億美元。我看到的是投資人結構變了:騰訊、寧德時代進場,代表 AI 不再只是網路產業,而開始變成能源、製造、平台共同投資的基礎設施。
NVIDIA 把安全、網路、隱私護欄做成 runtime(OpenShell),配上為長任務調過的 Nemotron 3 Ultra。真正要看的是治理被往工具層下沉,不是模型跑分。
OpenAI 拿約 130 萬則真實對話重放、餵給待上線的新模型測試,比合成測題更早抓到行為漂移。上線前驗收該從跑分搬回真實情境,企業導入 AI 也一樣。
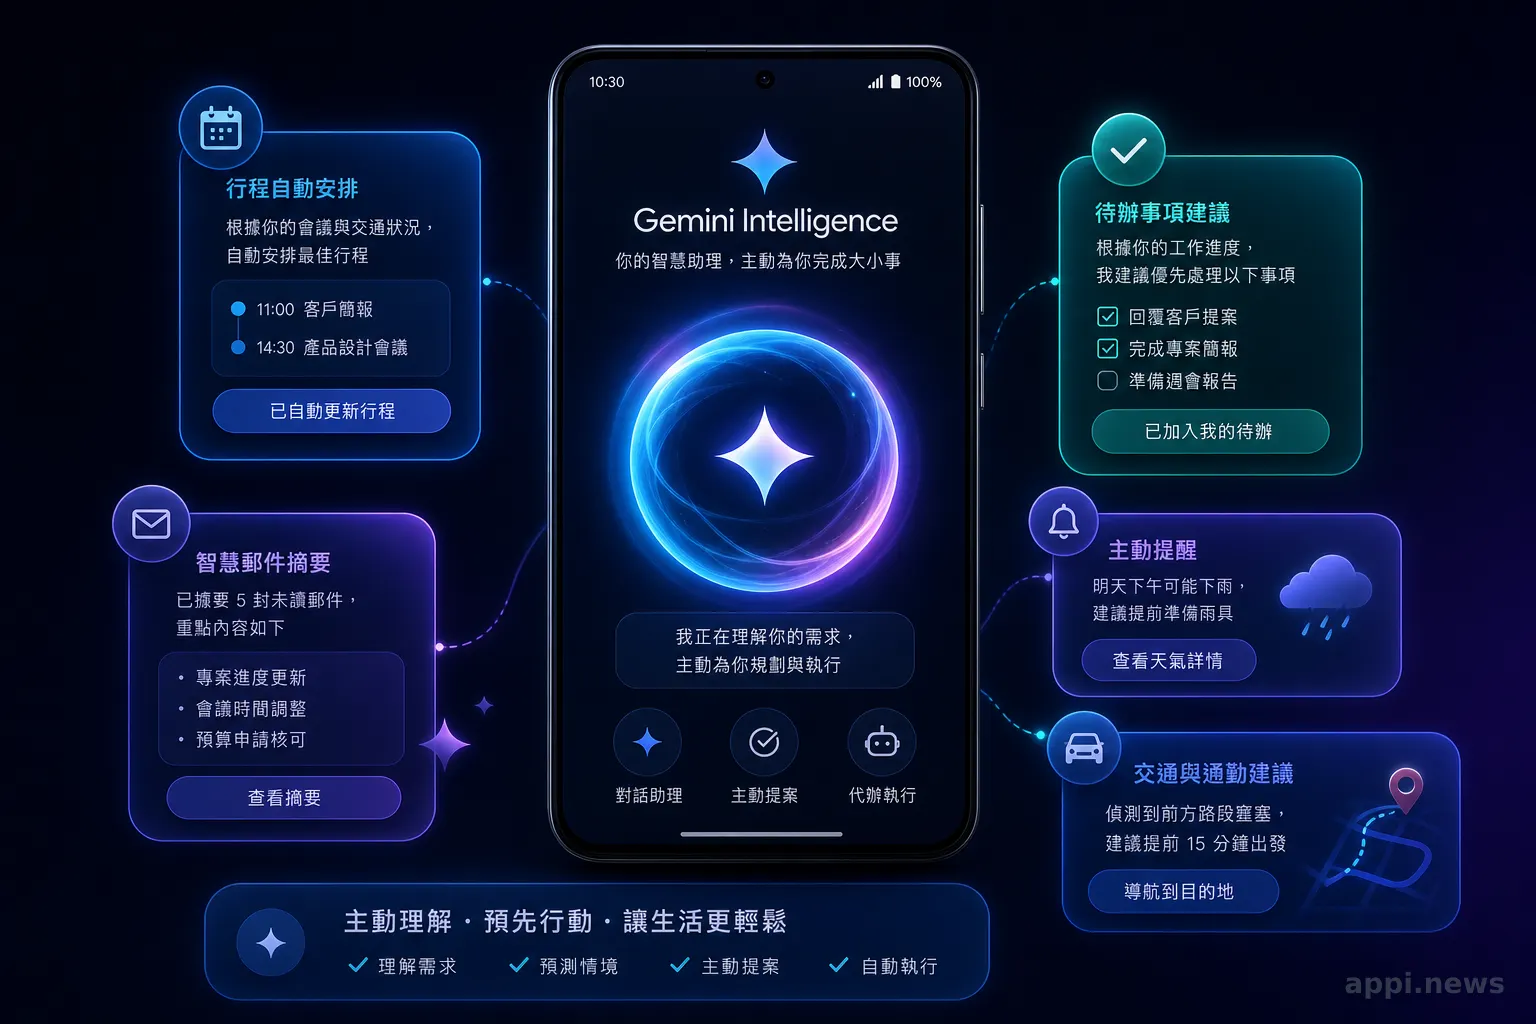
Android 17 把 Gemini AI 整合進系統層級,推出 Gemini Intelligence 功能套件。本文拆解五項核心能力、硬體門檻,以及裝置端 AI 推論對使用者隱私與實際使用的意義。
LogRocket 六月榜單上,開源的 OpenCode 把 Cursor 擠下第一。這不是又一個更花俏的工具,而是開發者在用腳投票:要的是不被單一 IDE 綁死的可組合工作流。這篇用台灣小團隊的選型情境,拆三條路線的設計前提。
Anthropic 6 月 9 日把 Fable 5 推上「Mythos 級」,一個比 Opus 高一階的正式產品層。真正該看的不是 80.3 這種跑分,而是它在長任務、agentic coding 上的領先會隨任務難度拉開。這篇拆解這個分層對開發者選型的實際意義。
從衛福部《醫療機構應用生成式人工智慧指引》到工程設計,拆解合規守門引擎的五道關卡、去識別化管線、Null Provider 可測性設計與守門服務的核心原則。
收到健檢報告看到紅字,先別慌。本文詳解 GOT/GPT、白血球、尿酸、TSH 四項常見異常數值的意義,教你區分需要就醫與可觀察追蹤的情境,避免過度焦慮也避免輕忽。
LLM 進入醫療場景的想像令人著迷,但真正的問題不在於模型夠不夠強,而在於有沒有解對題。本文從問題定義、根因分析到落地設計,系統拆解 LLM 在醫療場景的可能與限制。
「龍蝦」(Claw)是一類讓人與 LLM 對話的客戶端工具,不是比喻,是真實的工具名稱。本文拆解 Claw 工具的命名由來、比較主流開源選項,並分析在數位健康場景中,這類工具真正能幫你解決哪些問題。
LLM 不持有商業誘因,不會因為你不懂而選擇性隱瞞或導向對它有利的方向。本文從誘因結構出發,拆解這個信任邏輯的成立條件與邊界,以及在健康資訊場景中,如何真正受益於這個特性。
零點擊搜尋時代來臨,GEO(生成式引擎優化)與 AEO(回答引擎優化)是台中企業 2026 必懂搜尋新規則。了解 SEO 如何升級,讓內容被 AI 引用、建立品牌信任。
生成式 AI 不只是把資料丟給使用者,而是把答案組裝成符合心理期待的敘事。這讓診間要面對的,已不只是錯誤資訊,而是一個被迎合過的判斷。本文從問題定義、根因分析到流程應對,系統性拆解這個比誤診更棘手的挑戰。
Claude Mythos 帶來強大 agentic 能力,但 ISO 27001、CNS 27001 與 ISMS 框架能應對 AI exploit 時代的安全挑戰嗎?從問題定義出發,拆解框架的邊界與真正有效的防護思路。
一場對話揭開AI短影音創業的真實運作:為何題材遠比品質重要、演算法如何分波測試、內容矩陣的風險與報酬,以及廣告之外的多元變現結構。
黑嘉嘉圍棋如何從一個台灣直播平台,演變成讓百年日本棋院點頭合作的AI教育品牌?本文拆解圍棋人科技的轉型邏輯、AI對手系統的設計核心,以及用「職業棋士身份」而非「商業談判」打開日本市場的關鍵決策。
幼兒教育導入 AI 的關鍵不在於能不能用,而在於放在哪個環節。AI 適合輔助大人備課與設計活動,不適合取代親子互動與教師引導。本文拆解幼兒發展核心,說明 AI 工具的正確定位與評估方法。
元智大學宣布115學年起將AI程式語言列為全校大一必修課,畢業前並須再修3學分AI數位應用,成為全台第一所以制度化方式全面導入AI素養的大學。這個決定挑戰了高教長期把AI能力當課外選修的慣性,也直接衝擊台灣勞動力的AI準備程度。
健保署與Google Cloud 2024年6月合作啟動「AI-on-DM」計畫,以23年、2,300萬筆健保資料訓練糖尿病AI模型,將風險評估從20分鐘壓縮至25秒,是台灣首個政府主導的全國性預防性AI醫療整合。
104人力銀行2025年調查顯示,45%在職者曾安靜離職,38%認為主管沒有發現。同時超過五成員工已使用生成式AI工具,兩種截然不同的職場態度在同一企業內共存,考驗HR的判斷力。