
TriNetX 於 2026 年 6 月 23 日宣布,旗下 LIVE 醫療資料網絡涵蓋超過 3 億名患者、240 多個醫療組織與 13,000 多個據點。這是企業公布的網絡規模,能說明資料來源擴大,卻不能單靠總人數判定研究可靠,也不能證明醫療 AI 已適合用在診斷或治療。判讀真實世界證據時,仍要追問研究納入哪些人、資料記錄了什麼,以及分析如何回答特定問題。
TriNetX 擴大患者資料網絡,公告公布哪些規模?
TriNetX 的公告指出,LIVE 網絡已涵蓋超過 3 億名患者,資料來自全球 240 多個醫療組織、13,000 多個據點。公司並表示,網絡涵蓋美國、歐洲、中東與非洲、拉丁美洲及亞太地區,資料以院所電子病歷為來源。
截至 2026 年 6 月 23 日,TriNetX 表示其 LIVE 網絡超過 3 億名患者,分布於 240 多個醫療組織與 13,000 多個據點;這些是企業公布的網絡總量,不是任何單一研究的樣本數。
公告列出研究招募、比較療效與上市後安全監測等用途。實際研究能回答什麼,仍要看個別計畫如何界定問題及抽取資料。公司稱資料由合作機構電子病歷持續更新;這項說明仍應與個別研究文件分開判讀。
新聞稿所列患者總數與單一研究的分析人數不同。研究會依診斷、治療、地區、期間與資料完整度篩選個案。閱讀時應找實際樣本數與納入條件。想進一步了解醫療 AI 臨床效能與上市後監測,還要看模型在明確使用情境中的驗證結果。
TriNetX 資深全球醫療合作副總裁 Steve Lethbridge 在公告中將患者數稱為網絡發展的一個里程碑;研究能否支持醫療決策,仍須回到個別研究的方法與結果。
「三億是個里程碑,不是終點。」(Steve Lethbridge,TriNetX 資深全球醫療合作副總裁(依英文原文翻譯))
真實世界數據如何形成真實世界證據?
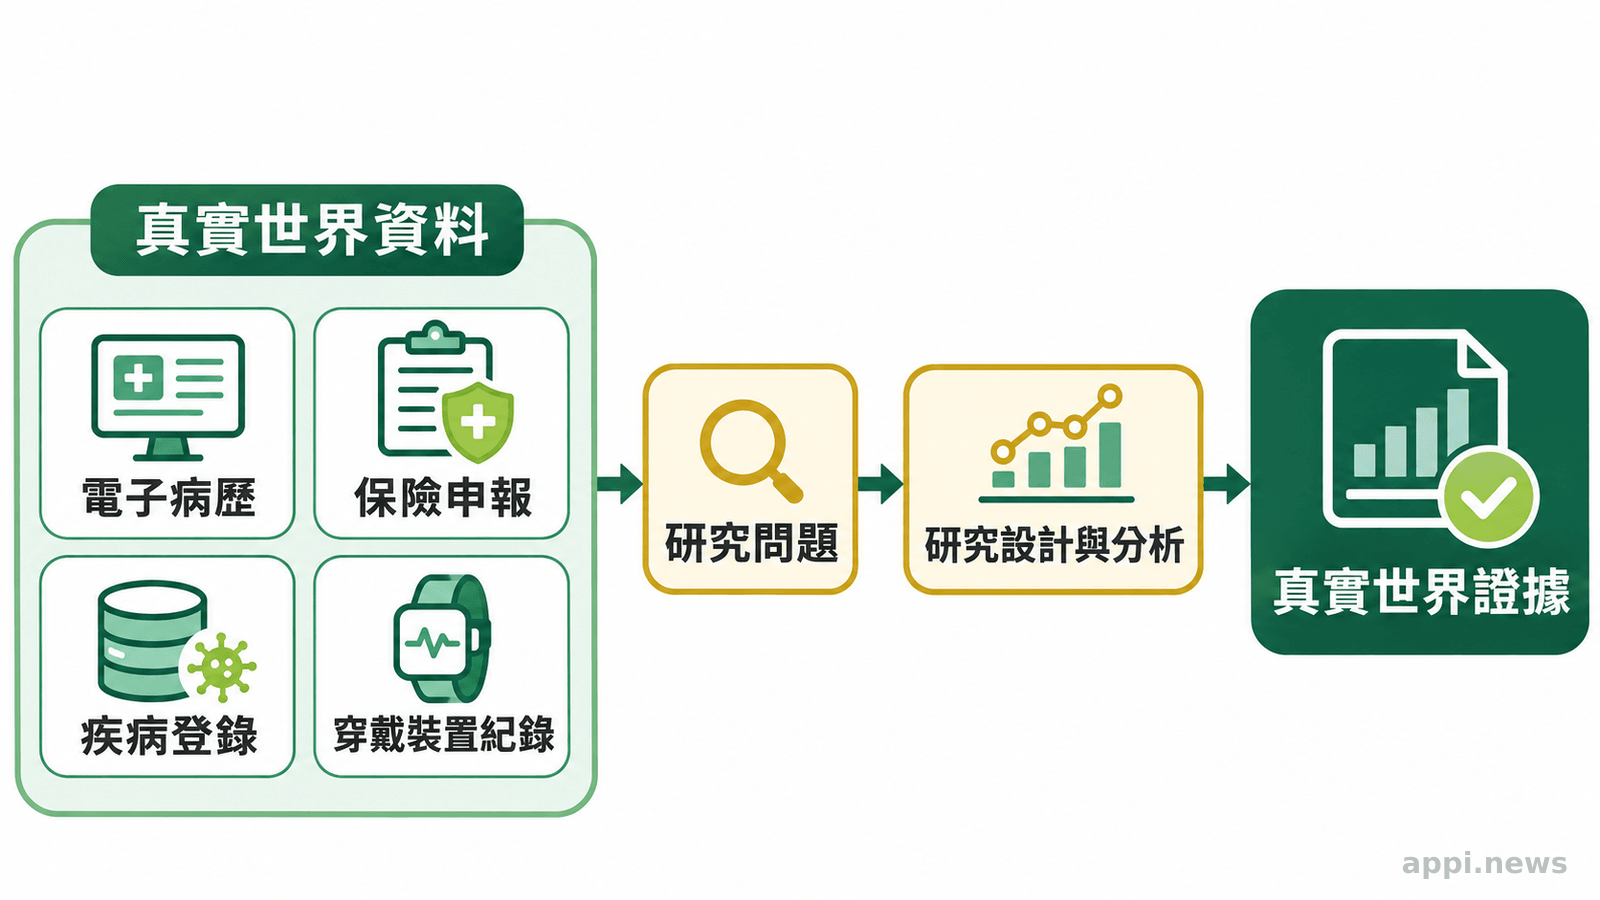
真實世界數據是例行照護或其他日常情境產生的資料;真實世界證據則是依特定研究問題設計分析後,從這些資料形成的結果。資料量大,並不會自動讓分析變成可靠證據。
電子病歷、保險申報、疾病登錄與穿戴裝置紀錄都可能成為真實世界數據,可用來觀察日常照護結果、評估試驗招募或追蹤上市後安全訊號。美國食品藥物管理局(FDA)指出,真實世界證據已用於上市後安全監測,也可能支持監管決策,前提是資料適合研究問題且證據符合要求。
例如,研究者可以比較兩種療法在日常照護中的結果,或觀察特定疾病患者的治療使用情況。但資料庫本身不會隨機分派治療。選擇某種治療的人,可能原本就與另一組患者在病情、年齡、共病或就醫條件上不同。分析若沒有妥善處理這些差異,觀察到的結果便不能直接解讀成治療造成的效果。
2024 年一篇回顧整理 85 件使用真實世界證據的監管申請,其中 13 件因樣本數小、選擇偏差或資料缺漏等設計問題,未被視為支持性或定論性證據。更多醫療 AI 從資料到臨床決策的流程也取決於方法是否合適。
「確認資料來源或資料庫是否適合回答所提出的研究問題。」(美國食品藥物管理局 2023 年指引(依英文原文翻譯))
患者數增加,為什麼不等於證據品質提高?
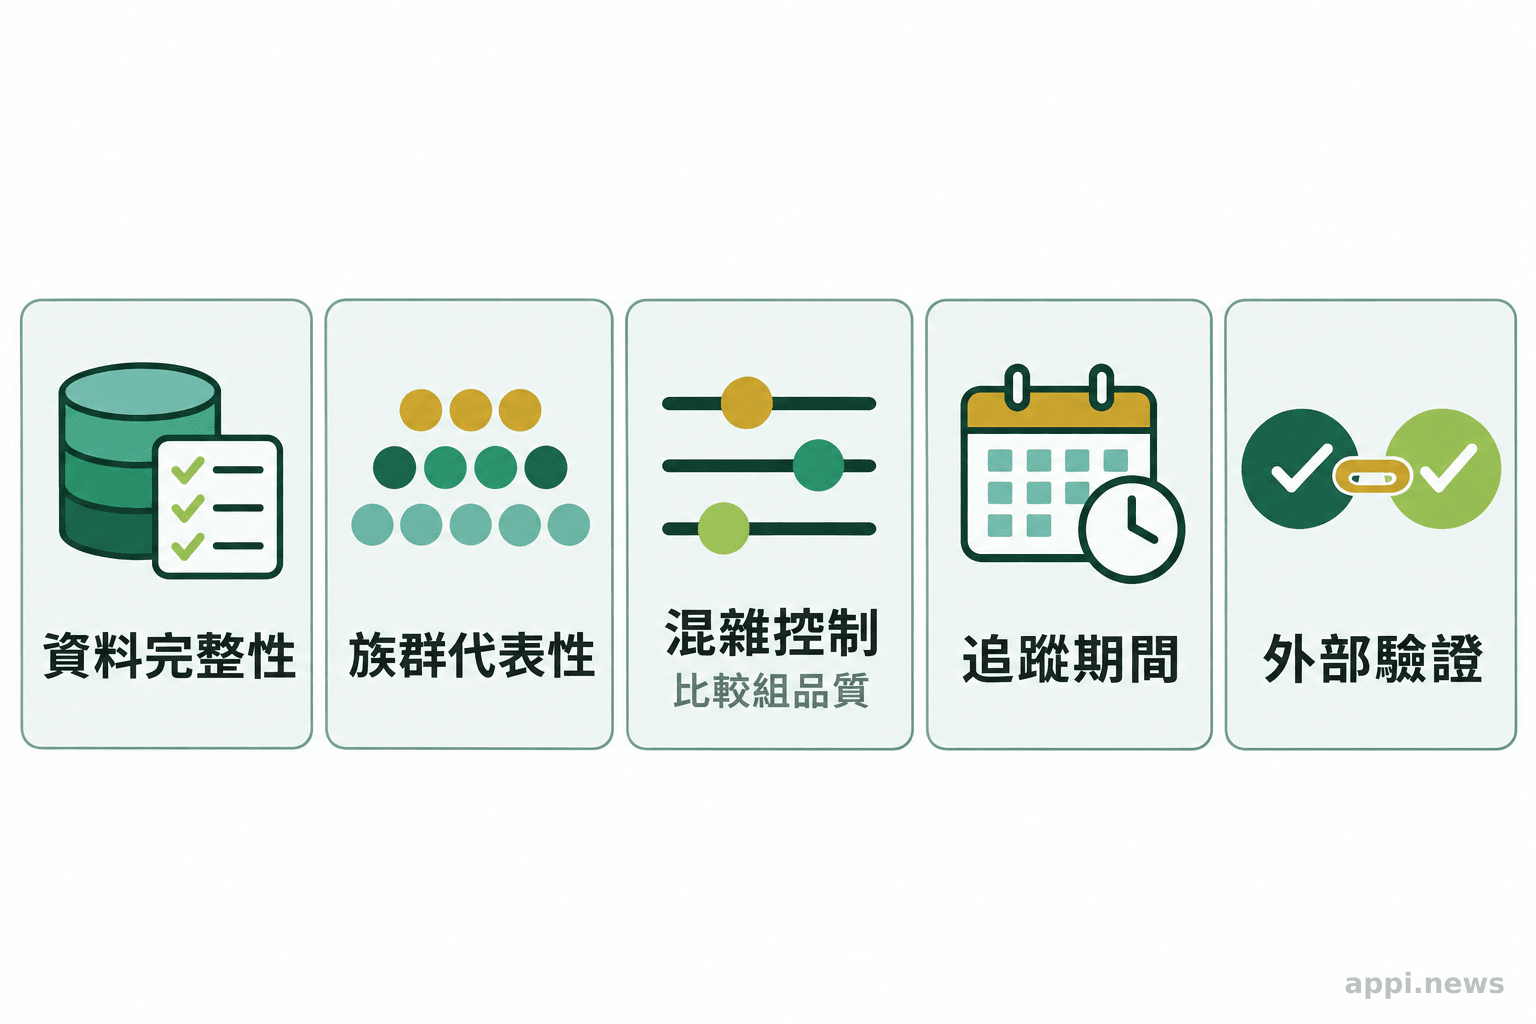
不一定。較大樣本可能提高估計精確度或協助觀察較少見的族群,但資料是否完整、收案是否偏向特定病人,以及研究設計能否控制混雜,仍會影響結果可信度。
讀研究時可先看四個部分。第一是資料是否符合用途:診斷、用藥與結果是如何記錄的,定義是否一致;第二是缺漏:檢查結果、病史或追蹤紀錄若不完整,可能讓部分患者的狀況無法被看見;第三是納入族群:合作院所、地區與就醫型態會影響誰進入資料庫;第四是研究設計:比較組是否合理,是否事先列出分析計畫,並處理已知混雜因子。
FDA 的 2023 年指引建議,研究者評估資料庫能否回答研究問題,說明來源族群與研究族群的差異,並交代資料來源及分析方法的選擇理由。讀者可先確認資料是否適合研究問題,再看結果與模型準確率。
2024 年一篇方法回顧指出,電子病歷、申報與登錄資料可能雜亂且異質,研究設計、資料整理與分析都需配合方法。未測量的混雜因子難以完全排除,觀察到關聯也不能單憑此宣稱因果。
族群代表性也要分開判讀。TriNetX 公告提及網絡包含亞太區資料,但沒有因此證明研究樣本代表台灣患者,或特定資料集確實納入台灣院所。即使同一個模型在大型跨國資料中表現良好,年齡、疾病分布、診療流程、檢驗方式與醫療資源差異,仍可能改變它在其他地區的效能。孕婦、兒童、慢性病患者及長期服藥者,應特別確認研究是否納入足夠人數、相關特徵與足夠追蹤資料;若沒有,不能把整體結果直接套用到這些族群。
- TriNetX 公布的 3 億名患者是網絡規模,不等於單一研究的分析人數。
- 真實世界證據的適用性取決於研究問題、資料品質、納入族群與分析方法。
- 資料庫規模不能證明醫療 AI 已具臨床效能,也不能證明結果適用於台灣患者。
台灣醫療資料治理與醫療 AI 應用要看哪些界線?
不能直接類推。台灣健保署公布的資料庫說明適用於其管理的健保資料,TriNetX 則是另一個跨機構網絡;資料如何取得、保護、處理與提供使用,應分別查證各自的制度和研究文件。
健保署說明,健保資料由院所申報累積,研究等目的外利用有指定管道、使用流程及存取控制。這是台灣公共資料治理的做法,不能據此推定 TriNetX 採取相同流程。去識別化或假名化可降低直接識別風險,資料用途與安全管理仍須依適用規範和制度判讀。可參考健康資料去識別化的用途與界線。
醫療 AI 的臨床效能也必須對應特定模型、任務與場景。訓練資料規模、研究論文中的測試結果或資料平台的全球覆蓋,都不能替代外部驗證與實際臨床評估。若研究結果被用來討論個人治療選擇,仍須由醫療專業人員依個別病況評估,群體研究不能取代臨床判斷。
閱讀相關新聞或研究時,可確認研究問題、資料來源、納入族群、缺漏與混雜處理,再看結果是否在接近實際使用情境的資料中驗證。
- 找出研究的實際樣本數、納入條件與資料涵蓋地區,不以平台宣稱的總人數代替。
- 查看研究如何定義療效或安全結果,以及如何處理缺漏、比較組差異與混雜因子。
- 確認醫療 AI 是否在不同院所或目標族群完成外部驗證,並且評估實際臨床工作流程中的表現。
常見問題
Q1:TriNetX 超過 3 億名患者,代表每篇研究都能分析 3 億人嗎?
不是。3 億是 TriNetX 在 2026 年 6 月公告的 LIVE 網絡總規模。每項研究會依研究問題、納入條件、資料可用性及追蹤期間形成自己的分析族群。
Q2:真實世界證據可以取代隨機對照試驗嗎?
不能一概而論。真實世界研究可補充日常照護、特定族群或上市後安全等資訊;能否支持特定監管或臨床決策,取決於研究設計、資料適用性與證據要求。
Q3:資料去識別化後,就完全沒有個資風險嗎?
不能這樣推論。去識別化是降低識別風險的措施,實際風險仍與資料內容、處理方式、存取權限及適用制度有關。
Q4:TriNetX 的全球資料可以代表台灣患者嗎?
公告提及亞太區網絡規模,但沒有因此證明每項研究都納入台灣患者,或樣本足以代表台灣人口。需查看該研究實際收案地區與患者特徵。
Q5:資料庫很大,是否表示醫療 AI 可以直接用於診療?
不是。資料規模不能代替特定模型與用途的外部驗證、臨床評估及相關監管要求。患者的診療選擇仍應由醫療專業人員依個別情況判斷。
參考來源
- TriNetX. (2026). [TriNetX LIVE™ Network Surpasses 300 Million Patients]()
- U.S. Food and Drug Administration. (2023). [Considerations for the Use of Real-World Data and Real-World Evidence]()
- Liu F. (2024). [Data Science Methods for Real-World Evidence Generation in Real-World Data](). *Annual Review of Biomedical Data Science*, 7(1), 201–224
- Alipour-Haris G, et al. (2024). [Real-world evidence to support regulatory submissions: A landscape review and assessment of use cases](). *Clinical and Translational Science*, 17(8), e13903
- 衛生福利部中央健康保險署。[健保資料庫說明]()


