
AI 影音化身愈能自然接話、看著鏡頭回應,使用者愈可能把互動當成真人對話。Tavus 公布的 Griffin-Lite 一分鐘視訊測試中,54 名受試者有 26 人認為對方是真人,約占 48%;科技媒體 The Decoder 也報導了這項結果。[1][2] 這個數字來自廠商公布的小型研究預覽,不能當成所有使用者或所有情境的錯認比例。評估這類產品時,應先問使用者是否知道對方是 AI,再看真人感能否改善任務,以及誤認會造成什麼後果。
一、Tavus Griffin 的 48% 測試數據代表什麼?
Tavus 表示,54 名受試者中有 26 人在一分鐘視訊後認為對方是真人;這是特定測試結果,不能直接推算一般使用者的錯認率。
測試怎麼進行
Tavus 將 Griffin 稱為 Human Interaction Model,中文可理解為以面對面即時互動為目標的模型。它推出的 Griffin-Lite 是研究預覽版。廠商描述系統能同時接收影音、判斷何時回應,並產生語音與影像;此處的能力說明仍應歸因於 Tavus,不能當成外部驗證後的普遍效能。
依 Tavus 公布的研究預覽,54 名受試者進行約一分鐘通話,事前不知道對方是 AI;通話後有 26 人認為對方是真人,約占 48%。[1][2]
因此,48%描述的是「在這個設計下,多少人事後認為對方是真人」,無法換算成產品上線後的受騙比例。這項測試只有 54 人,通話約一分鐘,不能代表不同年齡、語言或使用條件;這些因素是否改變判斷,仍待測試。長時間互動也未必和一分鐘測試相同。這筆數據適合用來提出產品風險問題,不能用來預測轉換率、信任程度或實際事故數。
研究預覽與獨立評測要分開看
Tavus 同一篇說明也列出 NVIDIA 的 VideoFDB 評測結果。這與一分鐘真人判斷測試不同:VideoFDB 以影片片段及評分規準衡量模型理解對話訊號、回應是否合宜等能力。NVIDIA 的公開基準頁列有 Griffin Lite 的評分,也說明測試會區分理解與生成兩類表現。[3] 這能提供另一個觀察角度,卻不能證明受試者知道 AI 身分後仍會有相同感受,也不能回答揭露方式是否清楚。
兩種證據各自回答不同問題。基準評測看模型在指定任務與規準下的表現;真人測試看特定參與者在特定流程中的反應。即使某一項分數接近人類參照值,也不代表在客服、教學或財務諮詢等真實工作中能穩定完成任務。採購或開發決策仍要看可重現的測試、產品實際條件與錯誤處理安排。
Tavus 在 Griffin 安全與限制說明中表示,發布這類模型需要審慎處理風險與發布策略,並提及仍需進一步安全程序。[1]
「自然的人類對話具有全雙工與影音特性;人們會同時說話、聆聽,並透過視線、手勢與情緒表達訊號。」— VideoFDB 研究團隊。[3]
二、即時影音互動為什麼會提高真人感?
視線、表情、停頓、插話與回應時機一起形成互動感;當模型能即時讀取和生成這些訊號,對話就較不像輪流輸入指令。
從輪流問答到全雙工對話
許多語音介面採用輪流處理:先收完使用者的話,再辨識內容、產生答案,最後合成語音或影像。全雙工(full-duplex)則指收聽與回應可以重疊進行。Tavus 說明 Griffin-Lite 的設計會持續接收影音,在使用者還沒講完時判斷要接話、等待或回應表情。這種架構是廠商對系統運作方式的描述,實際延遲與穩定度仍須在產品環境測量。
真人感也不只由臉部逼真程度決定。對話中一個短停頓,可能表示對方還在思考;視線移開也可能是回想,而非結束發言。若介面能恰當等待、點頭或接續問題,使用者較少需要刻意改成機器聽得懂的說法。反過來說,太早插話、對不相關表情做出反應,或在延遲時仍維持微笑,都會讓互動顯得不自然。
原因在訊號與節奏彼此牽動。模型不只要辨識語句,也得估計現在輪到誰說、對方是否還要補充,以及畫面中哪些線索值得回應。即時生成越流暢,使用者越能專注談話內容,操作摩擦也會降低;同時,AI 身分更容易被忽略,因此提示不能只出現一次。
「使用者仍在說話時,代理如何回應,和它接下來說什麼、何時回應同樣重要。」— VideoFDB 研究團隊。[3]
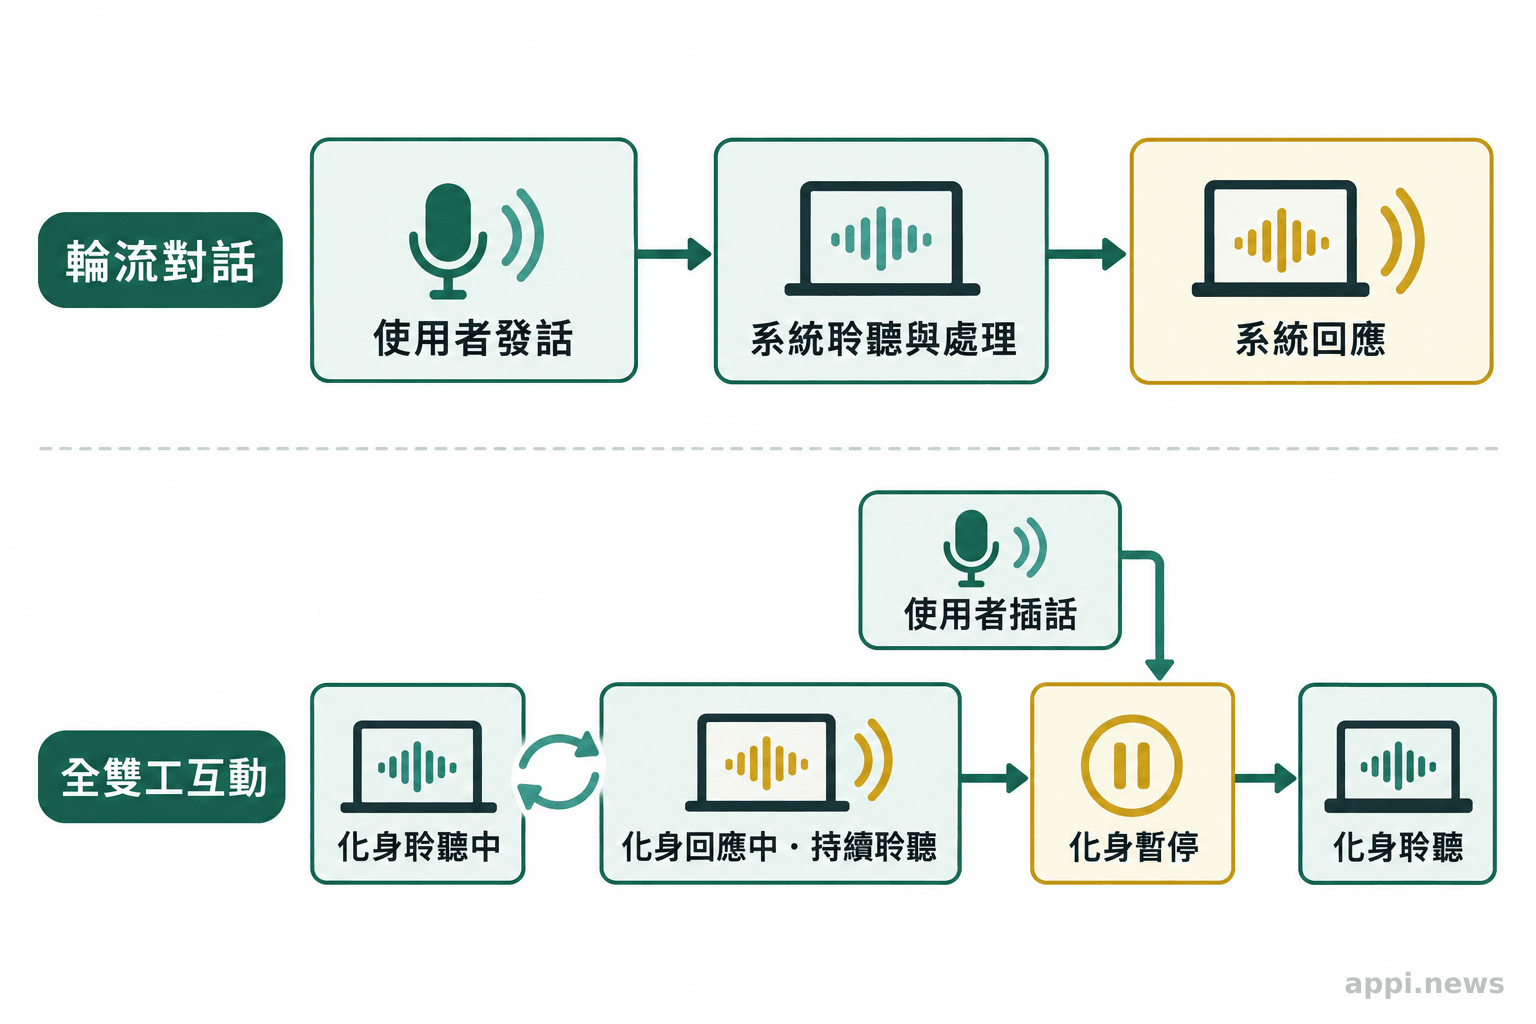
自然互動能反映介面品質,可靠性仍須另行驗證
使用者覺得對話順暢,說明介面可能降低了表達需求的成本;這不等於答案正確、服務公平或資料安全。影音化身可以說錯資訊、誤讀情緒,也可能遇到網路卡頓或辨識失誤。外表親切會讓人更願意繼續談,但不能代替查證、權限控制或人工覆核。
產品團隊因此要把「互動品質」和「任務結果」分開記錄。測試時可以觀察使用者是否理解身分、是否完成任務、是否需重複說明、系統在哪些情況下誤判,以及人工接手是否順利。若只收集滿意度或對話時長,容易把新奇感、真人感和實際效益混為一談。
三、哪些產品介面適合先測試 AI 影音化身?
可先從低風險、任務明確、允許使用者隨時改用其他管道的情境測試;涉及重大決策、敏感資料或身分確認時,應提高揭露與人工接手要求。
適合評估的任務,要有清楚的完成條件
示範產品操作、陪練面試或簡報、帶領使用者完成一般設定,可能受益於影音互動,因為使用者可以邊說邊展示畫面或物件,也能透過表情和手勢補充意思。這些仍是值得測試的場景,不代表 Griffin 已在這些工作中證明成效。選題時可先確認任務是否容易拆分、錯誤是否可逆,以及使用者能否在需要時改用文字、真人客服或其他既有服務。
若工具提供的是選擇資訊或操作引導,輸出最好能連到可查閱的資料或明確步驟。當模型不確定、使用者提出超出範圍的問題,或多次未能理解需求,介面要能承認限制並引導至替代管道。把 AI 化身當作唯一入口,會讓使用者更難判斷該如何退出,也讓營運團隊更難處理例外。
高後果任務要先界定責任
身分驗證、金融交易、醫療建議、法律判斷、招聘篩選或心理支持等情境,使用者可能依據談話內容採取高代價行動。若 AI 化身看起來像真人,使用者可能把流暢表達誤認為專業資格、真人承諾或組織正式決定。此時產品要先說明 AI 能處理哪些事、哪些事不能處理,以及哪個人或單位負責最終判斷。
評估也需納入被服務者的差異。使用者可能不熟悉視訊工具、使用輔助科技、處於嘈雜環境,或偏好文字溝通。只用熟悉科技的內部同仁測試,難以代表真實使用者。測試邀請應說清楚會收集哪些資料,並觀察不同裝置、網路與語言條件下,揭露是否容易看見、轉接是否容易找到。
| 評估面向 | 可先小規模測試的任務 | 需要更嚴格控制的任務 |
|---|---|---|
| 錯誤後果 | 可重做、可撤回,不影響權益 | 可能影響健康、金錢、資格或法律權益 |
| 使用者預期 | 進入前知道是 AI,可選文字介面 | 容易被當成真人、專家或正式承諾者 |
| 替代管道 | 有清楚的退出、重試或轉接方式 | 缺少人工支援或退出會中斷重要服務 |
| 驗收方式 | 記錄任務完成率與辨識身分情形 | 須另設人工覆核、申訴與錯誤補救流程 |
四、AI 身分揭露要放進互動流程哪些位置?
在進入通話前直接說明對方是 AI,互動中持續提供可辨識提示,並讓使用者能退出、改用文字或轉接真人。
開始前要讓人看見,也要讓人選擇
揭露應出現在使用者決定開始視訊之前,文字要直接,例如「接下來會由 AI 影音助理回應」,不宜藏在服務條款、長篇說明或不易察覺的角落。若使用者以為自己排到真人客服,事後補充說明很難修復信任,也可能讓人回想不起自己曾同意什麼。
開始頁可以提供簡短說明:AI 能做什麼、不能做什麼,是否會使用鏡頭和麥克風,對話資料是否保存,以及如何停止。使用者不應因為拒絕開鏡頭就失去必要服務;若任務可以用文字或真人完成,應清楚列出替代選項。這些安排也有助於區分「同意使用影音功能」和「同意保存影音資料」,避免把兩種選擇包成一個模糊按鈕。
對話進行中仍要保留控制權
進入通話後,畫面可持續標示「AI 助理」,並讓提示固定在視窗可見位置。[4]若對話截圖、嵌入其他頁面或轉為小視窗後仍可能失去標示,產品就要檢查提示在這些狀態是否保留。避免只用顏色或圖示表示 AI 身分,因為使用者可能看不出圖示代表什麼。[5]
控制選項要能立即使用,例如暫停、結束、關閉鏡頭、改用文字或轉接真人。需要人工接手時,介面應說明目前在排隊或已轉接,並把必要的對話脈絡交給接手者,降低使用者重新講述的負擔。若轉接失敗,系統應提供後續聯絡方式,避免使用者困在已結束的影音畫面。
Tavus 說明,Griffin-Lite 目前不提供客戶使用,僅開放選定的可信任測試者參與研究預覽。[1]
五、導入前要評估哪些整合與營運成本?
除了模型能力,還要估算影音串接、資料治理、延遲與故障處理、人工接手,以及持續監測和維護所需的人力。
從使用流程盤點系統依賴
影音互動會牽涉鏡頭與麥克風權限、即時串流、身分登入、工作階段管理、字幕、紀錄與客服工具。產品團隊需釐清每一段資料流向:影音是否離開使用者裝置、由哪些服務處理、保存多久、哪些人可存取,以及刪除請求如何執行。若產品面向不同地區,也要確認資料儲存位置與供應商條件是否符合組織的合約和治理要求。
即時介面對延遲與穩定度較敏感。回應慢半秒和畫面中斷,會直接改變談話節奏;攝影機或網路品質也可能使辨識效果起伏。測試不應只在開發者的高速網路完成,要涵蓋常見手機、瀏覽器、低頻寬與背景噪音,記錄連線失敗時使用者能否改走替代流程。
還要計算模型服務以外的營運工作。誰負責更新提示與知識內容?誰檢查錯誤回應、處理使用者申訴和個資事件?模型或 API 條件變動時,誰重新驗收?如果答案是「目前沒有人」,就算初次串接成本可控,日常維護仍可能成為導入瓶頸。供應商尚未公布或未承諾的價格、服務水準與可用地區,不要先當作確定條件納入商業估算。
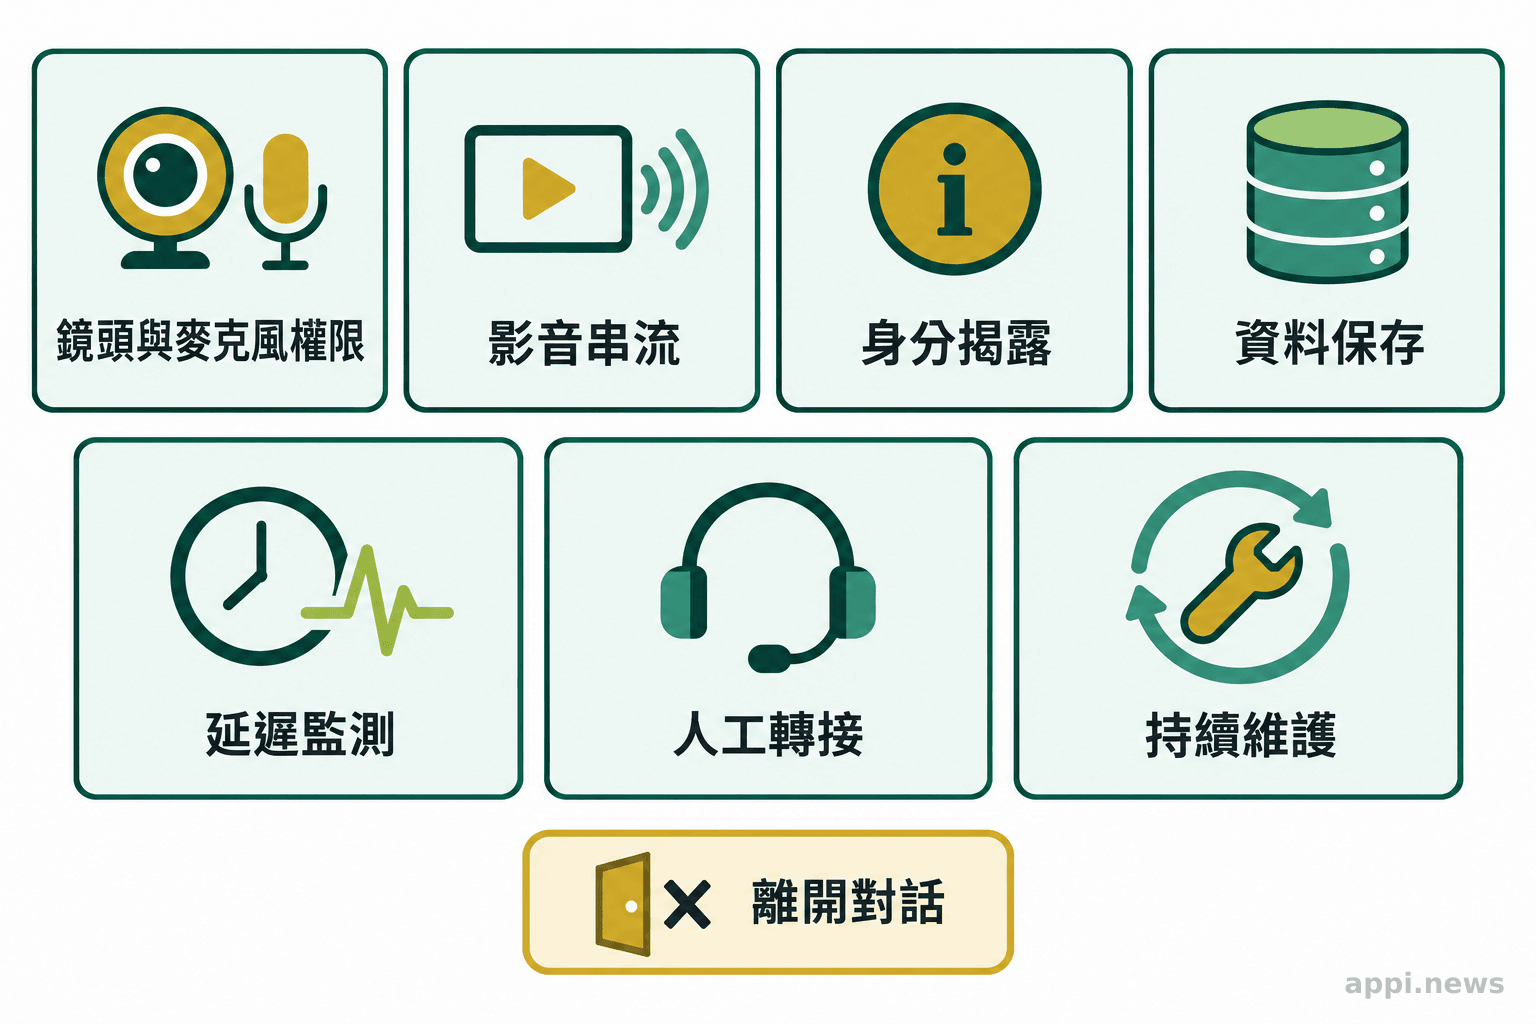
用小規模試行驗證問題與原因
試行開始前先設定停止條件和比較基準,例如相同任務使用文字介面時的完成狀況、影音介面的錯誤率、人工轉接次數與退出比例。參與者要清楚知道互動對象是 AI,研究問題可以觀察告知前後的使用意願,也可以檢查提示是否容易理解,但不應為了重現錯認而刻意隱瞞產品性質。
當使用者中斷或退出,記錄原因比只看「使用時長」更有用。是回答不準、表情不合時宜、延遲太高、身分提示不明,還是任務本來就不需要影音?原因不同,改善方式也不同。若文字或按鈕介面能以較低成本完成任務,影音化身未必值得增加串接和維運複雜度。
- 選定一項錯誤後果低、可由人工接手的任務,寫下成功條件與停止條件。
- 在開始畫面與互動期間測試 AI 身分提示,確認使用者看得到、看得懂,也能退出或改用其他管道。
- 以少量使用者比較任務完成情形、錯誤、延遲、退出與轉接紀錄,再決定是否擴大測試。
- Tavus 公布的 48% 來自 54 人的一分鐘研究預覽,不能代表一般使用者的錯認率。
- 即時影音互動帶來的自然感,不能替代正確性、資料治理或人工覆核。
- 先從低風險且可退出的任務試行,並把 AI 身分揭露、替代管道與維運責任一併驗收。
常見問題:AI 影音化身的測試與導入
截至 Tavus 於 2026 年 10 月 1 日公布的說明,Griffin-Lite 僅提供選定測試者研究預覽,尚未開放客戶使用。
常見問題
Q1: Tavus Griffin 已經全面開放給一般客戶使用嗎?
沒有。Tavus 表示 Griffin-Lite 是研究預覽,只供選定的早期測試者使用;官方頁面並說明目前不提供客戶使用。可用範圍與後續發布安排應以 Tavus 最新公告為準。[1]
Q2: 48% 是否代表所有人都會把 AI 化身當真人?
不能。這是 Tavus 在特定的一分鐘通話測試中公布的結果,樣本為 54 人,且參與者事前不知道對方是 AI。它不能代表不同年齡、文化、產品用途或長期互動中的錯認比例。
Q3: 產品要怎麼讓使用者知道正在和 AI 對話?
在通話開始前用直接文字揭露,互動中保留可見的 AI 標示,並提供退出、文字替代與真人轉接。若影音或對話資料會被處理或保存,也應在使用者開啟功能前說明用途與管理方式。
參考來源
- Tavus Research. (2026). *Griffin: The First Human Interaction Model*. Tavus
- Matthias Bastian. (2026). *Nearly half of test subjects mistook Tavus' AI video avatar for a real person on a one-minute call*. The Decoder
- Mazumdar A, et al. (2026). *VideoFDB: Evaluating Full-Duplex Vision-Speech Capabilities in Conversational Agents*. NVIDIA Research
- National Institute of Standards and Technology. (2024). *Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile*. NIST AI 600-1
- W3C Web Accessibility Initiative. (2025). *Understanding Success Criterion 1.4.1: Use of Color*. W3C


