
多個 AI 代理分工,看起來能同時處理更多工作;但品質是否提高、交付是否變快,必須和增加的 token 成本一起衡量。Vals AI 在 Vibe Code Bench 的測試中,代理團隊平均成本是單一代理的 1.8 至 5.1 倍,四組同條件比較只有一組品質差異達統計顯著。團隊要先釐清要改善的是品質、速度還是任務覆蓋率,再決定多代理是否值得導入。
一、多代理系統要先解決哪一個問題?
先定義想改善的指標:成果品質、完成時間或任務覆蓋率。三者可能互相牽動,不能只用代理數量或 token 用量判定效益。
品質不足時,團隊要看成品是否符合規格、測試是否通過,以及錯誤是否減少;交付太慢時,重點是端到端完成時間;任務覆蓋不全時,則要看分工後是否完成更多必要工作。多代理會增加協調、整合與驗收環節,若任務不能切成彼此獨立的工作,新增代理可能只是多出等待和返工。
先把「可接受的成果」寫成驗收條件,例如必要功能、測試通過率、缺陷嚴重度和交付期限。接著用單一代理建立基準,才有辦法判斷團隊模式帶來的改善,是否超過它新增的成本。若採用 OpenAI Agents SDK 等架構,官方文件也將代理協作描述為由管理代理呼叫專門代理,或將工作交接給其他代理;這些編排方式會影響誰負責整合與最終輸出。OpenAI Agents SDK:代理協調方式
二、Vals AI 的測試比較出哪些差異?
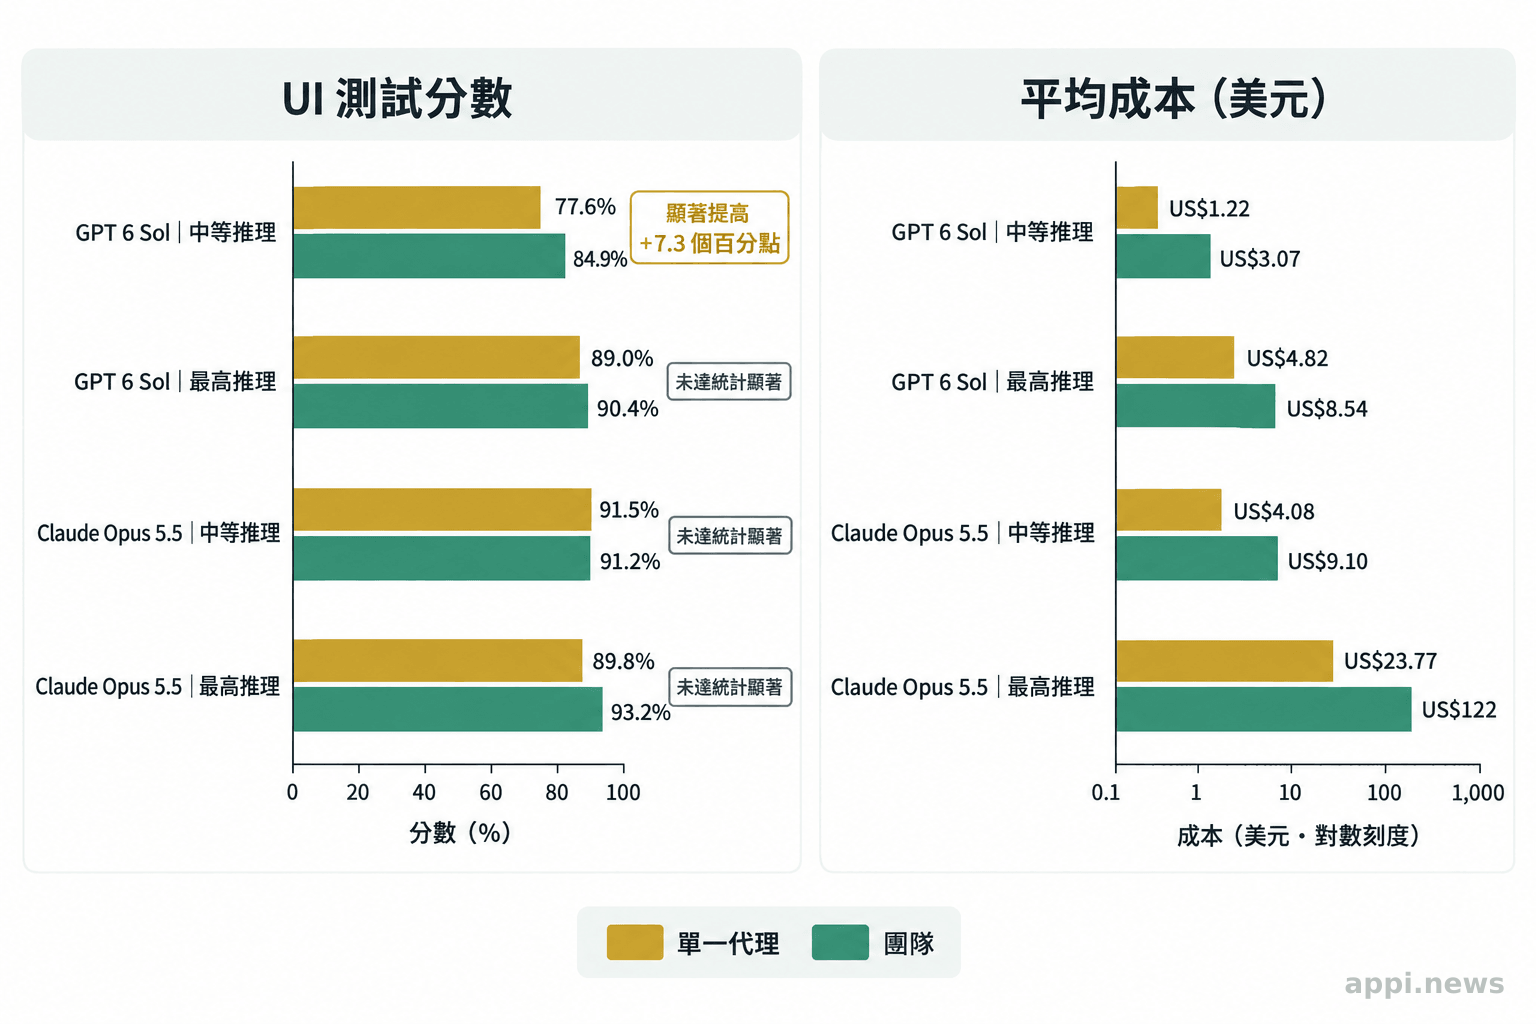
四組比較中,只有 GPT 6 Sol 中等推理強度的團隊組,UI 測試分數比單一代理高 7.3 個百分點且達統計顯著。其餘三組分數差異未達統計顯著。
Vals AI 用 50 個從產品規格建置完整網頁應用的任務,測試 GPT 6 Sol 與 Claude Opus 5.5,各以中等和最高推理強度執行單一代理或團隊模式。每個應用部署後由瀏覽器代理操作工作流程,分數是 UI 測試通過比例的平均值。四組設定各執行一次,同一批應用以配對方式比較。配對 t 檢定比較的是 50 個應用任務在兩種設定下的分數差異;每種設定只跑一次,無法估計同一模型與任務重複執行時的隨機波動。Vals AI 原始測試與方法
| 模型與推理強度 | 單一代理分數/平均成本 | 團隊分數/平均成本 | 分數差異是否顯著 |
|---|---|---|---|
| GPT 6 Sol,中等 | 77.6%/US$1.22 | 84.9%/US$3.07 | 是,增加 7.3 個百分點 |
| GPT 6 Sol,最高 | 89.0%/US$4.82 | 90.4%/US$8.54 | 否,增加 1.4 個百分點 |
| Claude Opus 5.5,中等 | 91.5%/US$4.08 | 91.2%/US$9.10 | 否,減少 0.3 個百分點 |
| Claude Opus 5.5,最高 | 89.8%/US$23.77 | 93.2%/US$122 | 否,增加 3.4 個百分點 |
5.1 倍指 Claude Opus 5.5 最高推理強度團隊組,相對同模型、同推理強度的單一代理組,平均每個應用成本約 US$122 對 US$23.77。Vals AI 的成本是依該次執行的 token 用量與價格假設計算;其中一個團隊執行逾時,約 US$189 的成本由 token 數估算後納入平均。因此,這個倍數描述的是該次測試的 token 成本估算,不能直接當作所有系統的總營運成本倍數。
差異也不只反映在分數。GPT 6 Sol 團隊在最高推理強度下,中位完成時間從單一代理的 38.4 分鐘縮短到 27.6 分鐘;Claude Opus 5.5 最高推理強度團隊則需 174.1 分鐘,單一代理為 74.7 分鐘。速度、測試分數和 token 成本各自回答不同問題,不能只挑其中一項代表整體效益。
因此,分數描述應用通過多少 UI 測試,時間描述從開始到完成所需多久,成本則依 token 用量與價格假設估算。分數提高不代表所有重要缺陷都消失,測試只涵蓋預先設計的瀏覽器流程;時間變短也不等於更早交付,下游檢查安全性、維護性或需求符合度的時間仍須計入。分數差異未達顯著,也只表示這次樣本沒有提供足夠證據支持明確差異。決策時應把指標和團隊目標配對,避免拿 UI 分數回答維護成本,或用 token 費用代替交付價值。
三、代理團隊為何會增加 token 成本?
每個子代理都要取得任務規格與自己的工作上下文,反覆呼叫模型時會累積輸入用量;協調、整合和測試也帶來額外呼叫。
Vals AI 指出,Claude Opus 5.5 最高推理強度團隊組中,子代理每個應用讀取的 cached input tokens 中位數為 2.24 億,主代理為 1,700 萬;同一條件的單一代理為 5,500 萬。快取輸入的單價可能低於一般輸入,但用量龐大仍會推高總額。真正要追的是每一層代理把哪些內容帶入上下文、重複呼叫多少次,以及是否產生可驗收的成果。
分工還會產生模型帳單以外的工作。主代理要定義介面、分配檔案或模組責任、處理代理間交接、解決整合衝突,最後重新測試整體成品。Vals AI 的 Opus 團隊通常分波派工,部分執行時間花在等待前一波完成;其最高推理強度團隊在首次部署後,測試時間也明顯多於單一代理。這些活動若由工程師檢查或修補,人工工時也應列入效益帳。
落地估算時,最好把執行紀錄拆成模型工作、工程師介入與等待時間,而非只記最後完成時間。模型工作可按主代理和子代理分開記錄呼叫次數、輸入與輸出 token、重試次數及各自負責的交付物;人工介入則記錄需求補充、介面協調、程式碼審查、衝突排除和回歸測試花費。等待也應標出原因,例如前置模組尚未完成、代理需要澄清規格,或整合環境被其他工作占用。這些分類能指出成本究竟來自上下文重複、協作設計,還是任務本身,而不是只得到「多代理比較貴」這個無法採取行動的結論。
整合缺陷也可以按責任邊界分類。常見情形包括不同代理各自使用不同欄位名稱、API 契約和實作不一致、共用檔案被覆寫、錯誤處理方式不一致,以及單元測試通過但端到端流程失敗。試跑前應指定每個模組的檔案所有權與輸入輸出格式,指定一個角色負責整合,並讓所有修改回到同一套建置與測試流程。每個缺陷至少記下發現階段、影響範圍、修復者、修復工時及是否在重跑時再現;若團隊組產出更多局部完成的模組,卻把缺陷推到最後整合階段,單看代理完成數會高估實際產能。
四、哪些任務較可能從代理分工獲益?
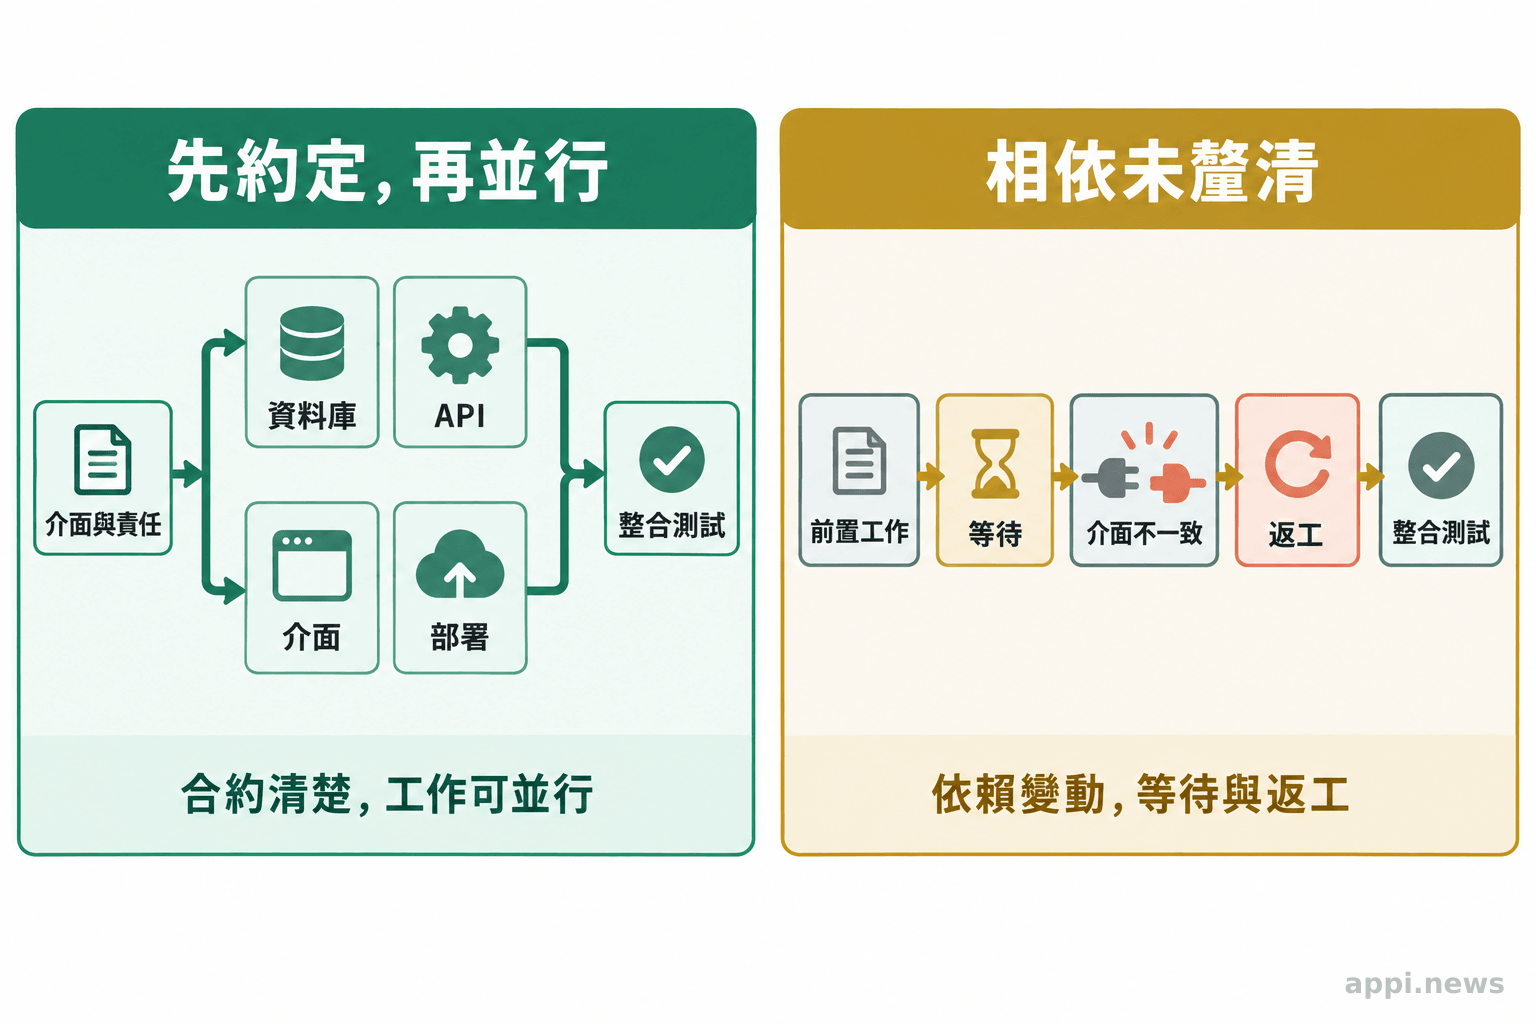
工作可平行拆分、各部分有清楚介面,而且能用整合測試驗收時,分工較可能節省時間或擴大覆蓋。若任務高度相依,先確認協調和返工不會抵銷分工收益。
例如網頁應用可切成資料庫、API、介面與部署工作,這些部分若先約定資料格式、API 路徑及檔案責任,子代理就能相對獨立地開發。相反地,若需求仍在變、各模組必須頻繁共同決策,或最後沒有可靠的整合測試,平行產出容易形成不相容的介面與重複實作。
Vals AI 的結果也呈現模型與編排方式的差異:Sol 團隊較早並行拆解工作,測試中完成時間較短;Opus 團隊常先建立共同契約,再分批建置和測試。這是特定模型、代理執行框架和這組軟體任務下的觀察,不能推論所有代理架構都會有相同表現。多代理效益會隨任務可分割性、協調方式、模型、推理強度、上下文傳送及價格方案改變。
要判斷一項工作是否真的可平行處理,可以先畫出工作依賴:哪些步驟能同時開始,哪些必須等待共用決策或前一項產物。若資料庫結構決定 API 欄位,API 又決定介面送出的格式,這幾項工作即使分派給不同代理,也需要先對齊契約;否則代理會各自做出合理、合在一起卻無法運作的結果。相較之下,互不共用檔案、只透過固定輸入輸出交換結果的子任務,較容易平行執行。可以先用小型工作拆分圖標出依賴、負責人和交付物,再估算同時進行能省下的等待,並把建立契約及最後整合的時間扣回去。
介面契約不必一開始就寫成厚重文件,但至少要回答幾個能避免重工的問題:模組讀取什麼資料、輸出什麼格式、哪些檔案由誰修改、錯誤如何回報,以及誰有權合併變更。主代理若負責整合,應在派工前提供共用規格,在子代理交付時檢查契約而非只接收自然語言摘要,最後以整體流程的測試結果決定是否合格。若子代理對同一規格有多種解讀,先修訂契約,再重跑受影響工作,通常比等所有模組完成後才一次排查更容易定位問題。
不適合分工的訊號包括:需求經常改變、成果須由同一位專家持續判斷、子任務頻繁改動共用狀態,或成功標準只能靠整體主觀評估。這些情形初期協調與驗收成本可能較高。可先挑邊界明確的流程試跑,讓代理分別檢查模組,再由整合者核對重疊與矛盾;若溝通增加的時間超過省下的執行時間,就保留單一代理或採部分分工。
「一個團隊是否值得採用,取決於模型、任務與預算。」這是 Vals AI 對該次基準測試的結論摘要;它提醒團隊把架構選擇放回自己的工作條件中評估。
五、技術團隊怎麼驗收多代理是否值得?
用同一批代表性任務、同一模型版本與提示,建立單一代理基準,再讓多代理組依相同驗收規則試跑。按合格成果計算成本,並分開記錄完成時間、token 用量與整合缺陷。
驗收可固定看五個面向:成果合格率、每個合格成果的模型與人工總成本、端到端完成時間、輸入及輸出 token 用量、整合缺陷與返工量。每件合格成果的成本,比單看每次呼叫 token 更接近實際決策,可用「模型費用加人工處理成本,再除以合格成果數」計算;交付時間則從接到任務開始,包含等待、整合和修補。品質還要看測試覆蓋與缺陷嚴重度,避免把單一分數當成完整產品品質。
樣本任務應涵蓋團隊平常會遇到的不同難度與依賴型態,而不只挑最容易平行化的案例。可先依任務大小、模組相依程度、外部工具需求及驗收方式分層,再從各層挑選代表案例,並事先固定每種架構的執行次數。試跑量有限時,至少在相同任務與設定下重跑多輪,保留每輪的原始結果與失敗狀態;再比較平均值、中位數與範圍,觀察結論是否被少數超時或特別成功的執行左右。若只比較兩組各自挑選的任務,難度差異會混進架構差異,因此應讓單一代理與代理團隊處理相同任務,並使用同一套自動測試與人工評分規則。
公平比較還要固定可能改變結果的條件。紀錄模型名稱與版本、推理設定、系統提示、工具權限、上下文材料、生成設定、執行環境、價格表與停止條件;任何一項改變都應標記在結果中。若無法完全固定版本或價格,就把變更日期和適用方案列清楚,避免把價格調整造成的帳單變化誤認為代理架構的效率差。比較時同時呈現任務層級結果與整體摘要,保留失敗、逾時、人工接手和重跑資料,不要只留下成功案例或平均分數。
統計判讀也應服務於決策門檻。團隊可事先定義品質不得低於多少、每個合格成果的成本上限、可接受的最長等待,以及哪些等級的缺陷必須為零;結果未達門檻時,先檢查錯誤是否集中於特定任務類別。若兩種架構的差異小於團隊認定的實務重要幅度,即使某次平均值略有優勢,也不必急著改變全流程。若樣本數仍不足以看出穩定差異,可把結論標成待觀察,增加同類任務與重複輪次,而不是把不確定性寫成已證明的優勢。
試跑時可採以下步驟:
- 挑選一組常見且具代表性的真實任務,固定規格、資料與驗收條件。
- 記錄單一代理的模型版本、提示、推理設定、token、費用、完成時間及缺陷。
- 以同一條件讓多代理完成相同任務,補記協調、整合和人工介入所需時間。
- 比較合格率、每個合格成果的總成本、交付時間與整合後缺陷。
- 按任務類型決定是否擴大,並持續檢查模型、價格或工作流程改變後的結果。
監測不應在試點結束後停止。正式使用時,可按週期抽查合格率、成本、等待、超時比例、人工接手次數與整合缺陷,並和試跑基準比較。模型更新、提示修改、代理數量調整、工具權限擴大或任務組成改變,都可能改變品質與支出;這些變動發生時應重新跑一小組固定案例,確認原有驗收門檻仍成立。若缺陷變多或單件合格成本超標,先依追蹤紀錄定位是上下文膨脹、重試增加、任務切分不當,還是整合測試不足,再調整架構。對影響範圍大的程式碼變更,保留人工核准或回復機制,並設定無法完成時的停止條件,避免代理持續重試把一次失敗擴成成本與變更範圍都不可控的工作。
OpenAI Agents SDK 文件提醒,採用代理編排時要「投入心力設計良好的提示,清楚說明可用工具、使用方式與代理必須遵守的限制」。這是官方文件對代理指令設計的建議,應用在多代理試跑時,也能讓每個子任務的工作邊界更容易檢查。OpenAI Agents SDK:代理協調方式
Vals AI 的測試限制也應納入判讀:它聚焦 Vibe Code Bench 的 50 個軟體建置任務,不涵蓋多種產業工作;八種設定各執行一次,統計檢定反映的是 50 個應用任務間的配對差異,沒有估計重複執行的波動。兩種模型使用不同執行框架,成本依 token 用量和特定價格假設計算。這些限制使結果適合當作設計團隊試驗的參考,不能當成多代理系統普遍有效或普遍無效的定論。
- 先確定要提高品質、縮短時間或擴大任務覆蓋,再選擇代理架構。
- Vals AI 四組比較只有一組分數差異達統計顯著;5.1 倍成本對應 Opus 5.5 最高推理強度團隊組。
- 以自己的任務比較每個合格成果成本、完成時間和整合缺陷,符合門檻再擴大使用。
常見問題
不能。測試只涵蓋特定模型、軟體建置任務與執行框架,適合用來提出評測問題,不足以代表所有工作。
常見問題
Q1:Vals AI 是否證明多代理普遍不值得?
沒有。測試中只有一組團隊分數差異達統計顯著,但其他任務可能有不同的平行化收益;團隊需用自己的代表性任務驗收。
Q2:token 成本高五倍,代表總成本也一定高五倍嗎?
不一定。5.1 倍是 Claude Opus 5.5 最高推理強度團隊組相對單一代理組的 token 成本估算。實際總成本還包括模型定價、執行環境、工程師監督、整合與返工工時。
Q3:何時應先調整單一代理,而非增加代理數?
當任務尚未拆清楚、驗收條件不明確,或單一代理仍有提示、工具、測試流程可改善時,先調整基準通常較容易定位問題。確認瓶頸來自可平行處理的工作後,再測試多代理。
參考文獻
- Drozdov K. (2026). Do Agent Teams Pay Off? A Case Study on Vibe Code Bench. Vals AI. https://www.vals.ai/blogs/multi-agent-vibe-code-bench
- OpenAI. (n.d.). Agent orchestration. OpenAI Agents SDK. https://openai.github.io/openai-agents-python/multi_agent/


