AI 代理沒有報錯,也順利回覆使用者,這樣就算通過驗收嗎?還要追問它是否答對、選對工具、引用正確資料,以及完成任務時是否多走了不必要的步驟。AWS 推出的 CloudWatch Omni 把代理執行追蹤、品質評估與版本實驗放在同一工作流程,讓團隊能從單次執行紀錄追到測試比較;評估結果仍須依任務條件解讀,不能直接當成代理整體能力的證明。
代理沒有報錯,為什麼仍可能驗收失敗?
因為系統執行成功,只代表流程完成,不代表任務結果正確。 驗收要同時看操作表現與回答品質,並先定義各類任務的成功條件。
操作正常不等於回答正確
一般服務監控常看錯誤率、可用性與延遲。這些指標有助於確認系統是否回應、請求是否卡住,卻無法單獨判斷內容有沒有根據。代理可能成功呼叫搜尋工具,卻把檢索結果理解錯;也可能回傳格式完整的答案,但漏掉問題中的關鍵限制。若只看 HTTP 狀態碼或「任務完成」,品質問題會藏在成功請求裡。
代理的執行路徑也比單次模型問答複雜。一次任務可能包含多次模型呼叫、資料檢索、工具操作、子代理交接與重試。某一步輸入不完整,後面每一步仍可能照常執行,最後產出看似流暢卻偏離目標的答案。錯誤碼能指出部分故障,無法取代任務結果的判讀。
把失敗定義成任務結果
驗收前先把「做好」寫成可檢查的條件。例如客服代理要正確辨認退貨資格、查詢對應訂單、引用有效政策,並在資料不足時轉交人員。這些條件可拆成答案正確性、工具選擇、工具參數、依據一致性、流程交接等評估項目。各項判準要對應真實使用者需求,避免用「回答聽起來合理」作為唯一標準。
失敗分類也要說明後續處理方式。答錯政策內容可能要查檢索來源或知識庫版本;漏掉訂單查詢則要檢查路由與工具描述;多次重試造成延遲,可能反映模型判斷或流程控制問題。若分類只有「分數低」,團隊仍不知道該找哪個環節。
CloudWatch Omni 的執行紀錄能看見什麼?
在代理送出相應追蹤資料後,CloudWatch Omni 可用 trace、span、session 與拓撲檢視單次執行、多輪互動及元件關係。 可見範圍取決於各步驟是否正確加入 OpenTelemetry 儀器。
Trace、span 與 session:從單次執行追到多輪互動
OpenTelemetry(開放遙測標準)將一次完整工作記為 trace(追蹤),trace 內的 span(跨度)代表模型呼叫、工具操作或檢索等步驟。span 的巢狀關係呈現呼叫順序,也能記錄時間、輸入輸出與屬性。若同一個使用者任務跨多輪對話,session(工作階段)可把相關 trace 串起來,協助檢查代理是否忘記前文、重複追問或在交接時遺失資訊。
AWS 的 CloudWatch Omni 文件指出,trace 檢視可呈現單次代理執行及其中各 span;session 則用來查看跨多輪的對話。要讓自建代理正確分組,團隊需要依文件為每輪 trace 設定一致的工作階段識別值。若沒有這項資料,多輪互動可能被拆成互不相關的紀錄。AWS CloudWatch:Monitor AI agents
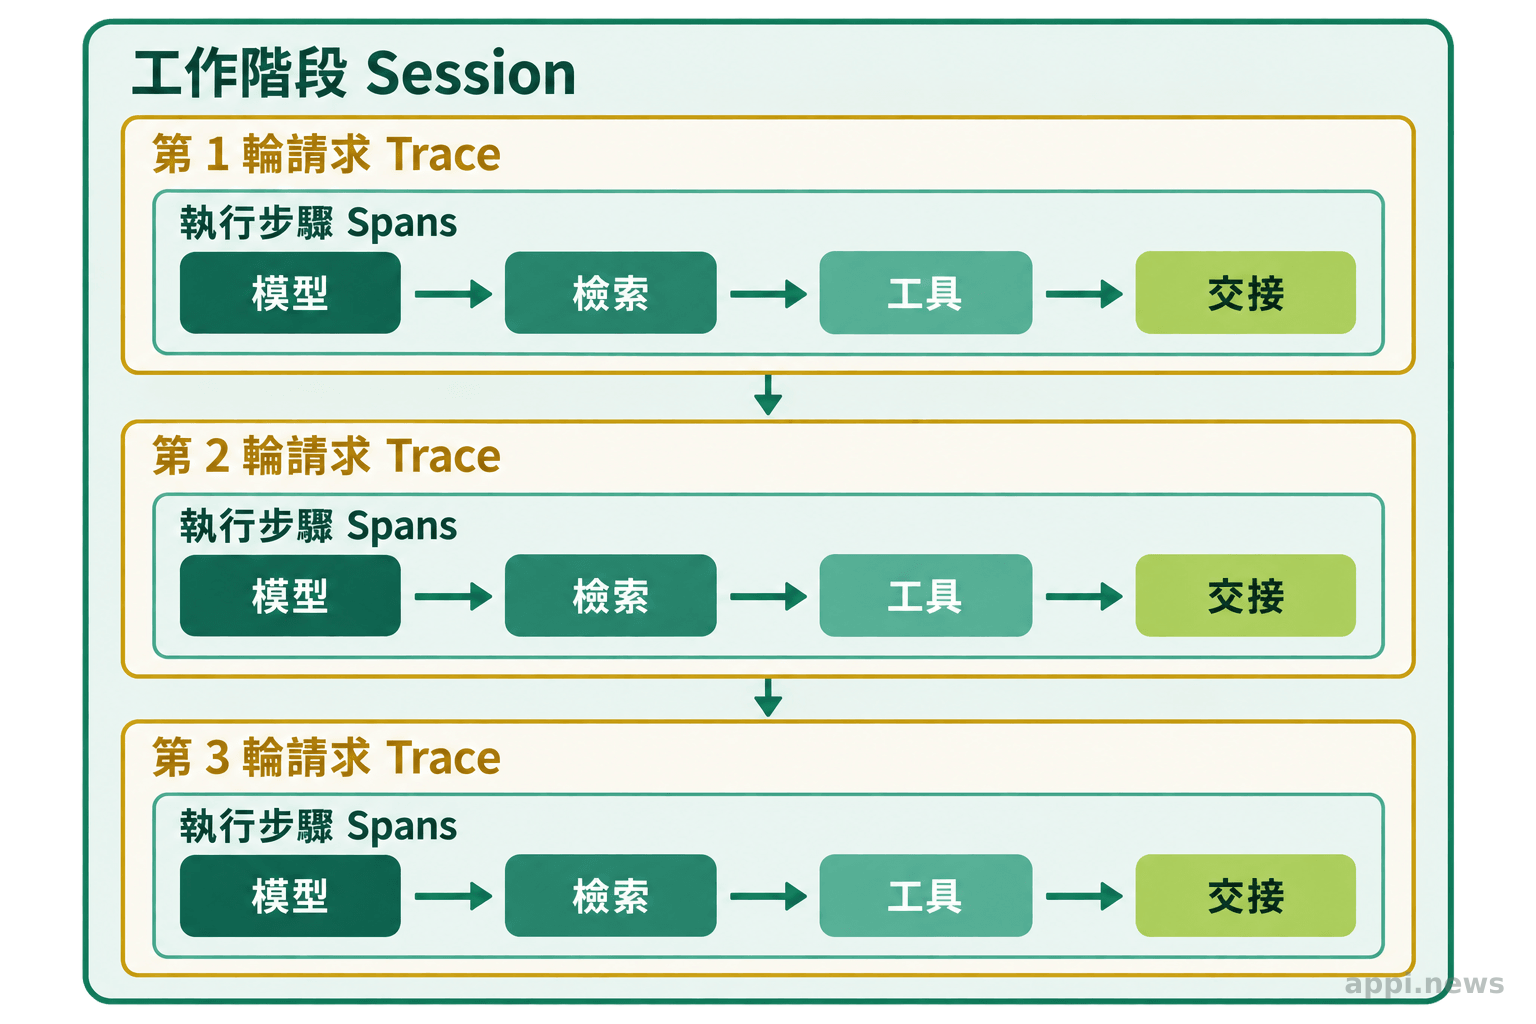
模型、工具與延遲:沿時間順序找卡點
逐步檢視 span,可比較各模型呼叫和工具操作花了多久、消耗多少詞元,以及輸入輸出如何變化。假設整體延遲升高,若資料顯示模型生成時間相近,但某個外部查詢工具明顯變慢,調查範圍就能先縮小到工具服務或其依賴。若詞元用量上升,再核對提示詞長度、檢索片段數量、重試次數及對話歷史是否膨脹。
Agent topology(代理拓撲)把多次追蹤彙整成元件關係圖,呈現代理、模型與工具如何互相呼叫,以及延遲集中在哪些節點。AWS 文件目前將此檢視標示為預覽功能,並說明圖表完整度受 span 儀器設定影響。沒有記錄到的工具不會出現在圖上,因此拓撲只能描述已觀測到的路徑。AWS CloudWatch:Agent topology
可觀測性要從資料送出前開始
CloudWatch Omni 讀取代理送出的追蹤資料。若模型輸入輸出、工具呼叫或檢索步驟沒有被記錄,團隊就無法從畫面還原那些環節。完整度因此屬於系統整合工作的一部分:列出代理的模型、工具、檢索服務和交接點,再逐一確認它們是否產生 trace 與 span,欄位是否能連回同一次任務。
AWS 官方文件也提醒,拓撲由追蹤資料中的 span 建立,未經儀器化的工具不會呈現在關係圖中。這表示畫面沒有某個節點,可能是程式未呼叫它,也可能只是追蹤漏記;調查時須對照程式日誌、工具端紀錄與追蹤設定,才能區分行為問題和觀測缺口。
「圖表的完整度取決於你的儀器設定。」這項限制提醒團隊先確認追蹤覆蓋範圍,再用拓撲推論代理實際走過的路徑。— AWS CloudWatch「Agent topology」(譯述)
怎麼把執行紀錄變成可比較的驗收?
從真實 trace 挑出代表性任務,固定資料集、評估器與執行條件,再以實驗比較變更前後的品質、延遲與詞元用量。 比較結論只適用於這組案例與判準。
從真實失敗案例建立測試資料集
可以把常見請求、邊界案例與已知失敗紀錄整理成測試資料集,為每個案例補上預期結果或可接受範圍。案例不應全是容易回答的標準題,也要包含歧義輸入、缺資料情境、工具失敗與必須拒答或轉交的情況。真實流量有助呈現使用方式,但需先去除或遮蔽個人資料與機密內容,再挑選是否納入。
建立資料集時,保留失敗發生時的任務條件與必要上下文,並註明人工確認過的正確答案、工具軌跡或引用依據。單純複製模型當時的輸出當作標準答案,可能把原錯誤寫進測試基準。對會隨時間更新的知識,也要記錄測試所用資料版本,避免比較時把內容變動誤認為模型差異。
固定條件,再比較版本
比較模型或提示詞時,同一批案例應使用相同評估器、相同資料、相同工具版本與相同任務設定。若一次同時更換模型、提示詞、檢索資料與工具,分數改變便難以歸因。較可判讀的做法是逐項改動,記錄版本,並在實驗中一併看答案品質、延遲、錯誤與詞元用量。
AWS 將實驗描述為讓兩個以上代理版本在相同資料集與評估器下執行,降低比較中其他變因的影響。這能協助回答「這次改動在既定測試案例上帶來什麼變化」,卻不能證明該版本在所有使用者、語言或未收錄情境都較好。資料集要隨新失敗案例更新,避免測試集長期只覆蓋舊問題。AWS CloudWatch:Evaluate agent quality
操作表現與回答品質分開判讀
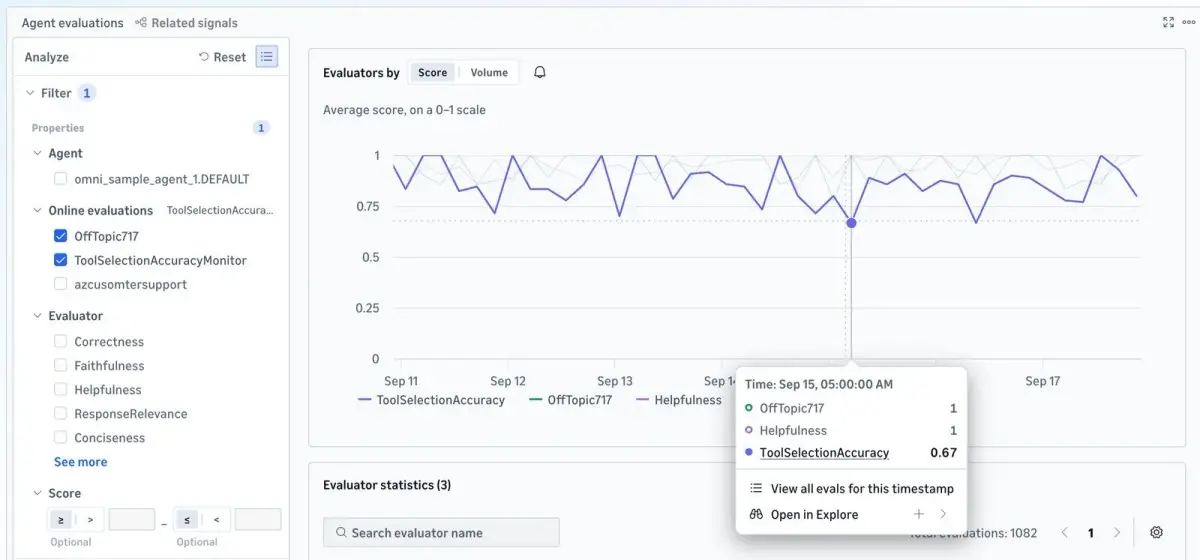
操作面可看任務完成率、工具呼叫是否成功、每步延遲、重試與詞元用量;品質面則看正確性、相關性、回答是否符合檢索依據,以及是否遵守流程要求。兩組結果要並列閱讀:低延遲、低用量不代表回答可靠;回答分數高也可能伴隨超時或成本超出預算。驗收標準應依任務設定門檻與可接受取捨。
CloudWatch Omni 的 evaluator(評估器)依指定準則為 trace、session 或工具呼叫評分。AWS 文件建議先用已知表現良好與不良的紀錄檢查評估器是否能區分,再納入正式比較。對需要標準答案的案例,應使用有預期結果的資料集評估,不能只靠沒有 ground truth(標準答案)的即時 trace 判定正確性。AWS CloudWatch:Evaluators and evaluations
| 驗收面向 | 可觀察訊號 | 能回答的問題 | 單獨使用的盲點 |
|---|---|---|---|
| 操作表現 | 延遲、錯誤、重試、工具呼叫、詞元用量 | 哪一步慢、失敗或消耗偏高? | 無法證明答案正確 |
| 回答品質 | 正確性、相關性、依據一致性、工具選擇評分 | 輸出是否符合任務要求? | 受資料集與評分規則限制 |
| 版本比較 | 同資料集、同評估器下的實驗結果 | 某次改動對既定案例有何影響? | 不代表未測試情境 |
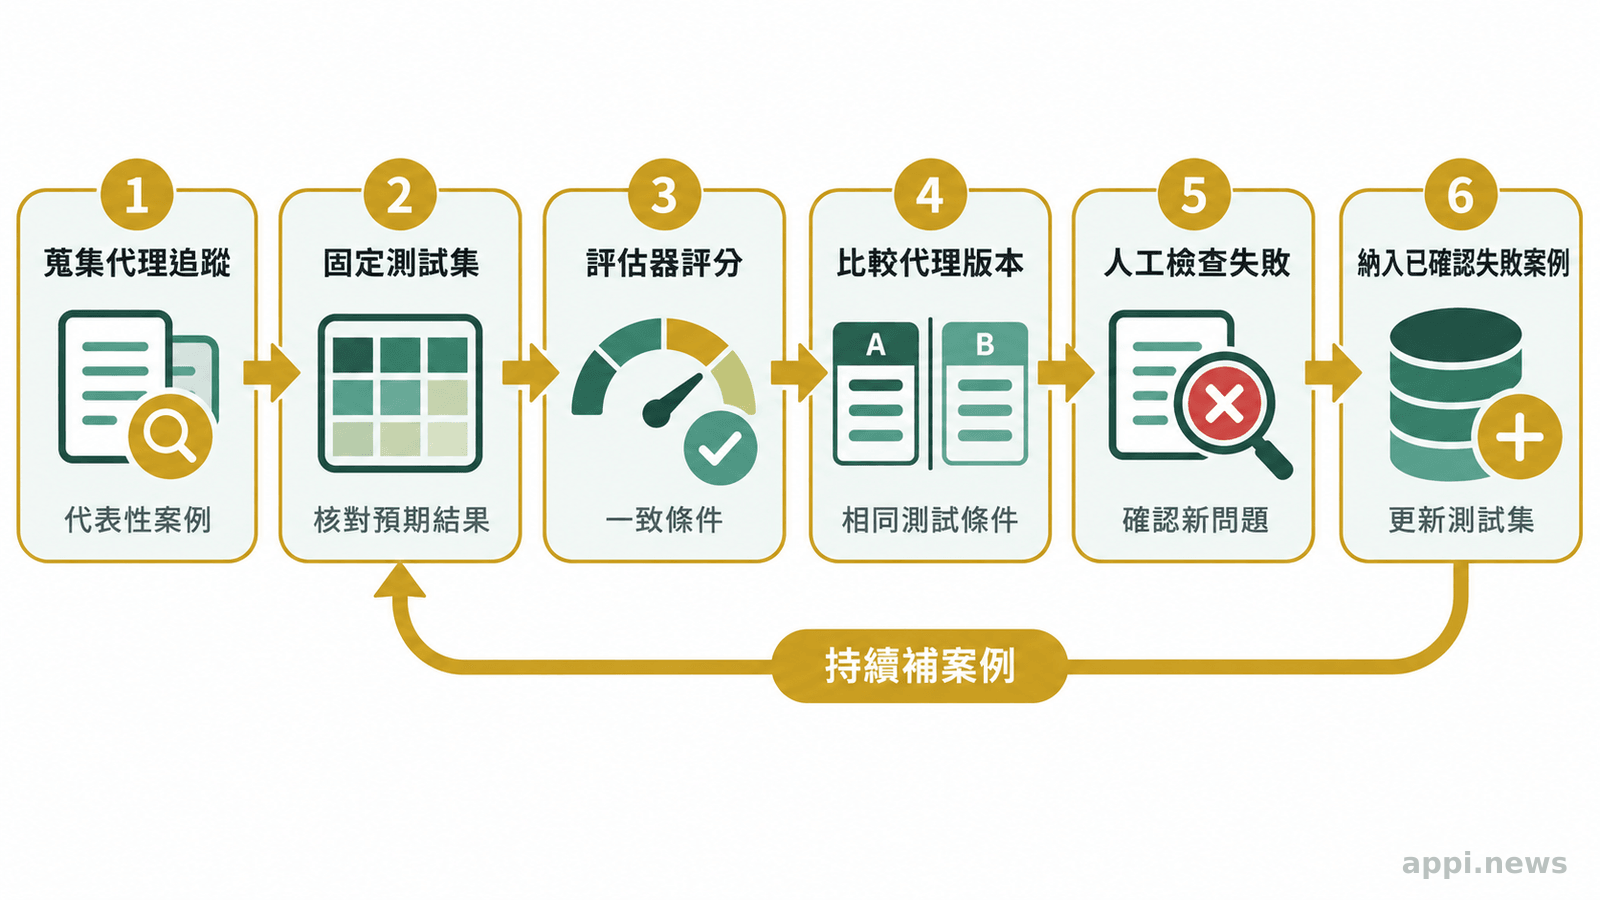
- 先把任務成功條件拆成可檢查的品質與操作指標。
- 從真實使用紀錄建立有代表性的測試案例,並確認預期結果。
- 比較版本時固定資料集、評估器和執行條件,再檢查分數、延遲與用量。
評分結果如何連回問題根因?
先定位低分案例或異常 span,再對照提示詞、檢索內容、工具回應和流程交接,逐項驗證可能原因。 分數指出需調查的地方,根因仍須由紀錄與重現結果確認。
品質退化時,回查檢索、工具與提示詞
若回答正確性下降,先看同一 trace 裡模型拿到什麼資料、檢索結果是否包含答案、工具回傳有無錯誤,再檢查提示詞如何要求代理使用證據。若檢索內容已錯或過期,單改提示詞未必能修正;若工具選擇失準,應檢查工具說明、輸入欄位與路由條件。將低分案例逐步重現,比直接在大量設定中同時調參更容易找到原因。
也要留意資料分布改變。新一批使用者問題若比舊資料集更短、更口語,離線分數仍可能維持,線上表現卻下滑。把經人工確認的線上失敗補回資料集,再觀察不同任務類型的分數分布,可降低平均值掩蓋特定族群問題的機會。
延遲或詞元用量升高時,定位執行步驟
逐步檢查各 span 的時間與輸入規模,確認耗時來自模型、檢索、外部工具或重試。如果只有某一工具延遲上升,應同時檢查其服務日誌與依賴;若多個步驟的提示上下文都變長,則要看對話歷史保留策略、檢索片段數與代理迴圈是否增加。成本問題應連回工作量和任務成功率一起看,避免只削減詞元後讓代理漏掉必要步驟。
自動評分需要人工抽查與回復方案
自動評估適合大批量篩查與追蹤趨勢,結果仍受準則設計、評分器能力和輸入資料影響。抽取高分、低分及評分器意見不一致的案例,由熟悉任務的人員覆核;若自動分數和人工判斷長期相反,先修改評估準則或測試資料,不要逕自把分數當成品質事實。
版本變更也應保留回復條件。先選定關鍵任務的最低通過門檻、可接受延遲與用量,再在預備環境執行回歸測試;未達門檻就暫緩部署或切回先前版本。正式環境持續抽樣監測,將新發現的失敗納入下一輪測試,形成「發現、定位、修正、再驗收」的循環。
「單一絕對分數本身很少有意義;分數透過比較才更有用。」— AWS CloudWatch「Evaluators and evaluations」(譯述)
導入前要先確認哪些資料與流程條件?
先確認追蹤覆蓋、資料保護、存取權限、測試資料代表性與服務成本,再選一項任務試跑完整驗收循環。 工具能否提供可用結果,取決於這些條件是否配合。
追蹤內容的權限與敏感資料
代理 trace 可能包含使用者輸入、模型輸出、檢索文件與工具參數,其中可能出現個人資料、商業機密或存取憑證。AWS 文件說明,CloudWatch Omni 不會自動偵測或遮蔽個人識別資訊,除非團隊自行設定,資料不會自動移除。因此應在送出追蹤前界定必要欄位、遮蔽方式、保留期間與可閱覽角色,並避免把敏感內容放進名稱或標籤。AWS CloudWatch:Protect sensitive data
評估時也要確認資料會送往哪些服務。若使用判斷模型或第三方評估器,需了解輸入 trace 的內容與處理位置,將其納入組織的資料分類、合約和存取管理。追蹤資料越詳細,除錯線索越多,暴露面也越廣,應讓記錄粒度與實際分析需求相符。
儀器覆蓋、資料代表性與成本
檢查所用框架、語言、執行環境與工具是否能送出需要的 OpenTelemetry 資料。以一筆成功、一筆失敗和一段多輪對話逐項對照實際流程,確認 trace 可串接,工具呼叫可見,必要的輸入輸出欄位齊全。代理拓撲頁目前標為預覽,相關能力與可用範圍應以導入時的 AWS 官方文件為準。
成本評估則要納入追蹤儲存、評估器執行、額外模型判斷與團隊覆核時間。詞元用量可以揭露模型工作量,不能單獨代表整體營運成本。若持續記錄完整內容或對所有流量執行評估,需先估算資料量與評估頻率,並確認保留政策符合內部要求。
以小範圍驗收流程逐步擴大
可先挑一項常見、能重現且錯誤後果可控的代理任務,明確寫出成功條件、失敗分類及交接規則。接著確認 trace 記錄完整,從實際執行中挑選代表案例,補上人工核對的預期結果,並讓評估器先跑已知好壞案例。這一步能檢查資料與評分規則是否對準任務。
之後以固定資料集比較提示詞或模型版本,同時查看品質、執行步驟、延遲和詞元用量,並抽查評分案例。若結果能重現已知問題、指出可調查的步驟,且團隊能說明變更帶來的取捨,再擴到其他任務。這比一開始追求單一總分,更能讓驗收進入開發與營運日常。
- 選一項能重現的代理任務,列出正確回答、工具操作與交接的成功條件。
- 檢查 trace 是否涵蓋模型、檢索、工具與多輪對話,並移除不必要的敏感資料。
- 從常見案例、邊界案例與失敗紀錄建立測試資料集,人工確認預期結果。
- 用相同資料集和評估器比較版本,並列判讀品質、延遲、錯誤與詞元用量。
- 抽查評估結果,設好部署門檻及回復條件,再逐步擴大監測範圍。
代理驗收的常見疑問
追蹤紀錄負責呈現執行過程,評估分數提供指定準則下的比較線索;通過與否仍要依任務成功條件和人工抽查判定。
常見問題
Q1: 有追蹤紀錄就能判定代理答對嗎?
不能。trace 可呈現已記錄的輸入、輸出和執行步驟,是否正確仍需對照任務要求、可靠依據或人工確認的預期結果。缺少儀器化的步驟也不會出現在紀錄中。
Q2: 怎麼公平比較兩個提示詞或模型?
讓兩個版本使用相同測試資料、評估器、工具版本和任務設定,並盡量一次只改一項。比較時同看品質、延遲、錯誤與詞元用量,結論限定在這組測試案例。
Q3: AI 評分器可以取代人工審查嗎?
評分器可協助大量篩查和趨勢追蹤,不能取代任務專家確認成功標準。應抽查不同分數及有爭議的案例,並用已知好壞紀錄檢查評分器是否符合預期。
參考來源
- Amazon Web Services (2026). *Evaluate agent quality - Amazon CloudWatch
- Amazon Web Services (2026). *Evaluators and evaluations - Amazon CloudWatch
- Amazon Web Services (2026). *Agent topology - Amazon CloudWatch
- Amazon Web Services (2026). *Protect sensitive data - Amazon CloudWatch
- Amazon Web Services (2026). *Monitor AI agents - Amazon CloudWatch