
ChatGPT用藥建議可以幫你整理疑問,但涉及自行停藥、減藥或更換藥品,必須先由醫師評估,並請藥師核對用法與交互作用。回答寫得流暢、附上表格,甚至表示「依你的狀況」,都不代表已完成個人化的醫療判斷。
醫療AI正在協助醫院處理紀錄、文件與複雜資料。這些進展有實際價值;當工具走進你的手機,安全界線也要跟著說清楚。對台灣跨科就醫、同時服用處方藥與保健品的讀者,最有用的起點,是帶著完整清單找專業人員確認。
一、研究答對幾題,不能直接換算成你的用藥安全
你要分開看答案是否正確、資訊是否完整,以及照著做有沒有傷害風險;單一測驗的高分,無法替你的停藥或調藥決定背書。
Morath等人的探索性研究收集50個真實藥物問題,由6名資深醫院藥師評估。只有13個回答同時符合內容正確、資訊足以啟動處置,而且沒有患者傷害風險;另有13個回答被評為可能有高傷害風險。(註1)
Morath等人的研究指出,錯誤內容、缺少參考來源與回答再現性不足,都是將ChatGPT用於藥物資訊時必須處理的障礙。這是特定研究情境下的結論,不能當成所有版本的共同錯誤率。(註1)
另一項由Cornelison等人進行的研究,評估聊天機器人對20種常用處方藥相關問題的回答。美國AHRQ的研究摘要將結果整理為「完全或大致正確約97%」及「資訊完整約81%」,顯示一般藥物提問具有輔助潛力,也仍有遺漏資訊的情況。(註2)
「完全或大致正確」包含部分有錯的答案,不能拿來替代「完全正確」,更不能當成個人用藥的安全保證。兩項研究的題型、評估方式也不同,不能據此宣稱工具的安全性從26%進步到97%。
對你而言,藥名解釋答得好,仍不能保證漏服處理、腎功能相關調整或多重用藥判斷都正確。閱讀AI藥物資訊回答的評測結果時,也要先看測了什麼,再看分數。
把AI當成幫忙整理食譜的助手比較貼切:它能列出材料,卻可能漏掉你對某項食材過敏。用藥判斷更需要完整病史,缺少關鍵條件的建議,即使大部分內容正確,也可能不適合你。
二、醫院採用AI,先看它負責哪一段工作
你要先確認AI的任務、資料來源與覆核者;院內文件輔助、專科診斷工具和公開聊天機器人,各自承擔的工作與風險不同。
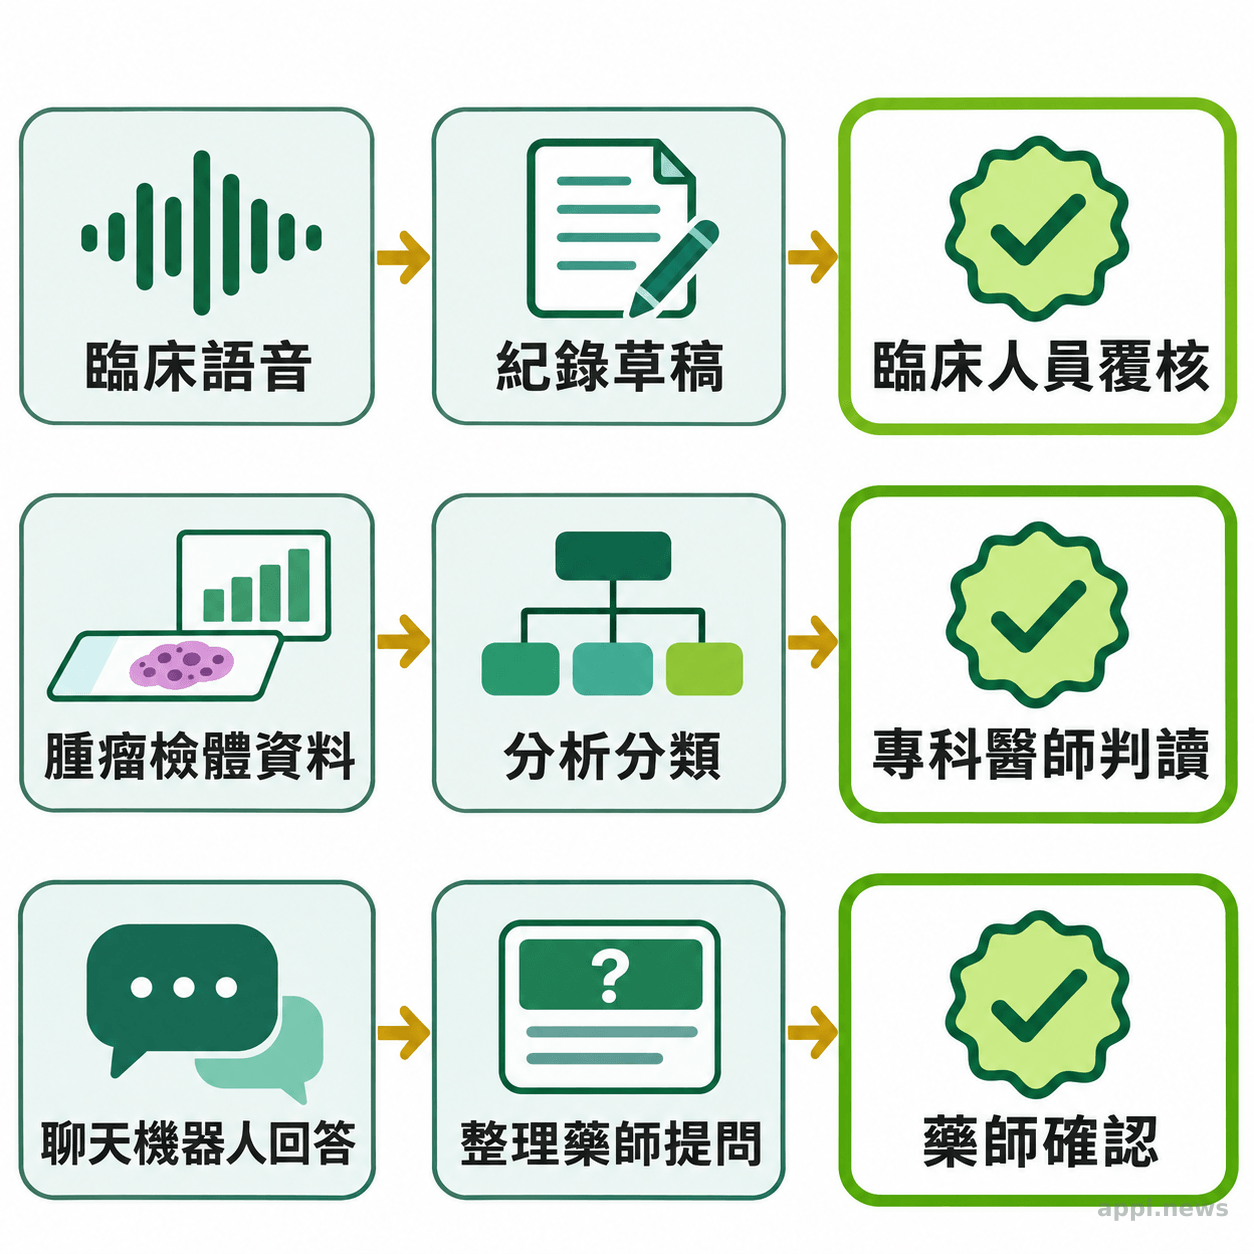
ispec於2026年10月30日公布,熊本中央病院在同年9月使用Sail AI約6,300次,當月有229名職員使用,10月時實際使用的AI業務已超過300項。用途從看護紀錄的語音輸入,延伸到記錄與文件下稿。(註3)
這是廠商公布的院內導入數據,反映使用規模與工作流程。6,300次業務執行不等於6,300次診斷成功,300項業務也不等於300種疾病已證實能由AI安全處理。
德國海德堡大學醫院的神經病理則呈現另一條路:以DNA甲基化模式協助腫瘤分類,並運用AI處理大量資料、細化分子診斷。院方強調神經病理、神經外科與神經腫瘤等領域的合作。(註4)
這類專科應用有明確的檢體與分析任務。你在聊天視窗描述頭痛,並未走過同一套檢驗與判讀流程;看到「AI協助癌症診斷」,也不宜推論一般聊天回答已能自行決定癌症治療。
| 使用情境 | 可以提供的協助 | 你應確認的安全條件 |
|---|---|---|
| 院內紀錄與文件 | 整理語音、產生文件草稿 | 醫療人員核對內容,院方管理資料權限 |
| 專科資料分析 | 協助辨識模式、支援分類 | 確認適用對象、驗證結果與專業判讀 |
| 個人使用聊天機器人 | 解釋名詞、整理就醫問題 | 核對來源,個人用藥交由醫療人員評估 |
日本厚生勞動省的2026年白書也將科技應用連結到流程重整,並主張把節省的時間與人力重新分配到直接照護。(註5)台灣讀者就醫時可以問:「這項AI結果由誰確認?如果與你的判斷不同,會怎麼處理?」
三、停藥與調藥前,把聊天答案帶回診間
你先不要依聊天內容自行改藥,應把原處方、實際服法與AI回答交給原診療團隊或藥師核對;若已出現急性不適,直接尋求醫療協助。
MobiHealthNews於2026年10月28日報導,一名患有癲癇的美國女性死亡,家屬指控她曾依ChatGPT建議減少並停止抗癲癇藥物,並已對OpenAI提告。相關說法涉及家屬指控,報導不能取代法院對責任與因果關係的認定。(註6)
這項事件提醒的是一個具體情境:當你擔心副作用,很容易希望得到「可以少吃一點」的答案。反覆追問聊天機器人,得到更符合期待的回覆,仍不能補上身體檢查、檢驗與持續追蹤。
WHO也提醒,生成式AI可能產生錯誤、不完整的資訊;人們因信任自動化系統而忽略錯誤,是需要管理的風險。(註7)遇到答案與藥袋不一致,應把差異當成待核對的問題,別用哪個回答比較肯定來決定。
《黃帝內經・素問・徵四失論》以「診病不問其始」提醒診察須追問病情起點,並把飲食與起居納入了解。這句話可作為重視問診脈絡的觀念提醒,不能用來證明AI準確度或特定治療療效。(註8)
你可以把「想停藥」轉成可回答的就醫問題:「哪個不舒服可能和藥有關?是否需要檢查?如果適合調整,如何安排追蹤?」這樣能把擔憂說清楚,也讓醫療人員有機會處理真正困擾你的事情。
你現在就能做的事
- 列出所有處方藥、成藥、中藥與保健品,包含名稱、劑量、頻率及實際服法。
- 記下不舒服的開始時間、變化,以及是否曾漏服或自行改量。
- 保存讓你猶豫的AI回答,圈出停藥、減量或交互作用等具體建議。
- 聯絡原診療團隊或領藥藥局,請醫療人員核對,確認後續處置。
清單應把不同科別的藥物放在一起,避免只核對其中一張處方。若同時吃中藥或保健品,也可參考看診前如何整理三高用藥與保健品清單,把實際使用情形交代完整。
如果你已照AI建議改藥,請主動告知改了什麼、改多久,不必等到下次例行回診。也不要再讓聊天機器人替你安排補服或恢復劑量;出現意識不清、呼吸困難等急症,應立即就醫或撥打119。
四、問健康問題前,先檢查病患資料隱私
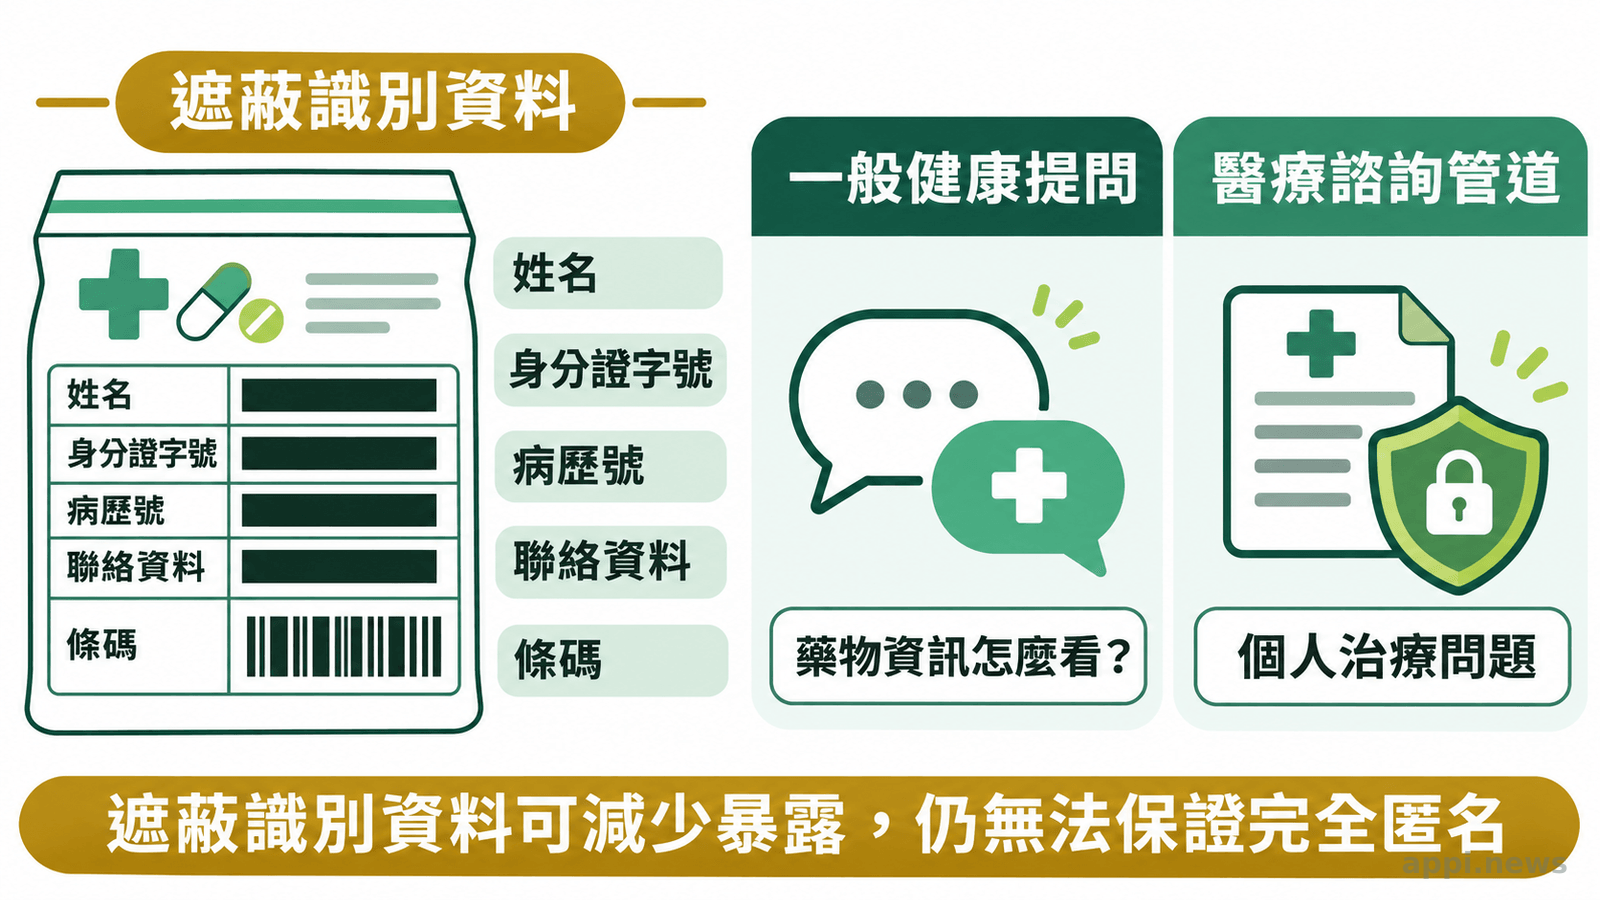
你應先確認服務的資料用途、保存與存取方式,避免把可識別身分的完整病歷直接上傳;涉及個人治療時,優先使用醫療機構指定的溝通管道。
病患資料隱私也會影響AI是否值得信任。WHO將網路安全、病人資訊與隱私列為治理重點,並建議大型部署接受獨立稽核及影響評估。(註7)機構採用工具時,資料流向與出錯後的責任,都需要有人管理。
實際提問可先用一般情境,例如「看診時應如何詢問藥物副作用?」。若要使用文件協助理解,先遮住姓名、身分證字號、病歷號、地址、電話與條碼等資訊;移除姓名仍不保證完全無法識別,罕見病史與日期組合也要斟酌。
你替家人詢問時,同樣需要考慮對方是否同意分享。資料傳得更多,也不會自動把一般聊天服務變成合格的診療流程。想整理問題,可先依健康資訊查詢的來源核對方法檢查出處,再帶去諮詢。
常見問題
Q1:ChatGPT回答有附論文,就可以照著吃藥嗎?
還不能。論文可能確實存在,卻研究不同族群、不同劑量或不同問題。你可以請醫師或藥師一起看引用是否適用,個人處方仍須另行評估。
Q2:只是想問藥品用途,也一定要掛號嗎?
一般用途可先看藥袋、藥品說明或詢問藥師,AI能協助整理看不熟悉的名詞。若問題牽涉你的症狀、劑量或換藥,就要回到專業評估。
Q3:AI和醫療人員說法不同,該相信誰?
把差異具體列出,請醫療人員說明依據。你也可以尋求第二專業意見,但不要在核對前依AI回答自行停藥或調藥。
Q4:中藥與保健品也要一起核對嗎?
要。請把名稱、成分或包裝帶上,讓醫療人員了解完整使用情形。「天然」這個標示,無法單獨回答能否與處方藥併用。
Q5:醫院有用AI,代表病歷可以隨意貼到其他服務嗎?
不能這樣推論。不同系統的契約、權限與資料處理方式可能不同;你可以先問院方使用哪個管道,再決定分享哪些資料。
- AI適合協助理解與整理問題;停藥、調藥及個人治療須由合格醫療人員評估。
- 正確率、完整度與傷害風險是不同指標,醫院使用次數也不能當成療效證據。
- 就醫前整理完整用藥與症狀清單,保留需要核對的AI回答,同時減少不必要的個資上傳。
參考來源
- Morath B, et al. (2024). Performance and risks of ChatGPT used in drug information: an exploratory real-world analysis. European Journal of Hospital Pharmacy, 31(6), 491–497
- Cornelison BR, Erstad BL, Edwards C. (2024). Accuracy of a chatbot in answering questions that patients should ask before taking a new medication. Journal of the American Pharmacists Association, 64(4), 102110;AHRQ PSNet研究摘要
- 株式会社ispec (2026). 病院AXプラットフォーム「Sail AI」、熊本中央病院で月間約6,300回活用。実際に使われるAI業務は300件超に. PR TIMES
- Universitätsklinikum Heidelberg (2026). Von der Mikroskopie zur KI: Andreas von Deimling prägte die moderne Hirntumordiagnostik in Heidelberg. 海德堡大學醫院新聞室
- 日本厚生勞動省 (2026). 令和8年版厚生労働白書:これからの医療・介護・福祉の現場で働くことを考える〔概要〕
- Bender E. (2026). OpenAI sued over allegedly dangerous ChatGPT medication advice. MobiHealthNews
- World Health Organization (2024). WHO releases AI ethics and governance guidance for large multi-modal models. WHO
- Kim JH. (2015). A Literature Study on interrogation(問診에 대한 서지학적 고찰,含《素問・徵四失論》引文). Journal of Korean Medical Classics, 28(1), 21–34


