
AI回答藥物資訊時,文字流暢、段落清楚,常讓人覺得答案已經整理妥當;但讀起來完整,和內容正確是兩件需要分開檢查的事。UNC Health藥物資訊中心近期比較ChatGPT 5.1、OpenEvidence、Clair及搭配證據包的ChatGPT 5.1,20題測試中各平台準確率有明顯差距,而OpenEvidence的整體品質評分又與準確率排名不同。這組結果提醒醫療人員:看AI藥物資訊,不能只看它答得順不順。
使用聊天機器人整理醫療資訊時,可先參考核對 ChatGPT 醫療回答來源的方法,打開它列出的來源,再確認內容是否真的支持回答,而不是只看引用格式像不像論文。
一、準確率和整體品質評分,分別在看什麼?
不一樣。準確率看答案是否正確,品質評分則涵蓋回答呈現與內容等多個面向。兩種分數可能出現不同排序,不能互相代替。
UNC Health藥物資訊中心的描述性研究,從中心資料庫挑出20個問題,涵蓋10類藥物資訊並區分簡單與複雜題目,再比較四種 AI 回答與藥物資訊專家整理的參考答案。ChatGPT 5.1準確率為70%,提供證據包的ChatGPT 5.1為60%,OpenEvidence為40%,Clair為15%。這些數字指該研究題目與測試條件下的表現,不是各產品在所有藥物問題上的固定準確率。
品質評分呈現另一種排序:藥物資訊專家參考答案與OpenEvidence的平均整體品質分數同為82.5%。研究摘要指出,AI回答有組織清楚、容易閱讀的優點,但仍可能有準確性、引用來源辨識及證據統整上的限制。讀者若把「品質分數高」直接理解成「答案更正確」,就把不同評量指標混在一起了。
兩種評分回答不同問題:答案可以清晰、易讀、涵蓋項目多,卻在關鍵結論或引用上失準。Triplett等人比較藥物資訊中心與ChatGPT的研究,以10個藥物資訊問題產生84則ChatGPT回答,也觀察到類似落差:相較藥物資訊中心答案,整體準確率為50%;盲性評閱者依八項量表評分時,ChatGPT整體分數為67.5%,高於中心答案的55.0%,但中心答案在提及與辨識參考文獻方面較好。研究者因此提醒,回答仍需檢查正確性與完整性。
「AI平台對藥物資訊問題的準確度與回答品質各有差異。」(研究結論,譯文)
這項20題評測適合用來理解如何分開看準確率、可讀性、引用與證據統整,不足以替所有模型與問題定出通用排名。
二、為什麼不同研究會得到不同結果?
題目、模型版本、評分方式和提問情境不同,結果就不能直接排成同一張排行榜。小型測試的百分比更要連同研究設計一起讀。
荷蘭研究收集30個醫院藥師日常遇到的臨床藥學問題,使用當時的ChatGPT 3.5測試。模型在23題提供建議,其中26%被評為正確且完整、22%完全錯誤;研究另將10題重新生成回答,只有1題(10%)在是否提供建議及準確性上都與初次回答一致。複雜問題中沒有回答被評為正確且完整。這項研究測的是醫院藥師的日常工作題目與舊版模型,不能直接代表更新模型或一般民眾的簡單用藥疑問。
Albogami等人的橫斷面研究以70個真實藥物諮詢問題比較GPT-4與藥師,兩者均有95%的回答被評為安全,GPT-4有64.3%完全正確,與藥師表現相近;但分題型檢視時,交互作用及妊娠、哺乳問題仍有落差。研究題目數量有限,問題多由醫師與藥師提出,也不等於病人直接使用時的結果。
自我照護題庫又是另一種測試。一項自我照護研究比較六個大型語言模型對非處方藥與保健食品問題的回答,GPT-4整體表現最高;研究仍觀察到答案會受語言、問法、使用者情境及時間影響。這表示「某模型在某題庫表現不錯」不能推導成「任何人用任何語言問藥都可靠」。評測年份、當時可用的模型、問題難度及參考答案的建立方式,都是理解數字的必要背景。
因此,轉述研究時應同時交代樣本與限制。只寫「AI正確率七成」會讓人誤以為那是穩定、普遍適用的能力;更精確的說法是「在這項20題、特定平台與測試條件的比較中,ChatGPT 5.1準確率為70%」。
三、醫療人員和讀者如何核對 AI 藥物資訊?
把AI當成整理線索的工具,遇到會影響用藥決策的內容,回到可查證的原始來源與專業人員確認。尤其是劑量、交互作用、禁忌和特殊族群資訊,不宜只憑聊天回答採取行動。
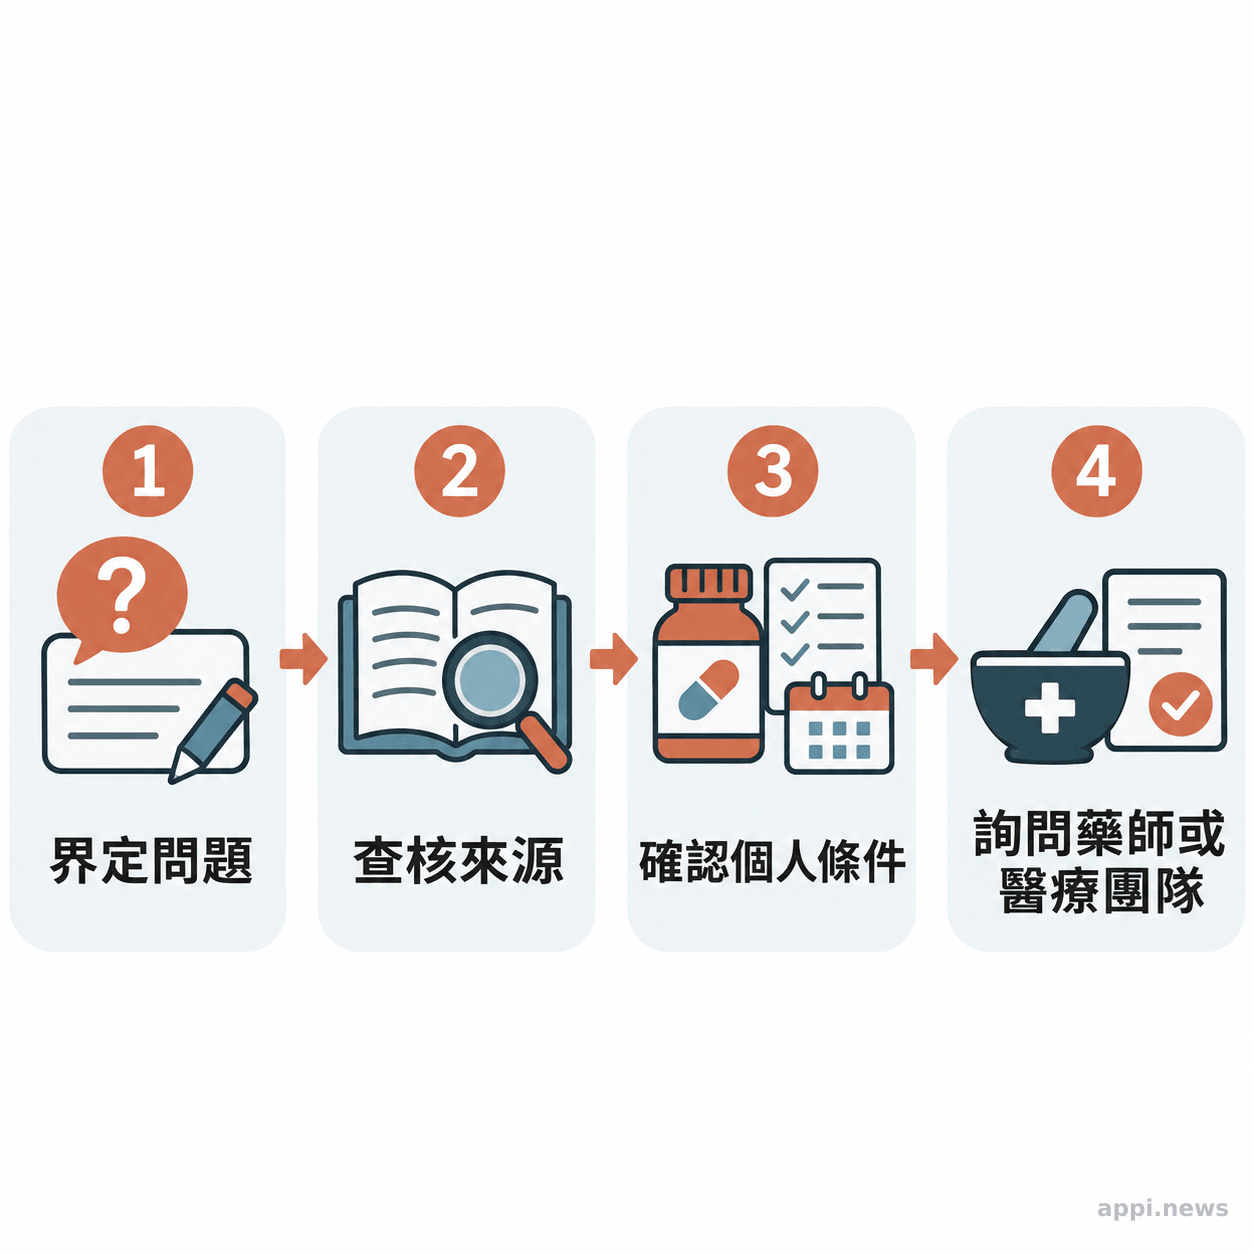
可以依序檢查四件事:
-
先界定問題。確認問的是藥品成分、使用方式、交互作用或特定族群風險;不要把背景不完整的個案資訊當成完整情境。
-
逐條打開來源。核對文獻或藥品仿單是否存在、是否適用該問題,並確認內文真的支持AI的說法。若引用無法辨識或連結失效,答案就還沒有可追查的根據。
-
檢查關鍵條件。留意劑量單位、給藥途徑、腎肝功能、年齡、懷孕哺乳狀態及併用藥物等條件是否被忽略。研究也顯示,即使整體評分不低,引用與臨床取捨仍可能不足。
-
把決策交回適當專業流程。涉及個別病人的療程調整、停藥或緊急症狀,應由藥師或醫療團隊確認。輸入AI工具前也不要放入可識別病人的個資或未公開資料。
藥物問題常有條件差異,一個看似簡單的「能不能一起吃」可能牽涉藥品劑量、服用時間和個人狀況。AI可以協助把問題整理成待查清單,也能把艱深文字改寫得容易閱讀;引用來源、證據是否適用,以及最後的臨床判斷,仍需要人核對。關於聊天工具處理健康問題的範圍,可再看ChatGPT能整理健康疑問、但不能替代診斷的界線。
- 回答清楚、品質評分高,不等同於每項藥物資訊都正確。
- 研究數字只適用於該研究題目、模型版本與評分條件,不能當成通用準確率。
- 涉及個別用藥決策時,查核原始來源並請藥師或醫療團隊確認。
常見問題
Q1: AI藥物資訊回答準確率70%,代表可以直接採用嗎?
不代表。70%是特定20題評測中ChatGPT 5.1的結果,不能套用到其他藥品、問題或使用情境。
Q2: 為什麼品質評分高,答案還可能不正確?
品質評分可能同時看清晰度、完整性與其他呈現面向;文字清楚不會自動保證事實正確或引用可追查。
Q3: AI列出的論文或仿單可以直接相信嗎?
不宜直接相信。應打開原始來源,核對標題、適用族群與內容是否真的支持回答。
Q4: 哪些藥物問題特別需要專業人員確認?
涉及劑量調整、交互作用、禁忌、懷孕哺乳、腎肝功能或停藥決策時,應由藥師或醫療團隊確認。
Q5: 提問時可以貼上病人的完整資料嗎?
不要輸入可識別病人的個資或未公開資料;如需整理情境,先移除可識別資訊,再按機構規範使用工具。
參考來源
- Issa N, et al. (2026). Accuracy and Quality Assessment of Artificial Intelligence Platforms and a Hybrid Evidence-Assisted Model in Responding to Drug Information Questions. American Journal of Health-System Pharmacy
- Triplett S, et al. (2025). A comparison of drug information question responses by a drug information center and by ChatGPT. American Journal of Health-System Pharmacy, 82(8), 448–460
- van Nuland M, et al. (2024). Assessing accuracy of ChatGPT in response to questions from day to day pharmaceutical care in hospitals. Exploratory Research in Clinical and Social Pharmacy, 15, 100464
- Albogami Y, et al. (2024). Safety and quality of AI chatbots for drug-related inquiries: A real-world comparison with licensed pharmacists. DIGITAL HEALTH, 10
- De Busser B, Roth L, De Loof H. (2025). The role of large language models in self-care: a study and benchmark on medicines and supplement guidance accuracy. International Journal of Clinical Pharmacy, 47(4), 1001–1010
- Grossman S, et al. (2024). Appropriateness of ChatGPT as a resource for medication-related questions. British Journal of Clinical Pharmacology, 90(10), 2691–2695


