
很多人會想到,AI能讀取更多生理訊號,測謊就會更準。但模型辨認的是心跳、呼吸等反應,還是經驗證、能指向欺瞞的訊號?美國國防部推動的 Polygraph+ 將 AI 評分與新型感測納入可信度評估研發;目前公開資料仍不足以證明它能降低誤判。評估這類工具,須逐段檢查感測、模型推論和後續決策,不能只看準確率。
一、Polygraph+正在改變測謊流程的哪個環節?
Polygraph+嘗試把 AI/機器學習評分與非接觸式生理感測帶入可信度評估,現階段公開資訊指向研發與原型,並未證明它已成為可廣泛部署的測謊產品。
傳統測謊器記錄呼吸、心血管活動與皮膚電反應,再由受訓人員判讀。DIU公告回述,國防部相關單位在2023年與DIU合作公開徵案,選出 Presage 與 Altec 探索新型生理感測。
公告將這項工作稱為原型開發,並說明後續仍須驗證及符合部署標準;用途則以「可信度評估」描述。DIU 公告
TechNews於2026年9月報導,五角大廈預算文件提出五年約3,030萬美元的 Polygraph+/Polygraph Next 經費構想,2027財年的申請尚待國會審議。
這是研發規劃,不能證明系統已部署或通過獨立驗證。TechNews報導
研發原型、驗證與實際部署是不同階段
原型能讀出心率或呼吸變化,只能說明感測器取得了訊號。還要確認訊號在不同環境是否穩定、模型能否在獨立資料重現結果,以及它在訪談或安全審查中是否有用。原型展示不能直接換算成「AI會測謊」。
「測謊」一詞容易讓人以為系統直接觀察到謊言。實際上,它從身體或行為訊號推算可信度分數;分數的用途、門檻和後續處置仍須驗證並公開。
二、為什麼多讀訊號仍不等於判斷說謊?
不能。感測器能讀出身體反應,模型能從資料中辨認模式,但緊張、恐懼、疲勞或環境壓力也可能造成生理變化,訊號與欺瞞之間的關聯必須另外驗證。
測謊推論有三層:感測器取得資料、演算法分類資料、使用者把分數解讀為可信度。量測準確不代表模型找到欺瞞模式;分類一致也不代表分數適合用來決定錄取、續聘或調查。
美國國家研究委員會(National Research Council)2003年回顧指出,測謊反應的心理與生理歷程尚未充分理解;誠實受測者也可能因情境等因素出現類似反應。特定研究結果不易直接推廣到不同場景或族群。報告執行摘要
AI可能協助擷取訊號、統一評分或找出資料模式,但這些屬於資料處理能力。若訓練標籤把緊張當作說謊,模型可能更一致地複製錯誤;少數族群資料不足,也可能使正常差異被視為異常。因此仍須檢查標籤品質與判斷效度。
「測謊篩檢若要使用,陽性結果應觸發詳細的後續調查,不應單獨作為人事處分的依據。」— 美國國家研究委員會《測謊與測謊偵測》執行摘要(2003)
三、怎麼驗證AI有沒有減少誤判?
至少要同時檢查敏感度、特異度、假陽性、假陰性與基準率,並以獨立資料比較 AI、人工評分和既有流程。單獨報告整體準確率,無法顯示錯誤落在誰身上、會造成什麼後果。
第一步是界定使用場景。針對已發生事件的調查、求職篩檢與大規模安全審查,受測者、問題內容、真值來源和犯錯代價都不同。若要判斷一個模型能否協助特定場景,研究應先寫清楚它要預測的結果、預定使用人群、何種結果算陽性,以及陽性後會採取什麼行動。模糊的「可信度」若沒有可重複的定義,就很難建立可信的標準答案。
第二步是檢查兩種方向的錯誤。假陽性是把誠實者判成有欺瞞,可能使求職者、受雇者或接受安全篩檢的人遭到額外盤查、失去資格或工作;假陰性則是漏掉真正需要調查的事件。降低其中一種錯誤,可能增加另一種,決策者需要公開門檻與取捨,而不是用一個總分帶過。
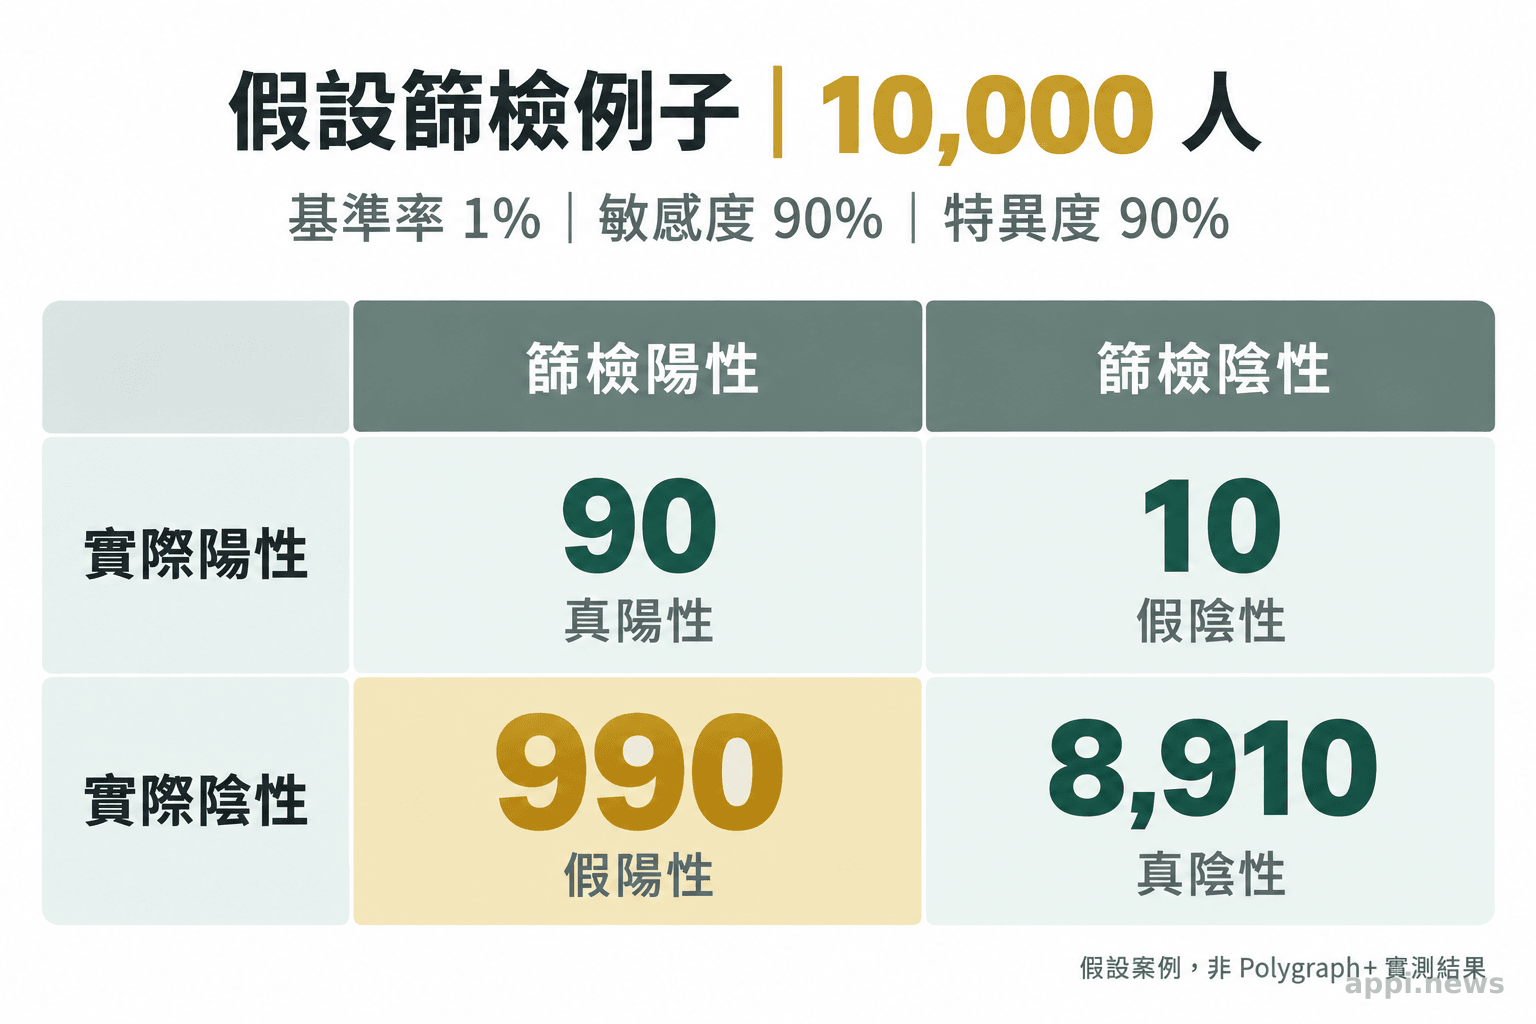
基準率會改變陽性結果的意義。以下是假設例子,並非 Polygraph+ 實測:一萬人中若只有百分之一符合目標,模型敏感度與特異度各九成,約有90名真陽性,也會有990名假陽性。陽性者中真正符合目標者約8.3%。因此低盛行率篩檢即使指標不差,陽性結果仍可能多數是誤報;數值會隨族群、場景和門檻改變。
第三步是外部驗證。測試資料應獨立於訓練資料,並涵蓋不同時間、設備、地點與族群。若實驗室結果無法在現場重現,就不能推論實際效益。AI版本也應與傳統儀器、人工判讀及現行流程比較,確認新增技術是否帶來增益。
四、通過模型測試後,還要檢查哪些治理條件?
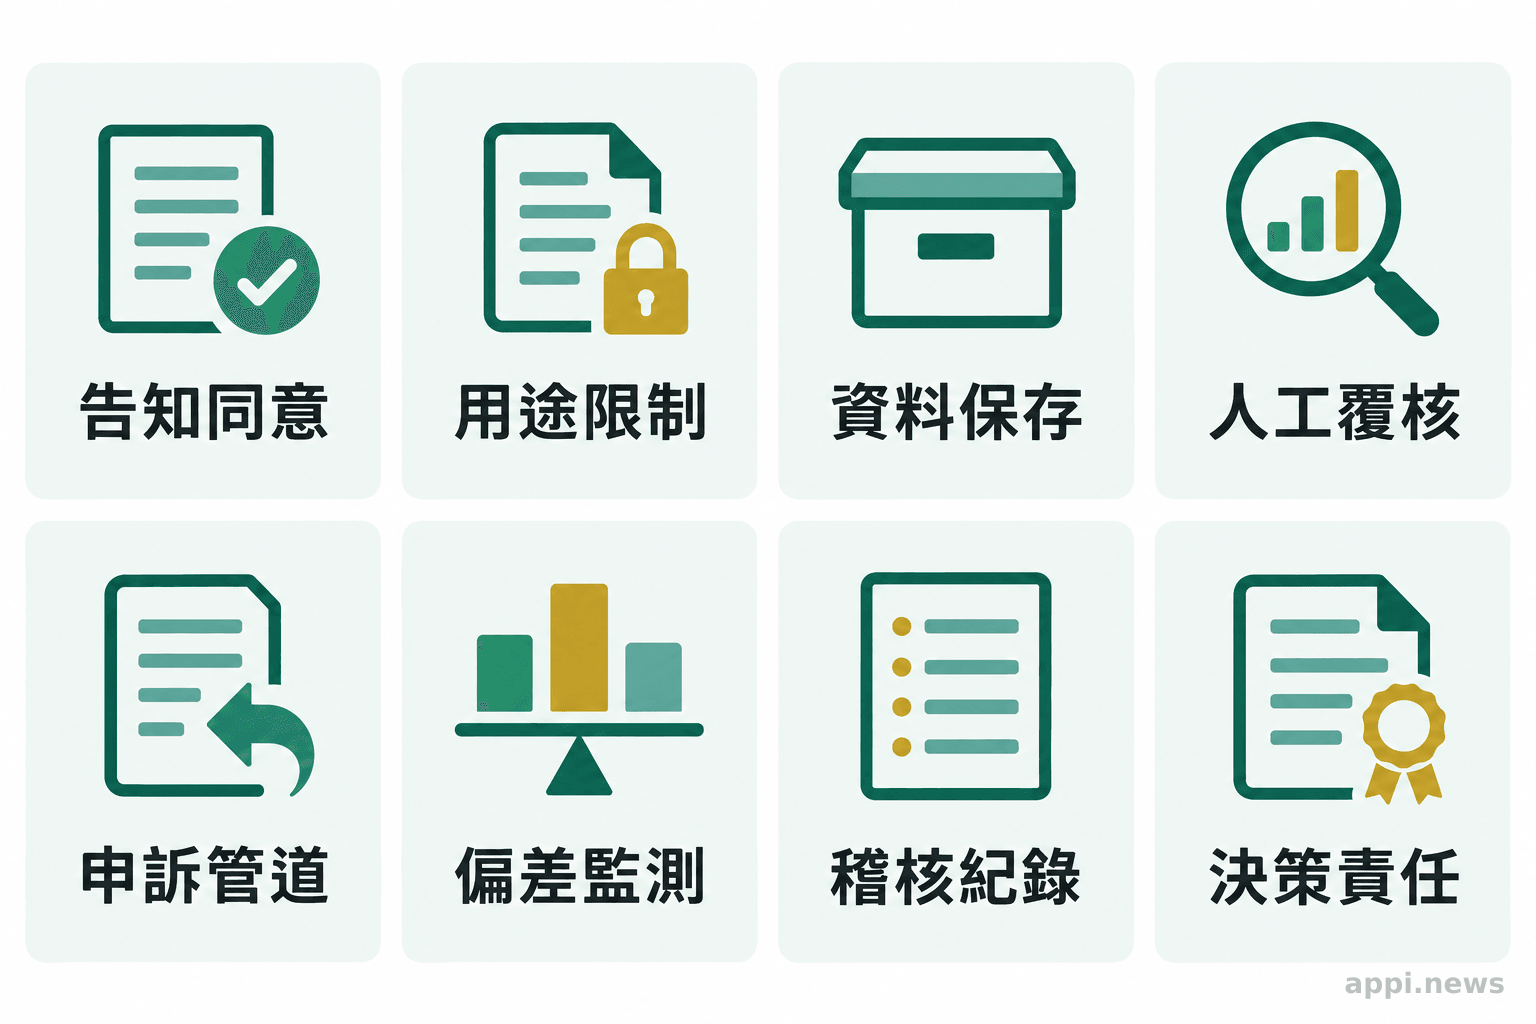
在獨立證據和適用範圍尚未充分建立前,不應把單一分數當成欺瞞事實或單獨決策依據;使用單位還需提供人工覆核、資料治理、申訴管道與責任歸屬。
這類系統可能影響工作、資格與調查待遇。告知程序應說明蒐集資料、用途、存取權限、保存期限,以及結果是否影響人事決策。若資料含影像或生理訊號,也要交代二次利用、分享和刪除規則,並說清分數如何進入決策流程。
人工覆核者應了解模型限制、錯誤率與不確定性,也能要求補證或推翻分數。受測者應可查詢不利結果依據、提出申訴及要求重審;使用單位須留存稽核紀錄,追蹤群體差異,並在表現惡化時暫停或調整系統。
模型供應者應揭露測試條件和限制,部署單位確認用途與流程,決策者對行動負責。若缺乏可檢查理由、申訴方式或責任歸屬,即使測試表現良好,也不適合直接投入人員篩檢。
- Polygraph+公開資訊描述的是 AI 評分與新型感測的研發方向,不能視為已證實有效的測謊產品。
- 讀得更細或評分更一致,不等於能可靠判斷欺瞞;關鍵是訊號和欺瞞之間是否經過獨立驗證。
- 評估時要看假陽性、假陰性、基準率、外部效度及相較既有流程的增量效益。
- 影響工作或資格的結果,需要人工覆核、資料治理、申訴機制和明確責任,不能只靠單一分數。
五、常見問題:AI測謊目前能用來做什麼?
現有公開資料不足以支持把 Polygraph+ 分數當成已證實的說謊證據。較合適的評估方式,是先確認它在特定流程中能否提供可重現的輔助訊號,再決定是否進入更高風險的用途。
常見問題
Q1:Polygraph+已經正式投入使用了嗎?
DIU公開的是原型研發與驗證方向;TechNews報導的後續經費屬預算申請構想。這些資料本身不能證明系統已完成部署或取得獨立驗證結果。
Q2:非接觸式感測比傳統測謊更準嗎?
非接觸感測改變資料取得方式,可能增加使用便利性,但仍需分別驗證量測穩定度、模型判讀能力和現場效度。感測方式較方便,不會自動提高欺瞞判定的正確性。
Q3:評估這類系統時,最值得先問什麼?
先問測試的目標場景與真值怎麼定義,再看是否有獨立測試資料、不同族群的錯誤率、基準率下的陽性預測值,以及人工覆核和申訴安排。若只看到整體準確率或展示影片,還無法判斷系統是否適合實際決策。
Q4:Polygraph+若未來通過模型測試,可以自動淘汰求職者嗎?
模型通過特定測試,只能支持它在該測試條件下的表現;是否適用於求職篩選,仍要另行檢視族群差異、錯誤代價、資料治理與法規責任。涉及資格或工作權益時,應保留可理解、可申訴且由人員負責的決策流程。


