中醫與科技業者合作量化舌象,公開進展到哪一步?
三立新聞網以「讓AI學會看舌頭」描述馬光與友達耘康的合作方向,報導內容指向舌象量化及AI判讀探索。公開資訊未交代可供獨立評估的臨床驗證設計、跨院結果或核准狀態;目前可確認的是合作方向,不能據此判定診斷效能。原報導
報導呈現的是合作探索如何量化舌象,尚不足以判定AI的臨床效能。後續應查看公開資料是否交代系統用途、資料來源、驗證方式與結果。
舌診包含對舌質、舌形與舌苔等表徵的觀察。數位化後,研究者可以把部分影像特徵轉成可記錄、比較的資料,進一步測試演算法是否能辨識特定特徵。這是把經驗轉為可檢驗問題的一步,但「看見某項特徵」與「由特徵推得證型或疾病」是不同層次的任務。
目前報導沒有提供臨床驗證設計、跨院測試結果或主管機關核准資訊。合作對象、設備、模型性能與臨床應用情境若未見於報導,就不宜自行補寫;後續若有研究公開,還要確認受試者如何選取、參照標準由誰制定,以及測試資料是否獨立於訓練資料。
舌象如何從影像變成可重現的資料?
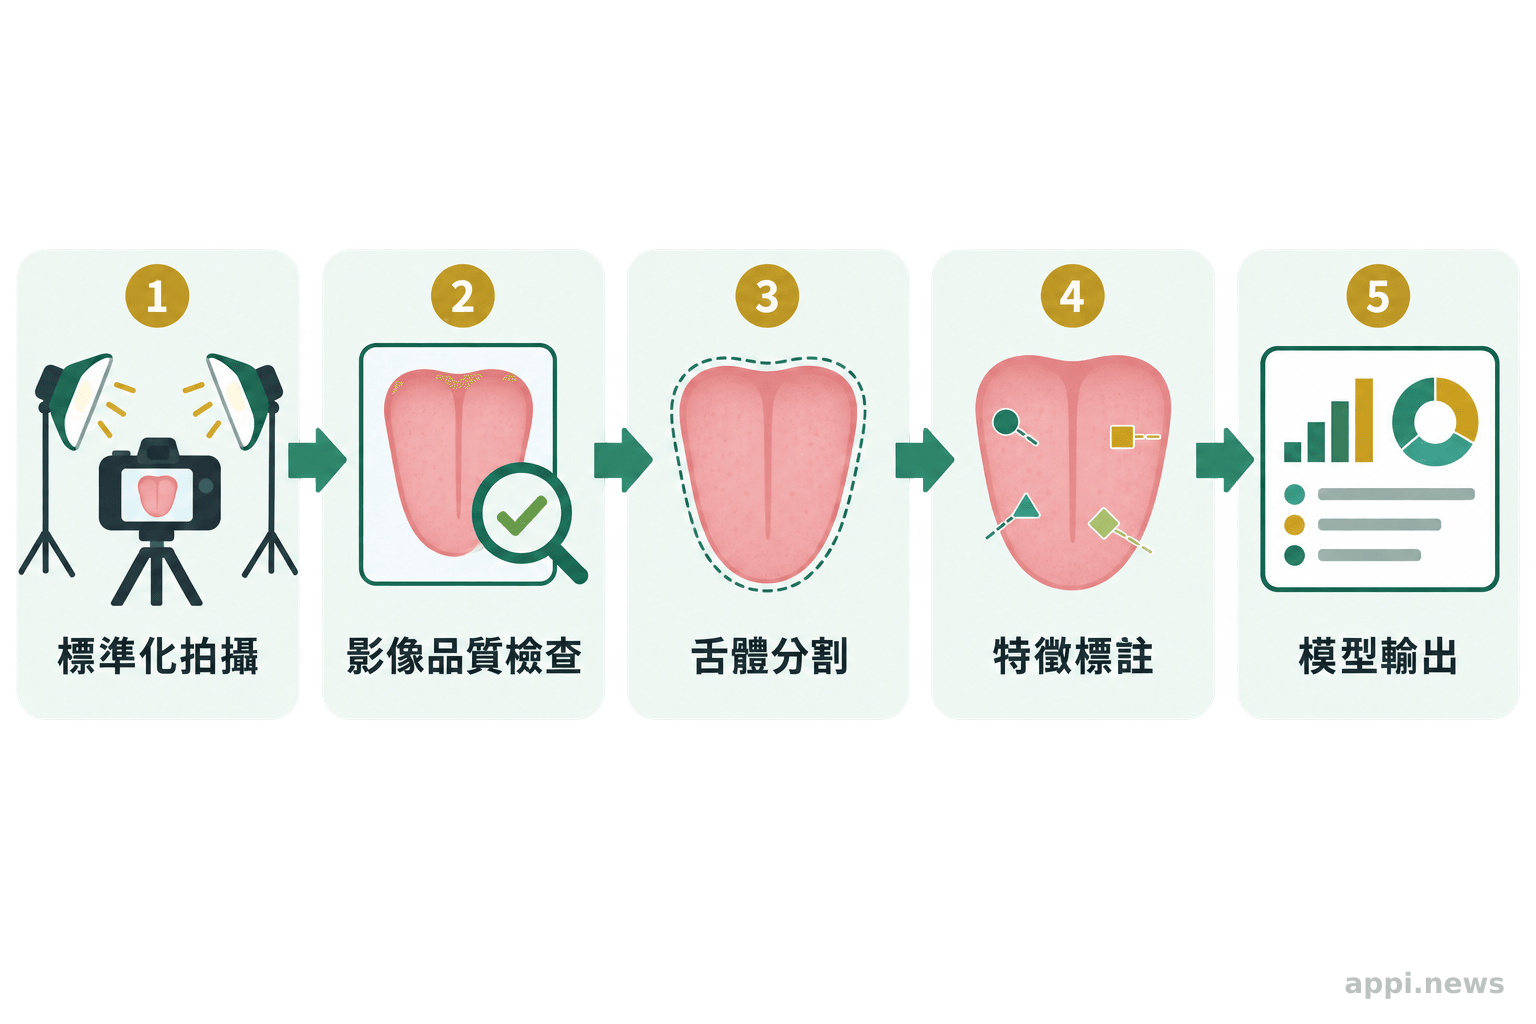
影像須在可控制或可記錄的拍攝條件下取得,再以一致流程定位舌體、校正顏色並標註特徵。若設備、光源或標註標準改變,模型結果可能也會改變。
相機感光、白平衡、曝光、光源色溫與環境反射都會影響照片顏色。拍攝距離、角度、舌頭伸出程度與影像清晰度,也會改變模型取得的資訊。若同一人的舌象在不同手機或診間設備上呈現不同色調,模型可能把設備造成的差異當成舌色特徵。研究因此需要規定拍攝條件,或記錄設備資訊,並測試影像品質不足時系統會不會拒絕判讀。
影像取得後還要決定舌體邊界如何切分、舌苔厚薄或裂紋如何定義,以及標註由誰完成。若多位標註者對同一張影像意見不同,資料集本身就有不確定性;模型即使能重複輸出,也可能只是穩定複製標註偏差。研究應揭露標註規則、標註者背景與一致性檢查,讓讀者知道模型學到的標籤是怎麼形成的。
Zhao等人於2023年回顧舌象AI研究,涵蓋影像校正、偵測、分割及分類,並指出資料集建置與效能評估可靠度是此領域的重要問題。這表示單一資料庫中表現良好,仍不足以說明模型在不同設備、院所或族群中都能維持相同結果。研究回顧
「舌象AI研究仍面臨資料集建置與效能評估可靠度的問題。」(Zhao等人,2023年研究回顧,原文意譯)
AI舌診的判讀如何做到可解釋?
系統應清楚標示輸出對應的任務,呈現依據與不確定性,並保留醫療人員核對、修正或不採用結果的空間。顯示一個分類標籤或信心分數,並不等於解釋了診斷理由。
影像分類研究可能只回答「照片較符合哪一類舌象」,而中醫辨證還需結合望、聞、問、切及個人狀況。若模型只使用舌頭照片,它就無法從照片取得脈象、症狀描述、病史或用藥等資訊。把「辨識舌苔或舌色」直接寫成「完成辨證」,會把模型實際完成的影像任務擴大成完整臨床判斷。
可解釋性也需要具體檢查。開發者可以說明影像哪些區域影響輸出、模型依據哪些特徵分類,以及低品質影像或置信不足時如何處理。這些說明仍須經驗證:熱區圖可能看起來合理,卻不能單獨證明模型使用了醫療上有效的依據。醫療人員應能檢查原始影像和輸出理由,辨認不適用情境,並將模型結果與病人完整資訊放在一起判讀。
一項2024年單一醫療中心研究使用623名患者的舌頭影像,建立正常舌與四類舌病變分類資料集,測試卷積神經網路辨識效果。研究任務是特定舌病灶的影像分類,資料取自單一醫療中心,並採五折交叉驗證;這仍不能替代跨院外部驗證。作者認為未來仍有臨床應用潛力,因此結果不能直接代表中醫證型判讀或其他族群的診斷效能。Tiryaki等人研究
台灣醫療AI要通過哪些驗證關卡?
驗證應從預期用途開始,明確界定使用者、適用族群、設備與臨床情境,再以合適的參照標準評估安全性與效能。還應檢視是否有外部測試,並依預期用途判斷其必要性與設計。
本文引用的是食藥署109年9月版AI/機器學習醫療器材軟體技術指引;該指引於110年修正,食藥署也在2025年修正CADe/CADx醫療器材查驗登記技術指引。這些技術指引提供特定產品類型的送件資料參考,不代表所有舌診AI都適用同一套固定關卡。產品是否屬醫療器材及適用要求,須依預期用途、實際功能與宣稱,對照現行分類分級規範判斷。可先釐清產品提供影像整理、輔助辨識,還是會影響診斷或治療決策的功能。食藥署CADe/CADx指引修正公告 食藥署技術指引 PDF
該技術指引列出的申請資料項目包括產品預期用途、效能、適應症、禁忌症及使用限制,以及目標功能值與性能規格。對照個別產品適用的現行規範,這些資訊可協助使用者與審查者確認測試項目是否涵蓋其預定用途。
評估驗證資料時,可依序確認:
- 用途是否明確:系統辨識舌象特徵、口腔病變,還是提供臨床決策支援?宣稱應符合測試內容。
- 參照標準是否合理:標籤由誰判定、判讀者是否一致,參照標準是否符合預定用途。
- 測試資料是否獨立:訓練與最終測試資料應避免重複,並說明來源及適用族群。
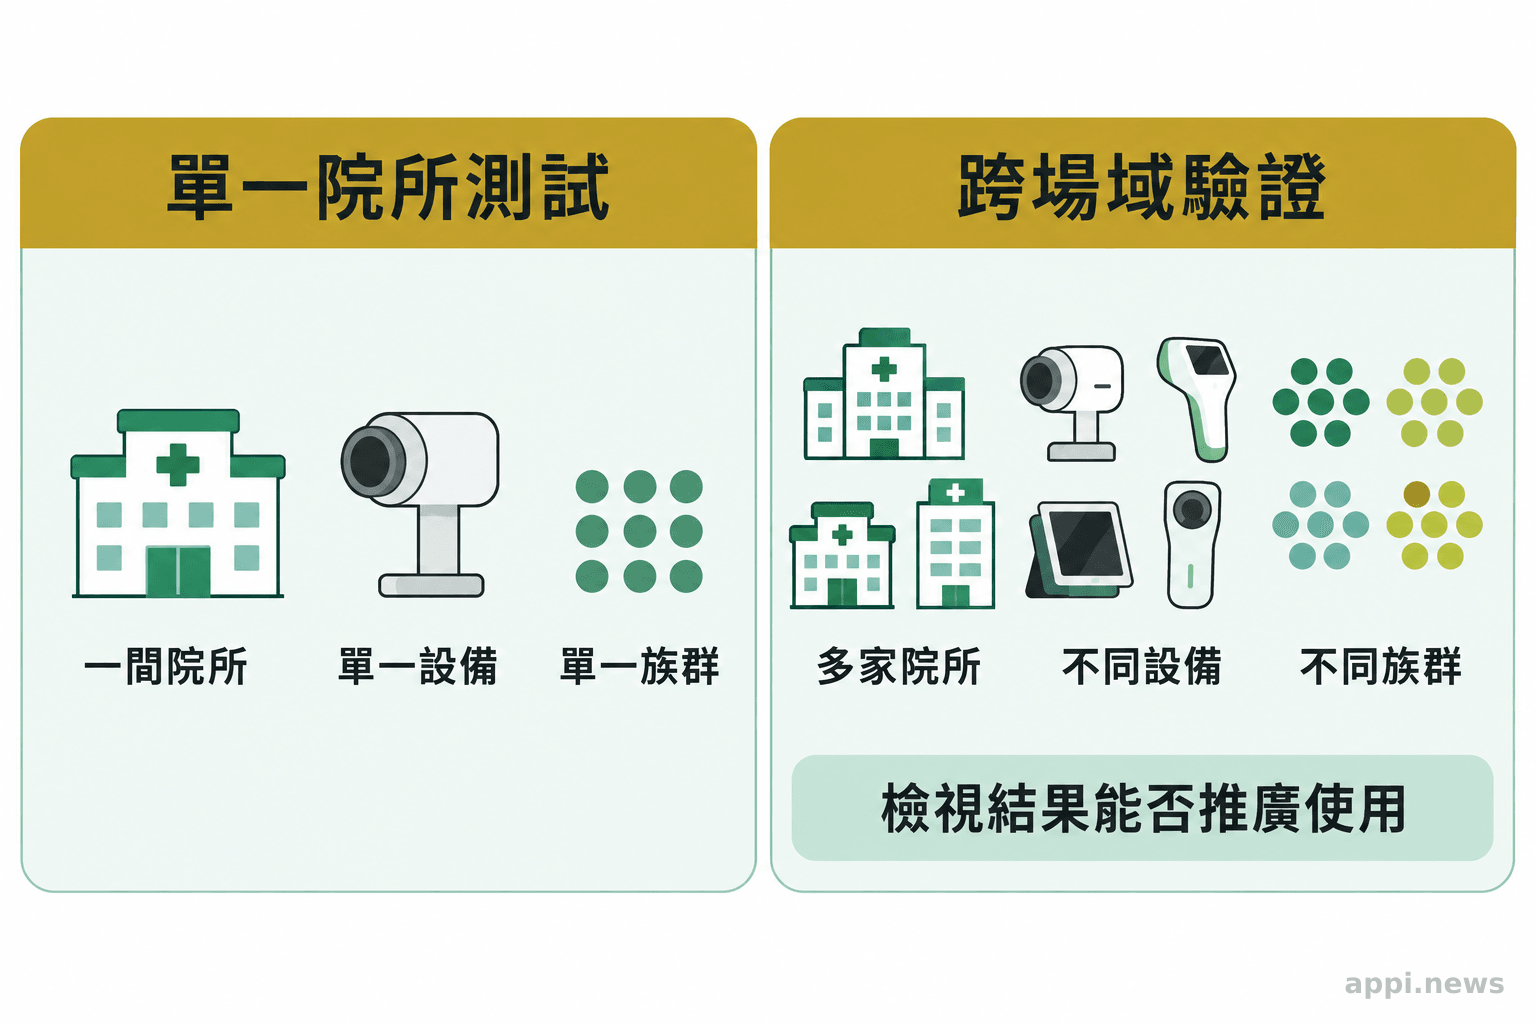
- 外部驗證是否符合用途:檢視是否有跨院所、設備或族群測試,再依預定用途判斷測試範圍與設計是否足以評估模型在原開發環境以外的表現。
- 限制與責任是否清楚:確認低品質影像、特殊族群及不確定輸出如何處理,以及由誰作最後判斷。
衛福部臨床AI取證驗證中心指出,許多模型以數百至上千筆樣本訓練,進入實際臨床場域後準確率可能下降;中心推動以跨體系、跨層級醫院資料進行外部驗證,檢視模型的適應性與一致性。這是該中心說明的驗證需求,個別模型仍須依其用途和測試結果判讀。臨床AI取證驗證中心
讀者如何判斷舌診AI目前能做什麼?
先看服務公開的預期用途、驗證資料、適用限制與醫療人員角色,再確認其說明是否超出研究實際測試的範圍。若只有展示畫面或準確率數字,卻未交代資料與測試方式,證據仍不完整。
可留意幾項資訊:模型使用何種設備拍照、資料來自哪些人與場域、由誰判讀參照標準、測試是否有外部資料、錯誤類型和不適用情況是否揭露,以及產品是否取得與宣稱用途相符的許可。若公布百分比,還要問它代表準確率、敏感度或其他指標,測試樣本如何選取,以及結果能否適用於實際使用者。
舌象模型輸出不應單獨成為用藥、停藥或治療決策。孕婦、兒童、慢性病患者與長期服藥者若有健康疑慮,尤其不宜依照片分類自行改變治療安排;應由合格醫療人員結合症狀、病史、檢查與用藥情況評估。舌診AI若提供個人健康判斷,也應明確交代人工覆核方式與何時需要進一步就醫。
對讀者來說,最實用的區分是把「影像特徵辨識」「研究中的模型輸出」和「經適當驗證、符合規範的臨床用途」分開看。中醫舌診數位化可以提升部分觀察的可記錄性,但其價值仍取決於資料能否重現、模型能否解釋限制,以及臨床效能是否經獨立驗證。
- 舌象量化可將部分影像特徵轉成可比對資料;特徵辨識與中醫證型診斷屬不同任務。
- 設備、光線、標註方式及資料代表性都可能改變模型表現。
- 使用者應查看預期用途、外部驗證、限制與人工覆核方式,不依模型輸出自行用藥或停藥。
常見問題
Q1: 舌診AI可以取代中醫師嗎?
目前提供的研究方向與影像分類結果,不能證明AI能取代中醫師。完整診療需結合舌象以外的症狀、病史與檢查資訊,模型輸出應依其驗證用途由醫療人員判讀。
Q2: 研究公布準確率,代表能在診間使用嗎?
單一準確率數字不足以判斷。還要看研究任務、參照標準、測試資料是否獨立、參與者與使用設備是否符合預定情境,以及模型錯誤時如何處理。
Q3: 同一張舌象用不同設備拍,結果會相同嗎?
不能預設相同。相機、光源、曝光與色彩處理可能影響影像。開發者需測試跨設備表現,並說明適用的拍攝條件。
Q4: 如何知道模型適用哪些人?
查看公開研究或產品文件中的納入族群、排除條件、測試場域與限制。孕婦、兒童、慢性病患者及長期服藥者不應依舌象模型輸出自行調整治療,應由醫療人員評估。
參考來源
- Zhao Y, et al. (2023). A survey of artificial intelligence in tongue image for disease diagnosis and syndrome differentiation. *Digital Health*, 9
- Tiryaki B, et al. (2024). Artificial intelligence in tongue diagnosis: classification of tongue lesions and normal tongue images using deep convolutional neural network. *BMC Medical Imaging*, 24(1), 59
- 衛生福利部食品藥物管理署(2020,109年9月版)。人工智慧/機器學習技術之醫療器材軟體查驗登記技術指引
- 衛生福利部臺灣智慧醫療三大中心(2025)。臨床AI取證驗證中心
- 三立新聞網。中醫與科技業者合作量化舌象報導