
很多人第一個會先想到,AI 搜尋摘要列出來源連結,使用者就能點進去核對。更前面的問題是:當系統把多個網頁內容拼成一句新的事實陳述,誰控制這段文字、誰能檢查它,錯誤出現後又由誰處理?德國慕尼黑與亞琛兩起法院案件,讓這些問題進入產品責任的實際討論。
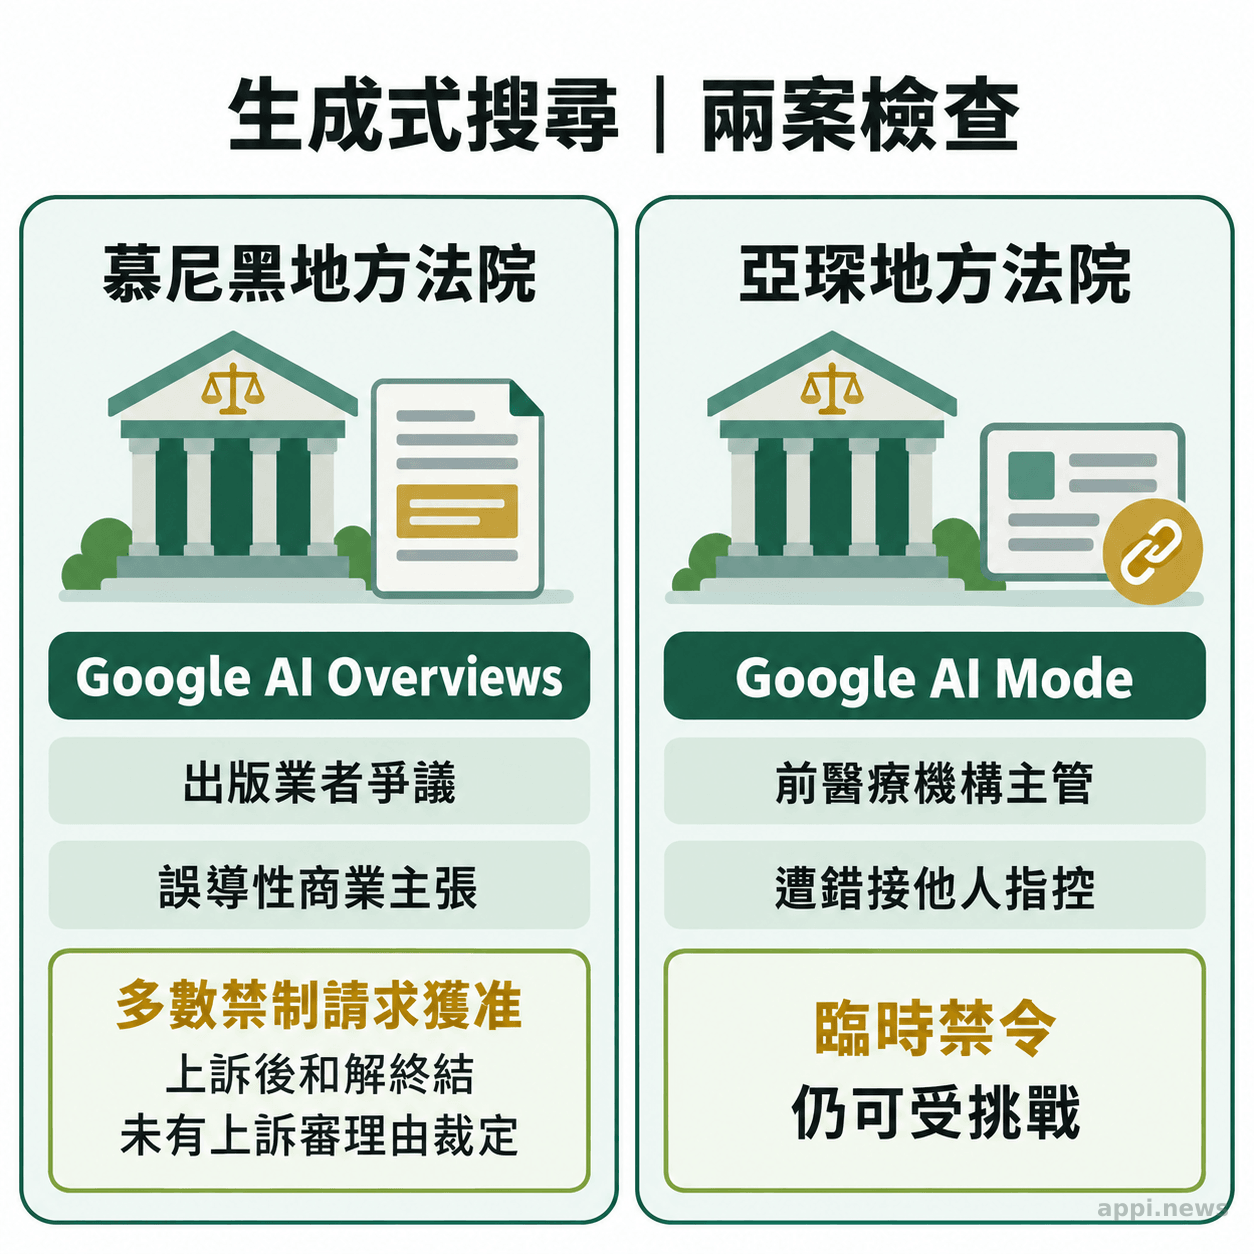
兩案都涉及 Google 生成式搜尋,但產品功能、當事人與程序各不相同。慕尼黑地方法院第一庭處理的是 AI Overviews,亞琛地方法院的臨時禁令則涉及 AI Mode。它們提供產品團隊檢視風險的線索,尚不足以代表所有生成式摘要、所有平台或台灣法律都採取相同標準。
一、慕尼黑與亞琛法院各自處理了什麼?
慕尼黑案認為特定 AI Overview 可歸責於 Google,亞琛案則以臨時禁令禁止特定 AI Mode 錯誤指述繼續散布。兩案的理由相近,但涉及不同產品與事實,程序結果也不相同。
慕尼黑地方法院第一庭於 2026 年 5 月 28 日處理兩家出版業者的聲請。爭議摘要在特定搜尋中,把出版業者與詐欺手法、可疑營業方式、訂閱陷阱等描述連在一起,也混入原始來源未指向該業者的內容。法院准許大部分禁制聲請,禁止 Google 在該案範圍內散布列明的相關說法;其餘部分則駁回。
法院的核心區分在於呈現形式。傳統搜尋結果主要列出第三方網頁,AI Overview 則將檢索內容重新組織成一段可以獨立閱讀的說明。判決要旨指出,這些摘要並非單純搜尋結果,而是搜尋引擎業者「自身且可歸責的內容」(德文原文:eigene, ihr zurechenbare Inhalte)。法院據此認為,不能直接用傳統搜尋引擎處理第三方內容的責任方式看待該案摘要。
「Bei KI-generierten Übersichten einer Suchmaschine handelt es sich nicht um bloße Suchergebnisse, sondern um eigene, der Suchmaschinenbetreiberin zurechenbare Inhalte.」【搜尋引擎生成的 AI 摘要並非單純搜尋結果,而是可歸責於業者的自身內容。】— 慕尼黑地方法院第一庭判決要旨(原文節錄)
這項判斷不是對所有 AI 生成內容一概而論。判決處理的是具體業者、具體輸出、具體權利主張和德國法下的個案。案件之後進入上訴程序,雙方以和解結束,慕尼黑高等法院沒有就原判決的法律推理作成裁判。巴伐利亞邦官方裁判資料庫也註明,該案因和解終結,原判決不再具有案件效力。這使得判決理由仍可供觀察,但沒有上級法院確認其法律見解。
亞琛案則是另一種傷害。根據法律專業媒體 beck-aktuell 報導,Google AI Mode 把一名醫療機構前主管與另一人涉及的刑事指控、程序及工作處分錯誤連結。亞琛地方法院於 2026 年 9 月 24 日作出臨時禁令,禁止 Google Ireland Limited 透過 AI Mode 繼續散布特定錯誤主張。法院認為相關內容侵害當事人的一般人格權,並採納慕尼黑案的部分推理。
這裡須把產品名稱分清楚:慕尼黑案是搜尋頁面的 AI Overviews,亞琛案是互動式 AI Mode。兩案不是同一功能的重複測試,也不能把亞琛命令寫成終局判決。臨時禁令屬於緊急程序中的救濟,仍可能受到挑戰。亞琛裁判有一份 14 頁 PDF 副本可由 The Decoder 報導連結至西發利亞 ITM 網站查閱;它不是法院裁判資料庫的公開頁面,因此程序後續仍應以法院資料為準。
二、來源連結為什麼不足以回答責任問題?
來源連結能協助追查資訊來自何處,卻不能單獨證明每一句生成文字都受到來源支持。責任問題還要看摘要形成了什麼新主張、平台如何呈現它,以及平台能否核對和更正。
搜尋結果列表通常讓使用者看到多個頁面標題、摘要片段和連結,判斷工作主要留給讀者。生成式摘要把檢索到的片段重寫為連貫回答,讀者看到的則是經過系統選擇、組合與措辭的一段話。當答案以肯定語氣呈現,即使旁邊有來源,讀者也可能先把摘要當作平台提供的答案。
慕尼黑法院特別關注摘要是否能脫離來源而獨立理解。判決資料記載,AI Overview 的一些表述並未出現在被連結的搜尋結果中,且把其他公司的資訊錯接到申請人身上。若來源只涵蓋相鄰資訊,答案卻加入人物或企業之間的關係,連結本身就無法補足那段未受支持的主張。
錯誤的形成往往跨越多個環節。檢索可能找到同名人物、同一機構的不同成員或主題相似但對象不同的頁面;摘要生成再把時間、角色、因果或歸屬關係接在一起。當系統把「頁面提到甲」轉成「甲做了某事」,來源段落可能真實存在,新的主張卻是系統組合出來的。這也是為什麼只檢查網址是否存在,無法完成內容查核。
產品的控制權也會影響風險管理。團隊通常能調整檢索範圍、生成模板、引用呈現、拒答條件與回報管道。可控制的環節越多,就越需要問:哪些主張可以逐句對來源驗證?哪些情況會把相似姓名誤認為同一人?收到有證據的異議後,誰能找到當時的輸出與資料版本?這些屬於產品風險檢查問題,並不等於已由法院替所有產品設定同一套法定流程。
三、產品設計要納入哪些責任檢查點?
先把摘要中的事實主張拆開,逐項確認來源支持、人物身分與語氣強度,再保留可追查的輸出紀錄和更正路徑。連結呈現是其中一環,不能代替主張核對。
第一個檢查點是「主張對來源」。不要只問生成回答引用了幾個網址,還要把答案拆成能被判真偽的句子,確認每句話由哪個來源支持、來源是否指向同一對象、日期和脈絡是否吻合。若來源只證明「曾被調查」,摘要不可自動改寫成「已遭定罪」;來源談的是另一家機構,也不應因名稱相近而套用到目標對象。
第二個檢查點是人物、企業和機構的識別。人名相同、職稱相同或任職單位相同,都不代表是同一個人。涉及刑事、職業操守、健康或財務等可能造成重大名譽與決策影響的主張,可以設定更嚴格的交叉核對條件;來源彼此矛盾、身分資料不足或無法確認時間順序時,降低答案確定度、保留原始來源差異,必要時不生成結論。
第三個檢查點是呈現主張與證據的關係。引用標記應貼近它實際支持的句子,避免讓一個泛用來源按鈕看起來像替整段內容背書。對使用者而言,最好能看出答案採用哪些來源、來源支持哪個部分,以及哪些細節仍有不同說法。若產品將推論或摘要加入來源原文沒有的資訊,應透過語氣或界面清楚區分,避免把推論包裝成來源直接記載的事實。
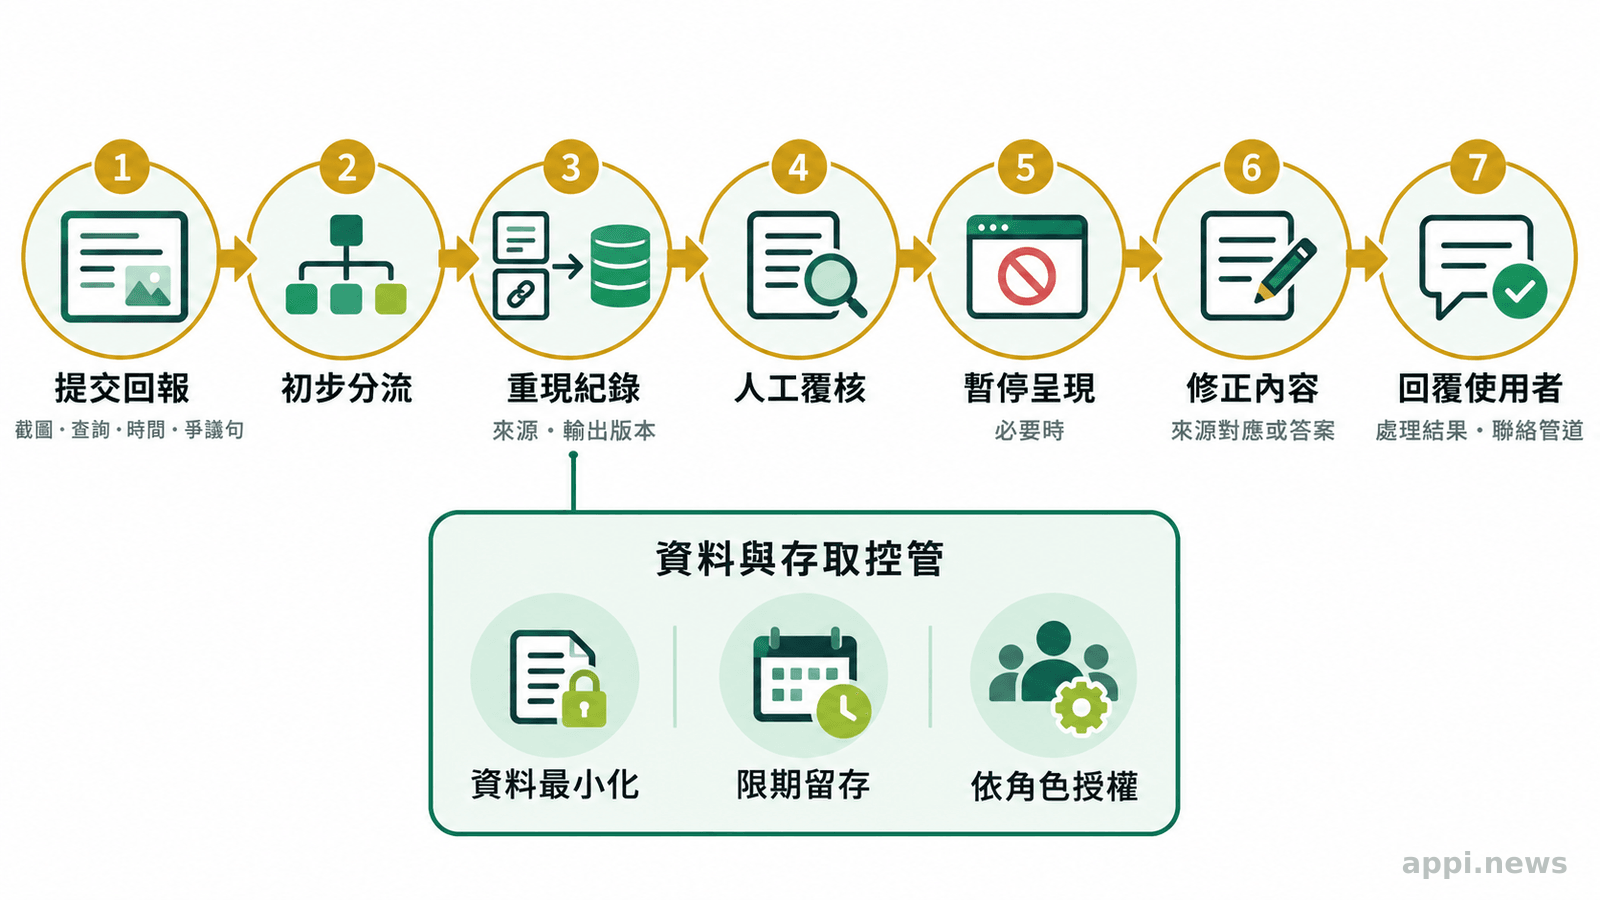
第四個檢查點是留存與申訴。發生爭議時,團隊需要定位使用者看到的確切文字、查詢情境、引用連結、檢索內容版本和產品版本。這些資料可以協助重現錯誤、判斷問題發生在檢索、實體識別、排序或生成哪一環。留存範圍也要符合資料最小化、保存期限與存取權限要求,不應為了追查而無限制保存使用者查詢或個人資料。
申訴入口應要求足以找到問題的資訊,例如畫面截圖、查詢詞、出現時間和被影響的句子;不必要求申訴者先理解內部模型流程。收到涉及錯誤人物指述或可驗證事實的回報後,可安排人工覆核,並有能力暫停特定答案、移除錯誤片段、修正來源映射或阻止相同錯誤重複出現。處理完成也要告知申訴者結果和後續聯絡方式。
四、如何把判決轉成上線前與申訴後的檢查?
可把高影響事實、人物辨識、來源落差與錯誤回報分成測試案例,並為每一類指定負責角色和處理結果。這是產品治理建議,並非德國法院命令所有搜尋服務採用的技術規格。
測試案例要從可能造成實際損害的情境開始,例如把兩位同名者混為一人、把同一機構不同成員的經歷互換、把尚未裁定的指控寫成確定犯罪、把舊資料當成現況,以及把來源中的推測改成肯定陳述。每個案例都應記錄正確答案應如何呈現、哪些資料足以支持答案、出現矛盾時系統該如何降階或拒答。
團隊可採用一份精簡的檢查表:
- 列出可驗證主張:拆解回答中的人物、事件、時間、因果與定性語句。
- 逐句對照來源:確認來源談的是同一對象、相同時間範圍,且確實支持原句。
- 標記未支持部分:把模型補出的推論、衝突資訊或來源空缺標示出來,必要時刪除或降低確定度。
- 確認重現能力:保存足以定位問題的輸出、來源與版本資訊,並限制保存範圍和存取權限。
- 演練申訴處理:確認回報能進入覆核、暫停、修正及回覆流程,並留下責任人和處理紀錄。
責任分工同樣重要。產品負責人決定什麼情況顯示摘要、引用怎麼呈現,以及何時暫停功能;搜尋與資料團隊處理檢索、去重和實體識別;模型或應用工程團隊追查生成錯誤與版本差異;信任安全或客服團隊接收回報並推進個案;法務則針對適用法域、權利衝突和正式回應提供審查。若每個部門只處理自己看得到的一小段,申訴可能在交接時失去脈絡。
這套檢查不保證摘要永不出錯,也不能把個案法律責任化約成工程問題。它的用途是讓產品團隊更早看見高風險輸出,並在當事人指出具體錯誤時,能追到資料與決策的來源。對使用生成式搜尋的企業或媒體而言,也可檢視合作服務是否有可用的錯誤回報管道、修正時效說明與案件聯絡窗口。
五、德國個案對其他市場的適用界線
目前不能這樣推論。慕尼黑案在上訴後以和解結束,亞琛案是仍可受挑戰的臨時禁令;兩案只能說明德國法院在特定事實下如何看待生成式搜尋內容與平台控制權。
慕尼黑官方裁判資料顯示,法院依德國民法與人格權相關規定處理企業名譽受侵害的爭議,並針對特定輸出核發禁制命令。此案雖然有完整裁判理由,雙方後來和解,使其沒有經高等法院審理並形成上級裁判。亞琛案的資訊則來自法律專業媒體對臨時程序的報導,完整裁判尚未公開可查。兩個程序狀態都應與「已確立普遍法則」區分。
此外,台灣產品仍需依產品服務對象、使用方式、內容類型、平台角色與適用法規評估。德國法院如何處理人格權、平台責任或搜尋服務的特殊性,不能直接轉成台灣法律結論。產品團隊可將兩案作為風險盤點素材,再由熟悉相關法域的法律專業人員判斷實際義務與因應方式。
較早的 #1429 討論 Google 如何調整 AI 搜尋結果中的來源連結介面,焦點在來源呈現。這次案件多了一層責任問題:生成文字是否形成平台自己的陳述,以及錯誤內容如何查核與申訴。兩者相關,但介面加上來源連結並不能自動回答後一個問題。
對產品團隊而言,眼前可做的工作很具體:挑選會指涉特定人物、企業或可驗證事實的生成答案,逐句核對來源是否真正支持原文,接著演練錯誤回報後能否定位、覆核與修正。法律結論須看適用法域與案件事實;產品則可以先確認自己是否有能力說明答案如何生成、證據在哪裡,以及錯誤發生後由誰處理。
- 慕尼黑案涉及 AI Overviews,亞琛案涉及 AI Mode;兩案功能與程序不同。
- 來源連結不能取代逐句核對,尤其要檢查人物身分、時間與來源是否支持主張。
- 留存可重現的輸出與來源資訊,並建立人工覆核、更正和申訴路徑。
- 德國個案提供風險評估線索,不能直接當成台灣或其他市場的法律結論。
「Google kann sich nicht hinter einem Algorithmus verstecken.」【Google 不能躲在演算法背後。】— 當事醫療人員代理律師 Carsten Brennecke(beck-aktuell 報導引述)
常見問題
Q1: 慕尼黑法院判決已經確定了嗎?
沒有。Google 提起上訴後,雙方以和解結束爭議,慕尼黑高等法院沒有就原判決的法律理由作成裁判。巴伐利亞邦裁判資料庫記載該案因和解而終結。
Q2: 亞琛案和慕尼黑案是同一種 Google AI 功能嗎?
不是。慕尼黑案涉及搜尋結果中的 AI Overviews,亞琛案涉及互動式 AI Mode。兩案的當事人、錯誤內容和程序也不同。
Q3: 只要生成摘要附上來源連結,平台就能避免責任嗎?
不能單憑連結得出這個結論。產品仍需檢查來源是否支持每項主張、摘要是否加入來源沒有的內容,以及收到錯誤申訴後能否覆核與更正。具體法律責任則依個案和適用法域判斷。
Q4: 台灣的產品團隊現在可以先檢查什麼?
可先抽查涉及人物、企業、刑事指控或其他高影響事實的生成答案,逐句核對來源與身分,並演練回報後的定位、人工覆核、暫停顯示和修正流程。這是風險管理起點,不代表德國判決已直接適用於台灣。
參考來源
- Landgericht München I(慕尼黑地方法院第一庭)(2026). *LG München I, Endurteil v. 28.05.2026 – 26 O 869/26 - Bürgerservice*. Bayern.Recht 官方裁判資料庫
- Landgericht Aachen(亞琛地方法院)(2026). *Beschluss vom 24.09.2026, 8 O 268/26*(裁判 PDF 副本). Institut für Informations-, Telekommunikations- und Medienrecht, Universität Münster (ITM NRW)
- Redaktion beck-aktuell (2026). *Chefarzt zum Sexualstraftäter erklärt: Google muss KI-Halluzination löschen | beck-aktuell*. beck-aktuell, 08.10.2026
- Matthias Bastian (2026). *Two German courts now hold Google liable for what its AI overviews say*. The Decoder, 18.10.2026


