
目錄(5 節)
Hugging Face 以 Google Scanned Objects(GSO,Google 掃描物件資料集)的 188 件鞋類資產,測試如何替 TRELLIS.2(文字或影像生成 3D 資產的模型)加入 LoRA(低秩適應,一種減少可訓練參數的微調方法)。預訓練模型生成的鞋底幾何不理想,團隊便聚焦鞋型與結構,調整相應模組。指南公開流程和留出測試結果,可供評估自有 3D 資產是否適合客製化。
這是 Hugging Face 在特定資料集、模型版本與 A100 環境下的實驗。評估產品流程可參考模型選型時如何檢查資料、成本與部署,並先確認輸出問題及資產是否能支援改善目標。
一、188 件鞋類資產如何成為 TRELLIS.2 微調案例
指南取用 GSO 的 188 件鞋類物件,轉為 TRELLIS.2 所需的 3D 潛在表示,並為每件物件渲染 16 個視角作為條件影像。團隊將其中 9 件留作測試,其餘 179 件用於訓練。
網格、潛在表示與條件影像須能正確配對;留出未見資產可檢查模型是否只記住訓練資料。指南記錄 188 件前處理約用一小時 A100。
GLB、OBJ 是檔案格式,不代表資產可任意商用。訓練前須確認來源授權、網格完整度、尺度朝向與貼圖資訊。
二、LoRA 要加在哪個生成環節,先看問題在哪裡
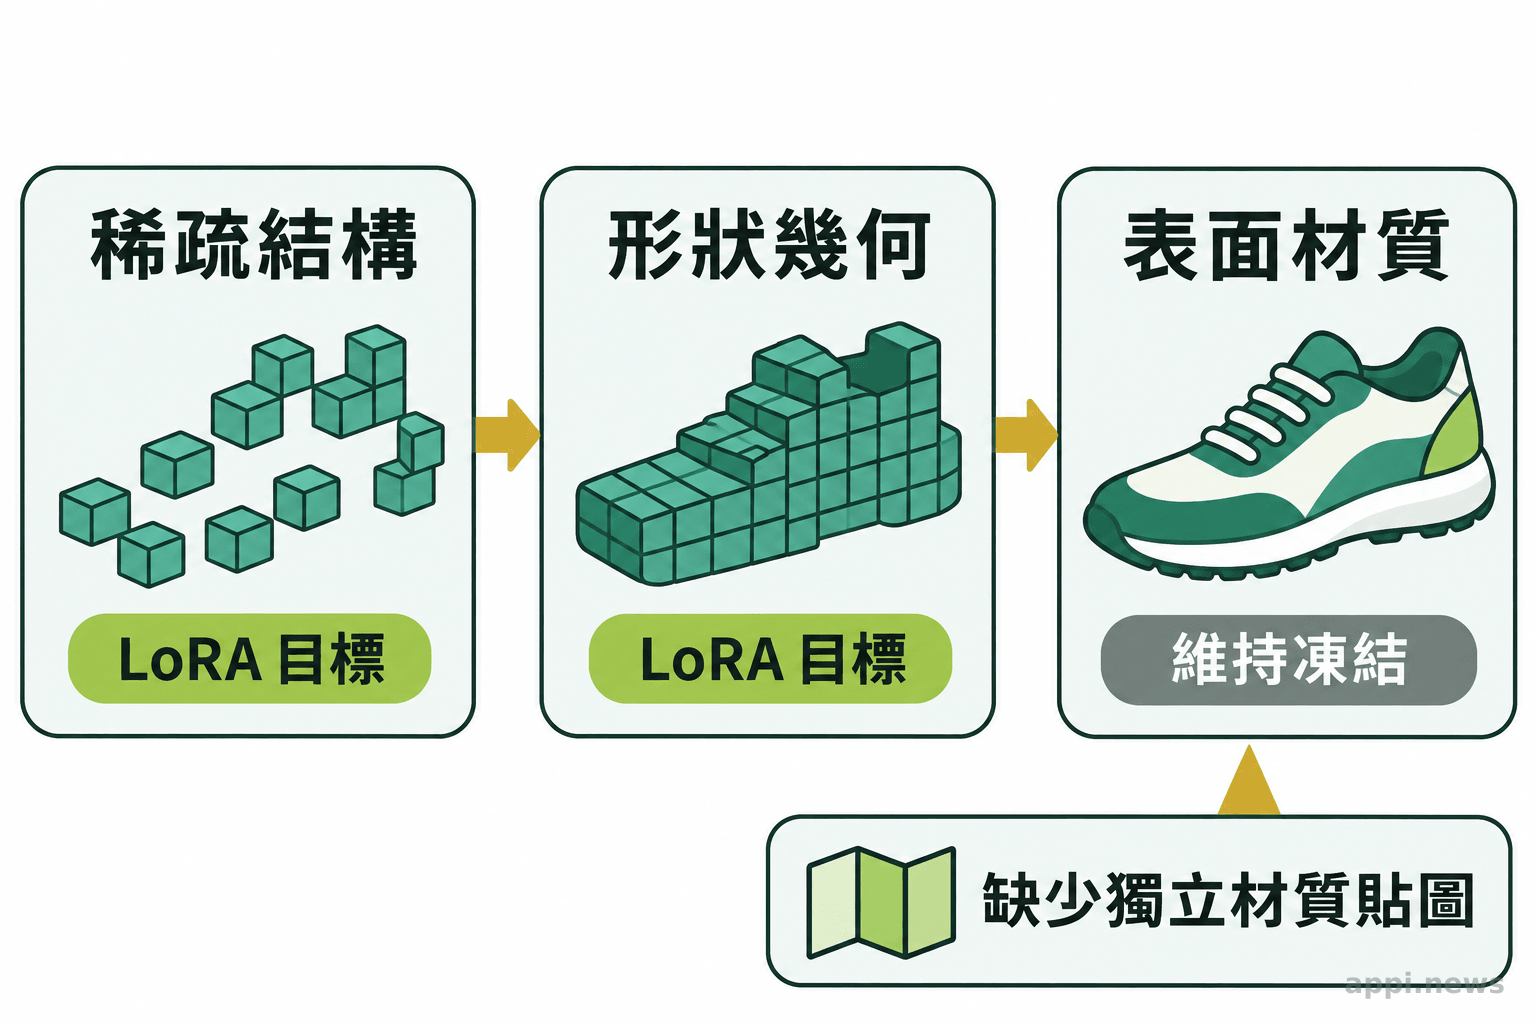
Hugging Face 把 LoRA 加到稀疏結構與形狀生成兩個 DiT(擴散轉換器)階段,凍結材質生成階段。這項選擇是因為目標在鞋底幾何,而資料中的漫反射色圖混有烘焙光影,缺少獨立材質圖,並不適合作為材質模型的訓練目標。
模型依序生成粗略結構、幾何與材質;混有光影的色圖若作為材質標籤,模型可能把光線學成表面特性。
Hugging Face 在指南中提醒:「Choosing what to freeze matters as much as choosing what to fine-tune.」套用到鞋類實驗,凍結材質階段是因為任務目標與現有材質資料都不支持調整它。
NVIDIA 團隊處理 DUSt3R 在視角重疊有限或光線不足場景的泛化問題,以稀疏 RGB 影像做場景自校準,透過多視角預測產生偽標籤,再用 LoRA 微調。Replica、TUM、Waymo Open 的 160 多個場景測試中,重建、姿態估計及新視角渲染的單項最佳提升達 88%;這不是每項任務的共同幅度,也不能預測 TRELLIS.2 鞋類生成結果。
可按輸出故障定位:整體範圍不對,檢視粗結構;表面幾何不準,再看形狀;顏色或粗糙度有問題,檢查材質資料。
三、3D 資產怎麼整理成可訓練資料
資料須包含可讀且有權使用的網格、模型所需潛在表示、多視角影像及留出測試集。
先抽樣跑完整管線,檢查破面、貼圖、軸向、尺寸、重複資產及影像是否呈現目標。重複或錯誤標記的資產不會增加有效資訊。
留出測試應以資產為單位,避免同一物件的不同視角分散到訓練和測試。指南留 9 件測試,並非固定比例;樣本少時結果容易受個別物件影響。
資料清單保留來源、授權、版本、錯誤紀錄與分組,方便追查差異及重現錯誤。
四、LoRA 設定與算力怎麼估
rank(秩)影響參數量與表達容量,target modules(目標模組)決定適配器加入哪些層,步數影響更新量;三者依模型、資料與目標調整。
指南在稀疏結構階段用 rank 8(注意力與前饋層),形狀階段用 rank 16(注意力層),合計約 930 萬個適配器參數。PEFT 文件說明,rank 越高,參數量與容量通常越大,實際數量仍取決於目標層和權重矩陣。這些是指南配置,不是預設答案。
My3DGen 團隊發現預訓練 EG3D 難以捕捉個人臉部特徵,於是用約 50 張自拍照為個人化模型微調。相較每人需訓練 3,100 萬參數的全量微調,LoRA rank 1 約 20 萬、rank 4 約 90 萬參數;研究以不同姿勢下的重建與插值評估身分保留。rank 從 1 增至 16 沒改善單張影像反演的 ID_sim(身分相似度),但背景 LPIPS(感知影像差異指標)改善,插值 ID_sim 略升。這是人臉任務,不能據此設定 3D 物件生成的 rank。
實驗記錄目標層、rank、步數和資料版本,固定留出資產比較,避免難以歸因。
PEFT 文件指出,LoRA 以低秩矩陣調整預訓練權重、減少需微調的參數;模組、資料和驗收指標仍須自行選定。
指南以 80GB A100 分開訓練,稀疏結構 7.2 小時、形狀 3.6 小時,各約 3,000 步;此紀錄不含資料整理、測試與介接成本。
重跑前確認相依套件、容器、模型存取權及 GPU 記憶體;先用少量資產跑通轉換到匯入流程,並把重跑和人工檢查納入成本。
五、怎麼判斷微調結果能否接進現有流程
先用未參與訓練的資產比較基礎模型與微調版本,再以任務相關指標、人工檢查和流程介接測試共同判斷。訓練 loss(損失值)描述訓練目標的變化,不能單獨證明生成品質改善。
9 件留出鞋類的比較中,兩種適配器合用時,平均 F-score 由 0.276 升至 0.803,Chamfer distance(倒角距離)由 0.174 降至 0.033,法線一致性由 0.530 升至 0.804。結果支持這組測試的幾何改善,不能代表其他類別或流程。
確認模型、資料集與權重授權,並測試 GLB 能否由既有系統讀取。單張照片重建 Blender 場景也涉及工具鏈整合。
指標配合用途:外觀參考可盲測;供模擬或製造則檢查網格、修補工時與匯入率。
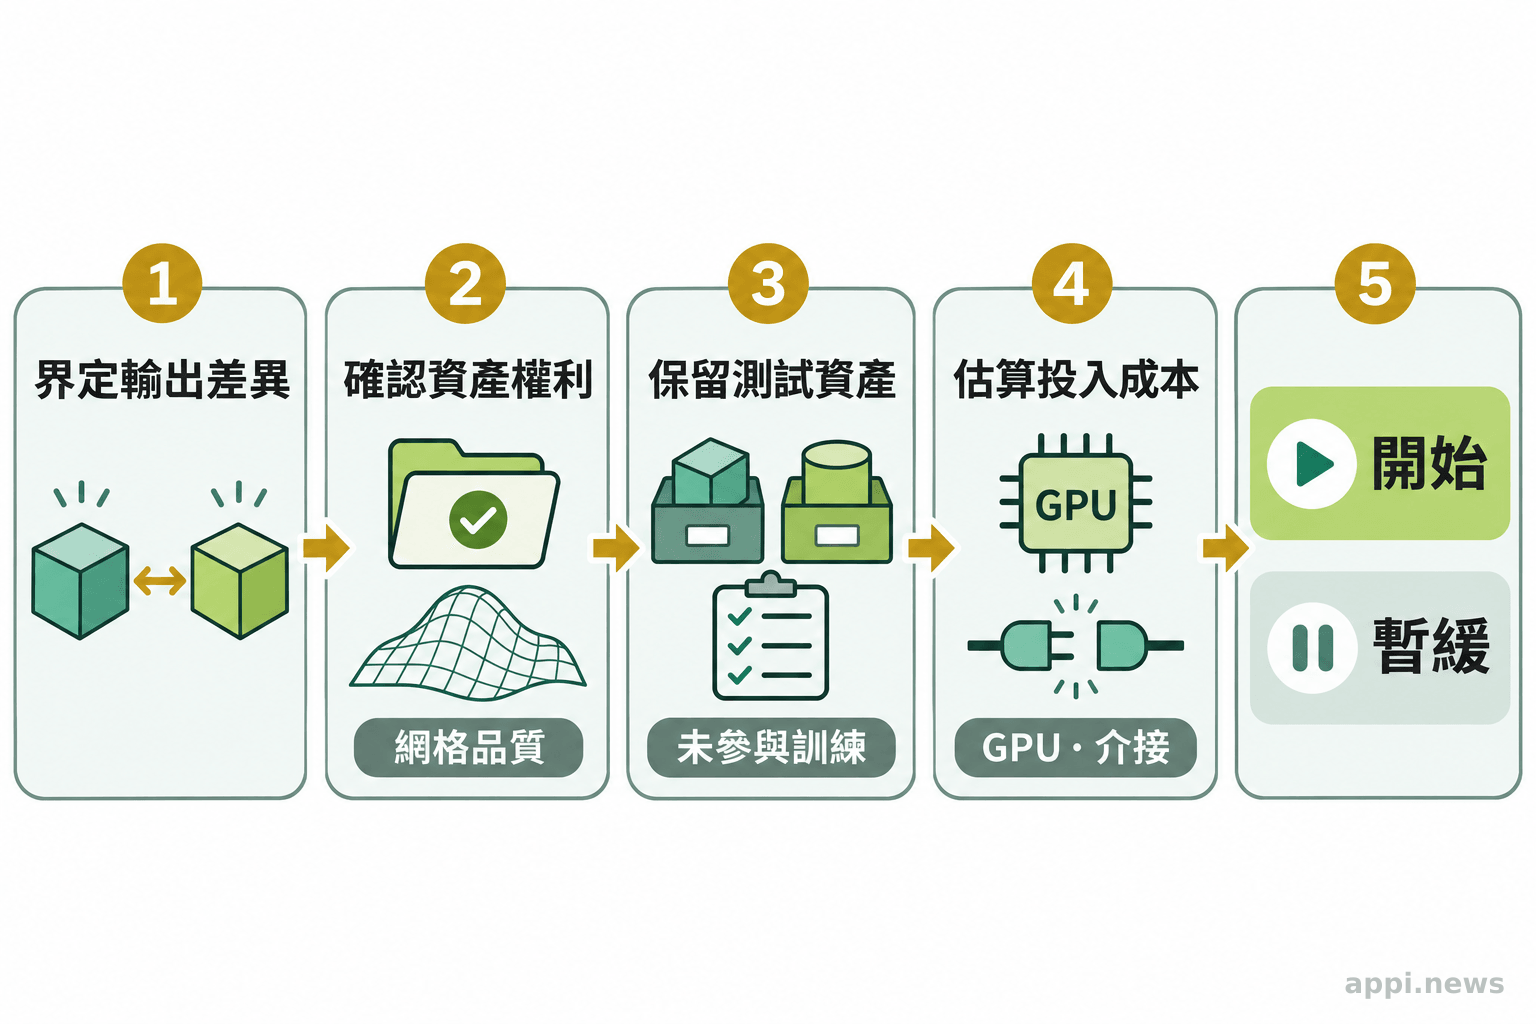
開始訓練前先檢查:
- 定義輸出差異與測試指標。
- 抽查資產授權、網格、貼圖及前處理結果。
- 依問題選模組,確認資料能描述該目標。
- 留出測試資產,對照基礎模型與微調輸出。
- 合計 GPU、轉換、儲存、重跑、介接和維護成本。
條件未備齊時,先完成資料盤點與評估設計,再按目標、資產權利、算力及介接條件決定是否微調。
- 先定位生成流程中的錯誤,再選擇 LoRA 目標模組。
- 資產權利、資料品質與留出測試會影響評估結果。
- rank、資料量和 GPU 時間須依模型與任務重新評估。
常見問題
Q1:3D 生成模型微調一定要有很多資產嗎?
沒有通用門檻,保留未見資產測試並檢查資產品質。
Q2:LoRA rank 越高,生成品質就越好嗎?
不一定,My3DGen 顯示不同任務指標變化不一,須依需求實測。
Q3:訓練 loss 下降,代表模型已經變好嗎?
不能單憑 loss 判斷,還要比較留出資產與流程需求。
Q4:TRELLIS.2 的鞋類設定可以套用到其他 3D 模型嗎?
不可直接套用,模型、資料格式、模組與硬體需求都可能不同。
參考來源
- Hugging Face. (2026). The Definitive Fine-Tuning Guide for 3D Generation Models
- Lu Z, et al. (2025). LoRA3D: Low-Rank Self-Calibration of 3D Geometric Foundation Models. ICLR 2025
- Qi C, et al. (2025). My3DGen: A Scalable Personalized 3D Generative Model. WACV 2025
- Hugging Face. (n.d.). LoRA · PEFT documentation


